从训练,到可用的 CLI
跟着画面走一遍:准备材料 → 把 GPT 接上训练 → 保存与恢复 → 评估 → 编写并使用命令行。本页把整个过程连起来。遇到不理解的计算,可以进入对应课程,改动图中的输入,并在右侧运行 Python 实验。
先把图解与真实运行接起来
左侧可以改教学例子,右侧运行本机 Python。改图中的句子并不会自动改写源代码:先观察同一条接字规则,再运行课文的固定示例。
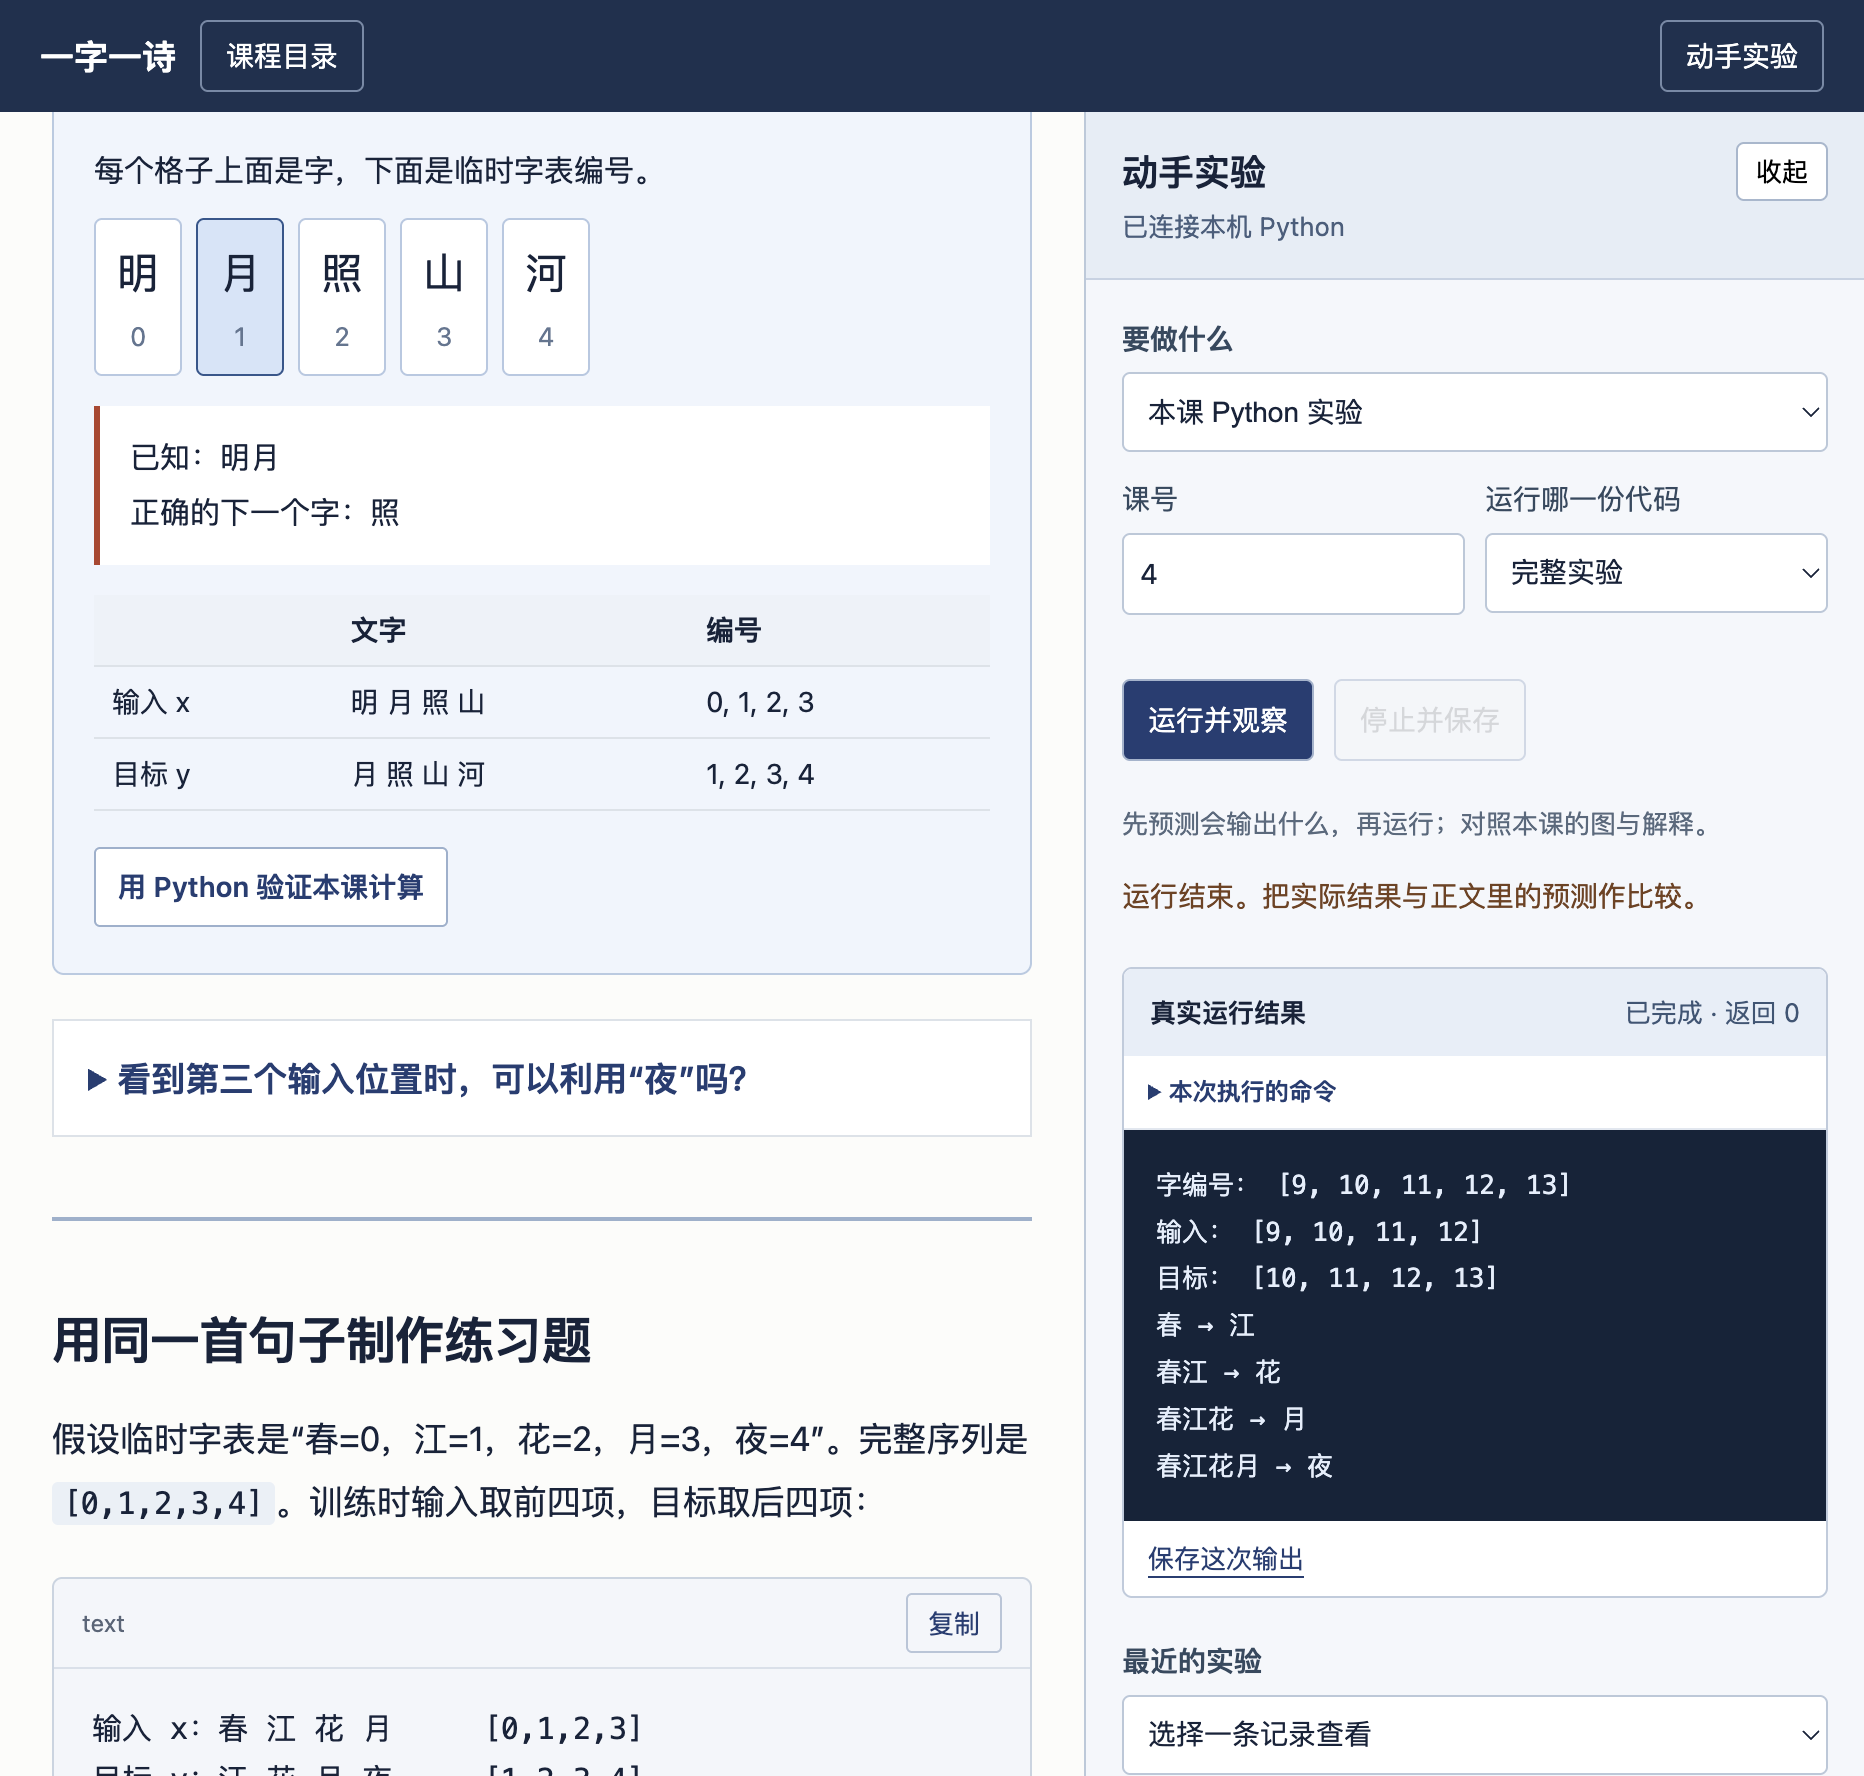
对照输入与目标,而不是背编号
- 先看哪里
- 先看左侧输入 x 和目标 y,目标向后错开了一位;再看右侧 Python 输出。
- 这说明什么
- 左侧换成了“明月照山河”,右侧运行的是课文固定例子“春江花月夜”。句子和字表编号可以不同,制作接字题的规则相同。
- 你接着做
- 先改图中的句子,写下你预测的输入与目标;再运行课文示例,对照同一条规则。
在注意力课中,先看哪些位置被遮住,再观察真实模型算出的权重。
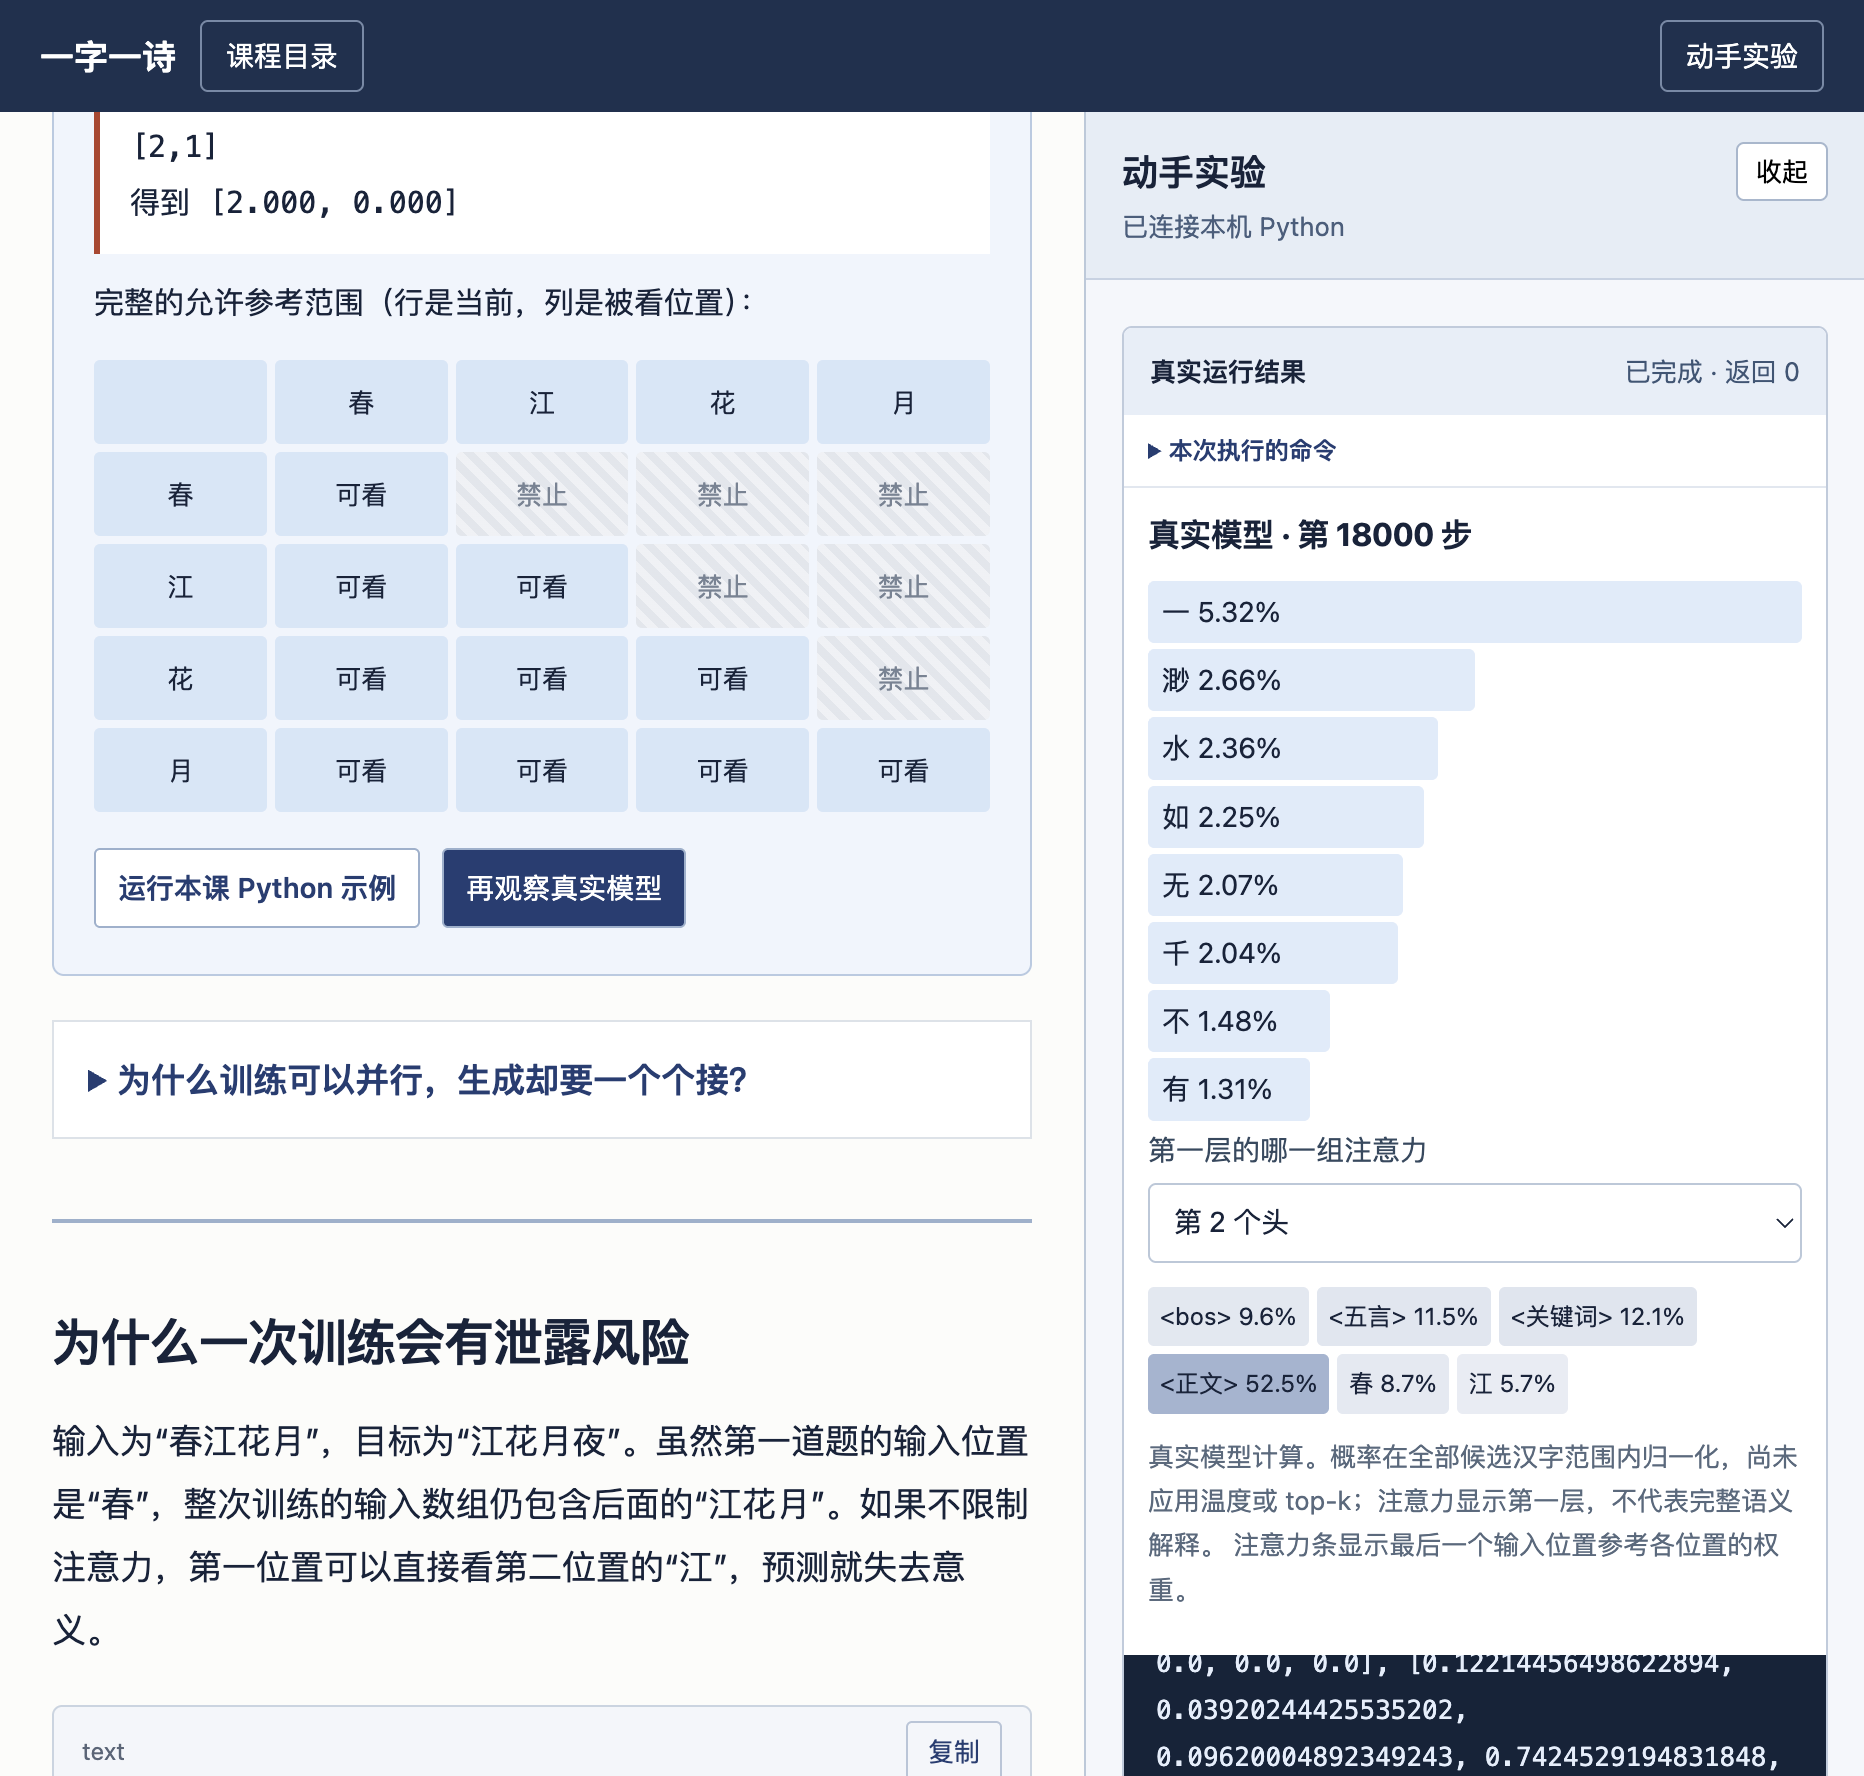
把允许参考的范围,与真实权重分开看
- 先看哪里
- 左侧三角表说明哪些位置可以被参考;右侧是正式模型对“春江”的下一字概率,以及第一层第 2 个头的实际权重。
- 这说明什么
- 左侧给出规则,右侧显示模型学出的数字。第一层最后一个位置对“正文”标记的权重约为 52.5%,只说明这一次汇总的比例,不能直接解释整首诗的含义。
- 你接着做
- 在右侧换一个前文并重新运行,再切换注意力头。先比较权重变化,再思考为什么单个头不足以代表整个模型。
先知道这些图来自哪里
| 标记 | 图的来源 | 能说明什么 |
|---|---|---|
| 本次复现命令 | 本机实际执行后的原样输出,在阅读页中截图 | 命令确实执行,结果可复查 |
| 正式训练存档 | 读取先前 18000 步训练日志和评估报告后截图 | 正式模型训练的过程与结果;不是当时的终端照片 |
| 当前源码阅读 | 对项目现有代码节选截图,保留行号与原文件 | 这段程序如何实现;不是编辑器敲代码的录像 |
| 教学流程示意图 / 按真实日志绘图 | 流程图和由完整验证记录绘制的曲线 | 帮你连接步骤;与截图明确区分 |
这次另外完成了一次 50 → 75 步的演示训练,使用约 145 万参数的小模型。正式写诗仍使用原来约 488 万参数、18000 步的模型。每个运行目录单独保留,输出未手动修饰。
① 准备好材料,认清模型入口
先确认 Python 和计算设备,再检查整理结果,最后跟踪一个汉字如何变成接字题。详细步骤分别在第 1 课、第 3 课、第 4 课。
./poet doctor
.venv/bin/python lessons/03/inspect_material.py
./poet lesson 4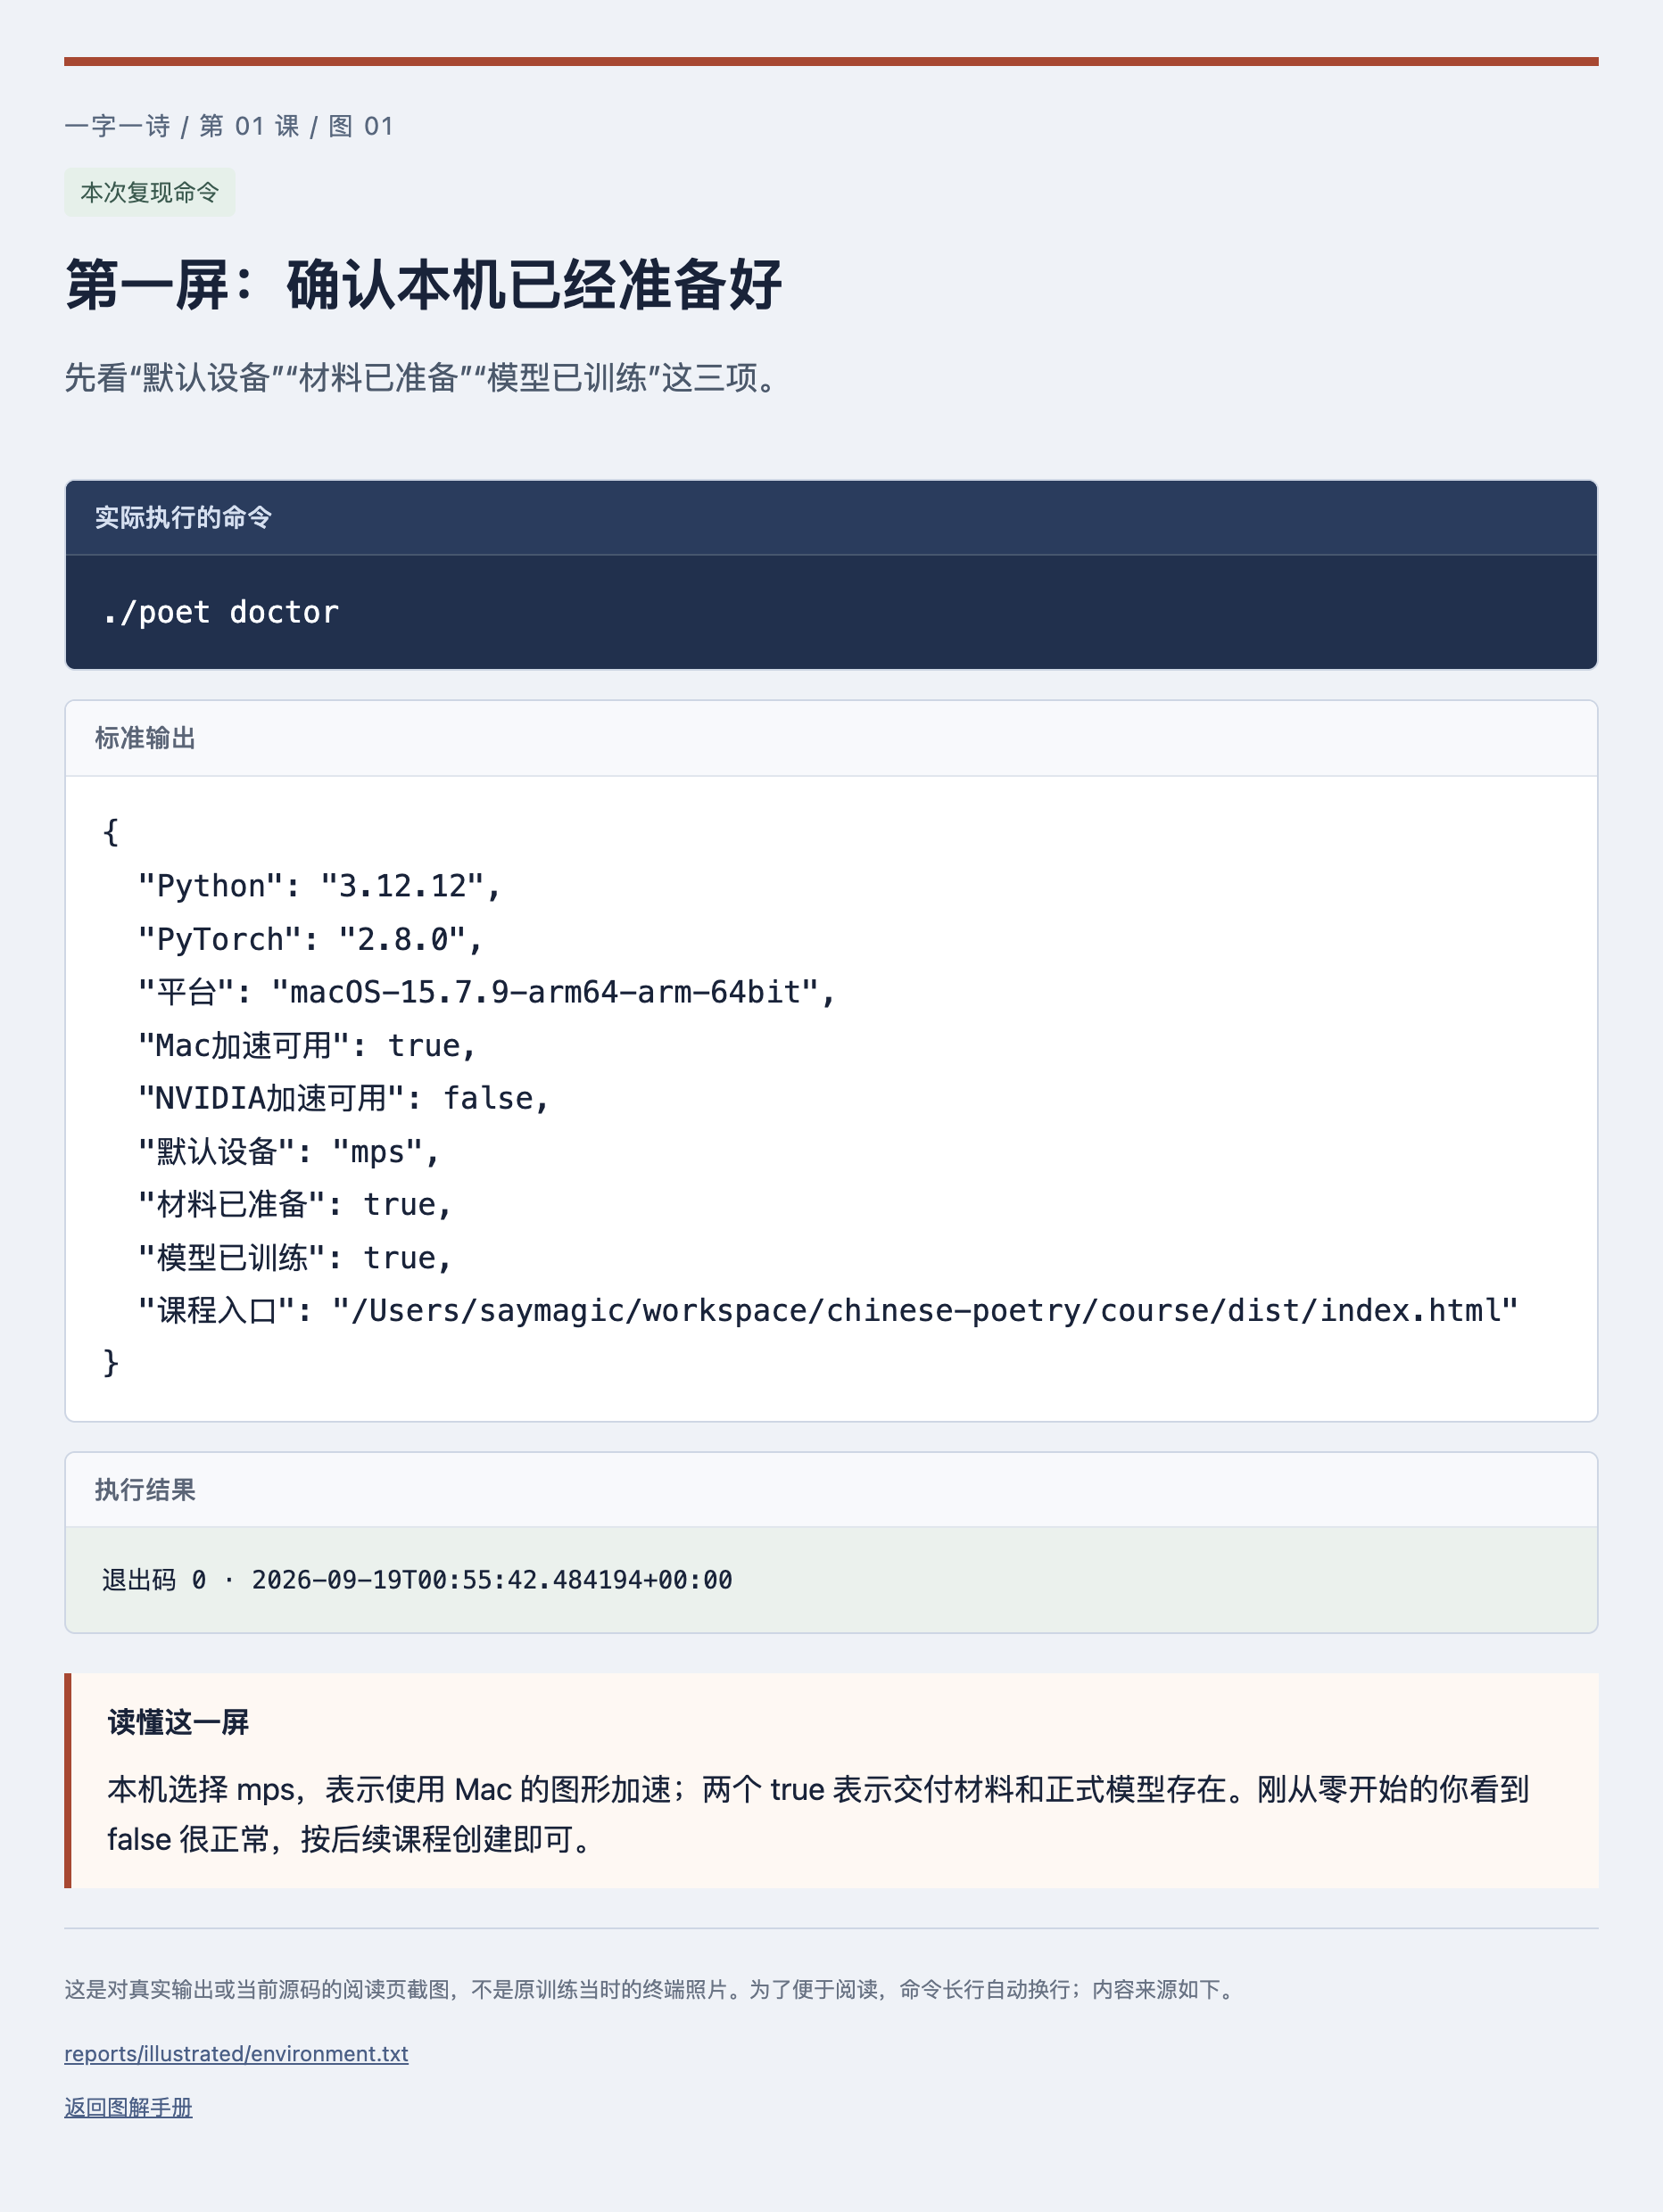
第一屏:确认本机已经准备好
- 先看哪里
- 先看“默认设备”“材料已准备”“模型已训练”这三项。
- 这说明什么
- 本机选择 mps,表示使用 Mac 的图形加速;两个 true 表示交付材料和正式模型存在。刚从零开始的你看到 false 很正常,按后续课程创建即可。
- 你接着做
- 运行 ./poet doctor。Python 能启动以后,再检查材料和模型;换机器时版本或设备名可能不同。
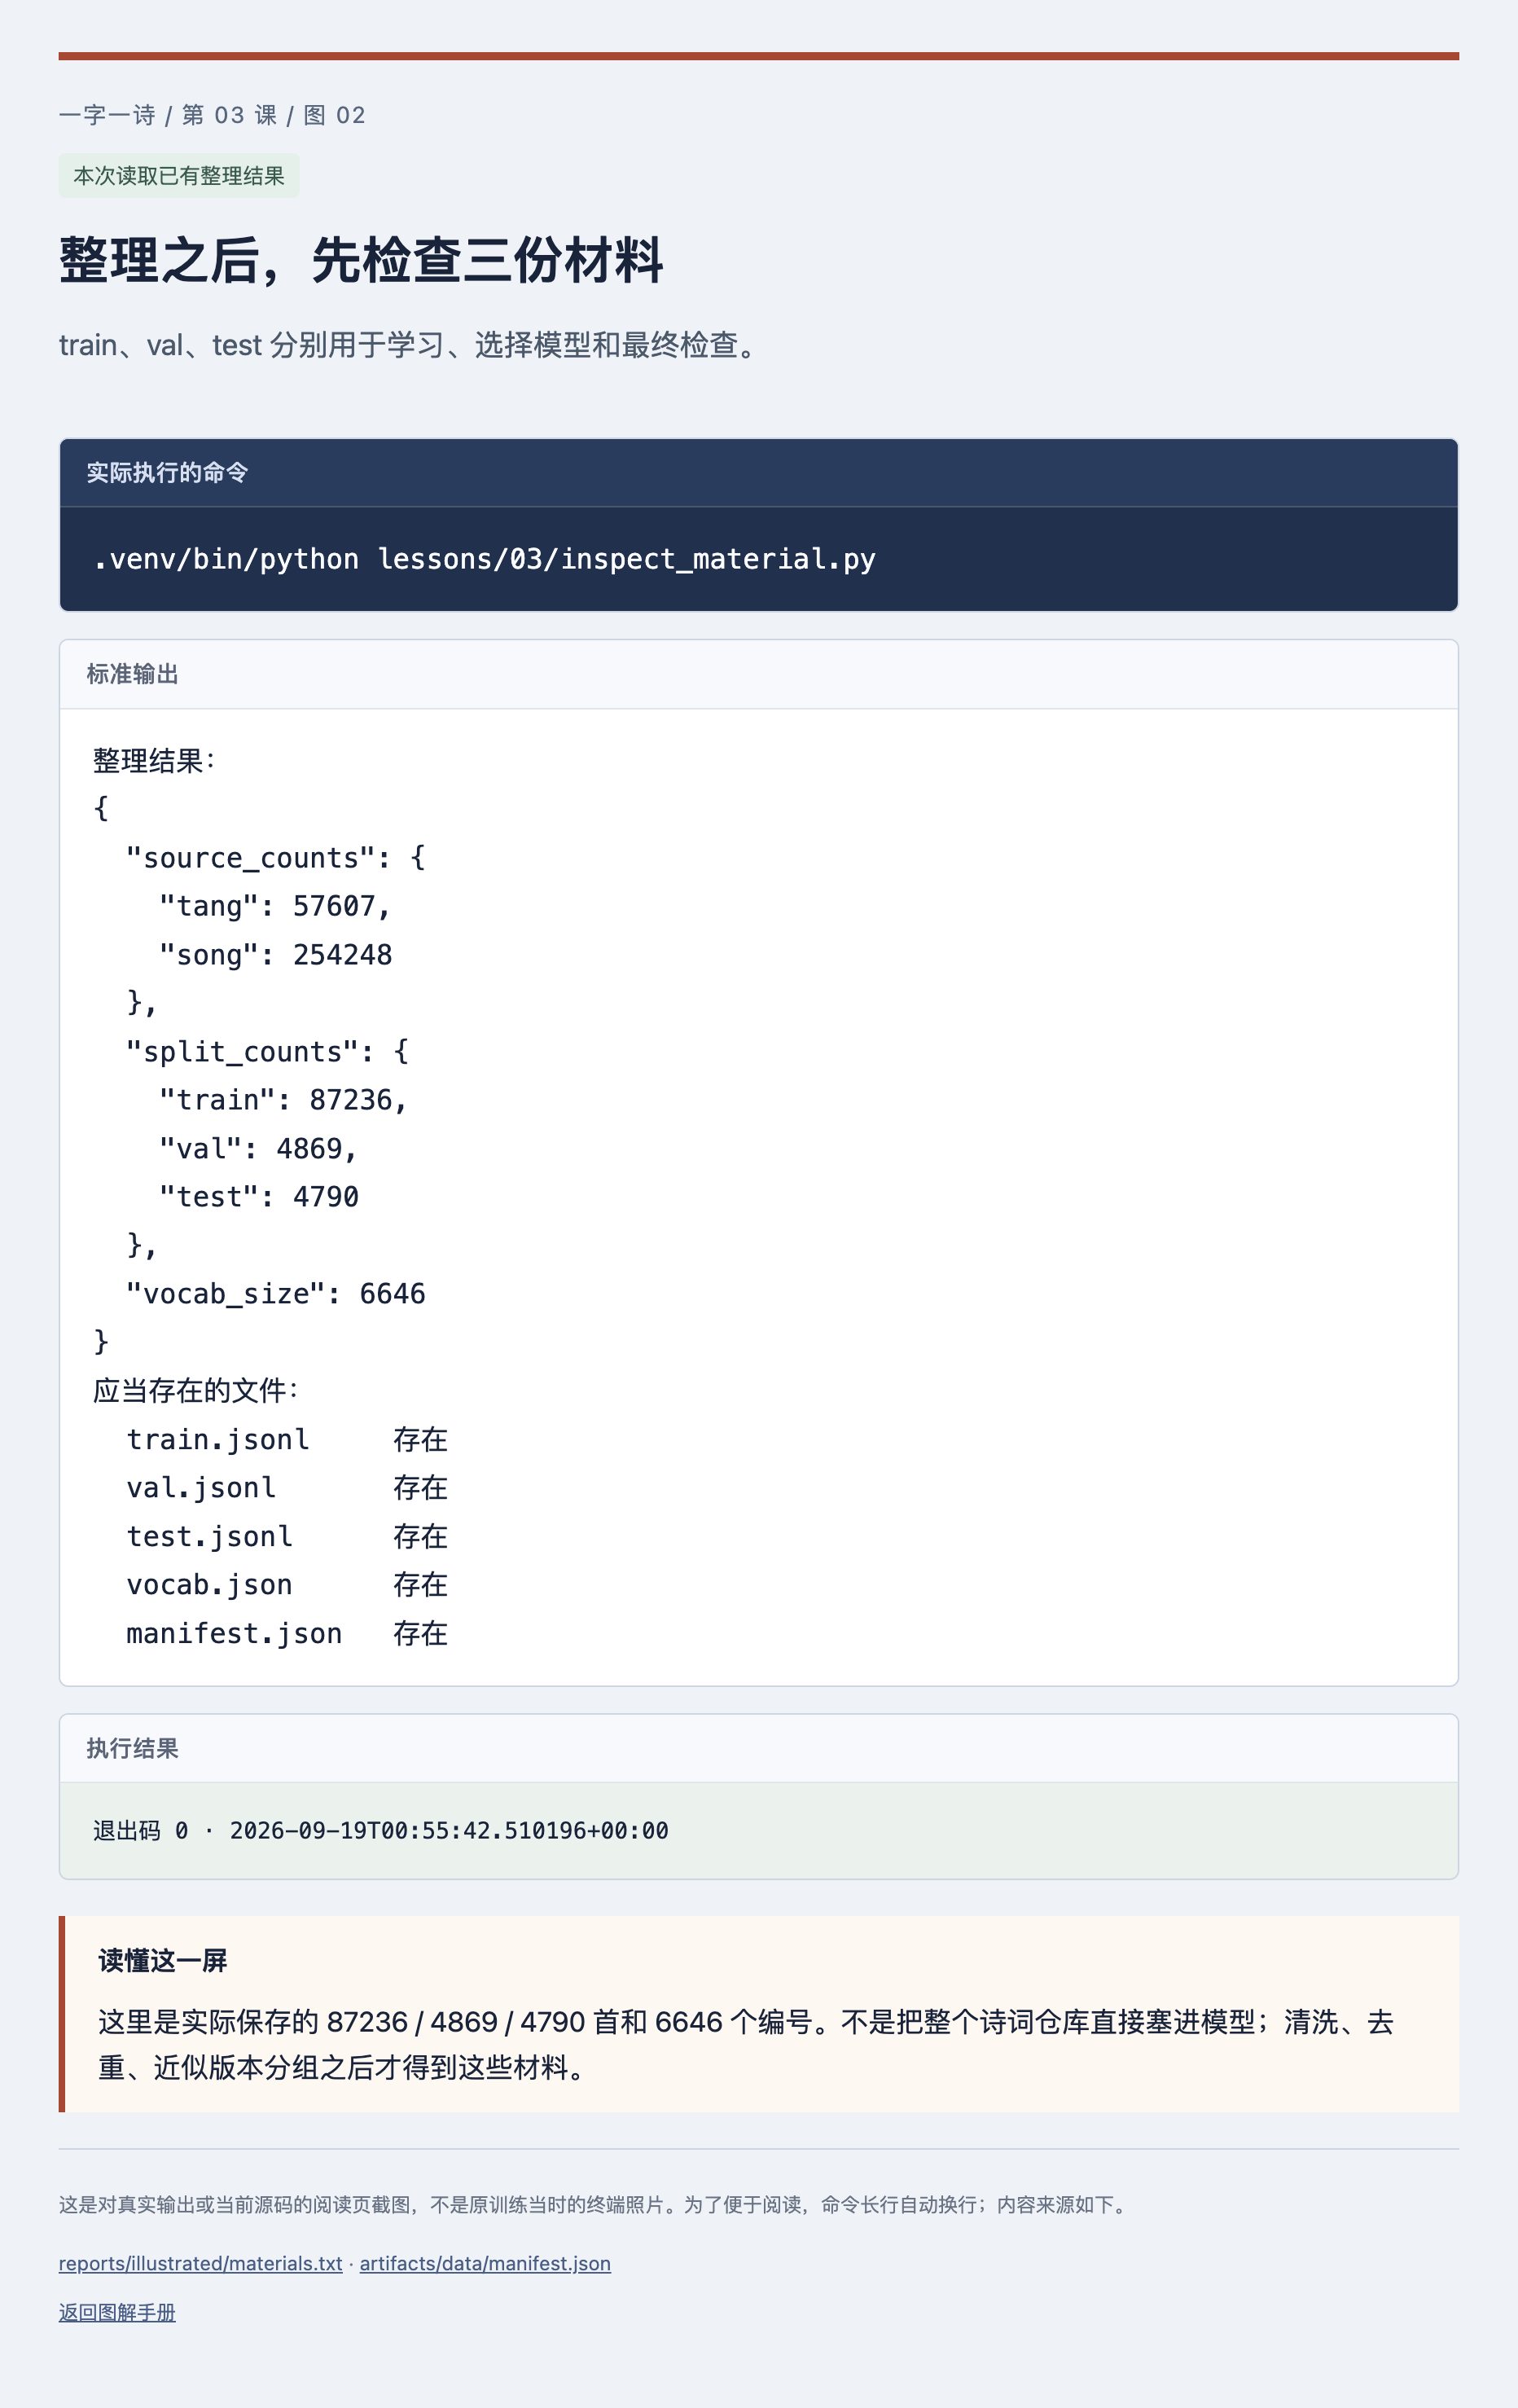
整理之后,先检查三份材料
- 先看哪里
- train、val、test 分别用于学习、选择模型和最终检查。
- 这说明什么
- 这里是实际保存的 87236 / 4869 / 4790 首和 6646 个编号。不是把整个诗词仓库直接塞进模型;清洗、去重、近似版本分组之后才得到这些材料。
- 你接着做
- 运行 lessons/03/inspect_material.py 对照五个文件。想重做 prepare 时选新目录,保留原材料。
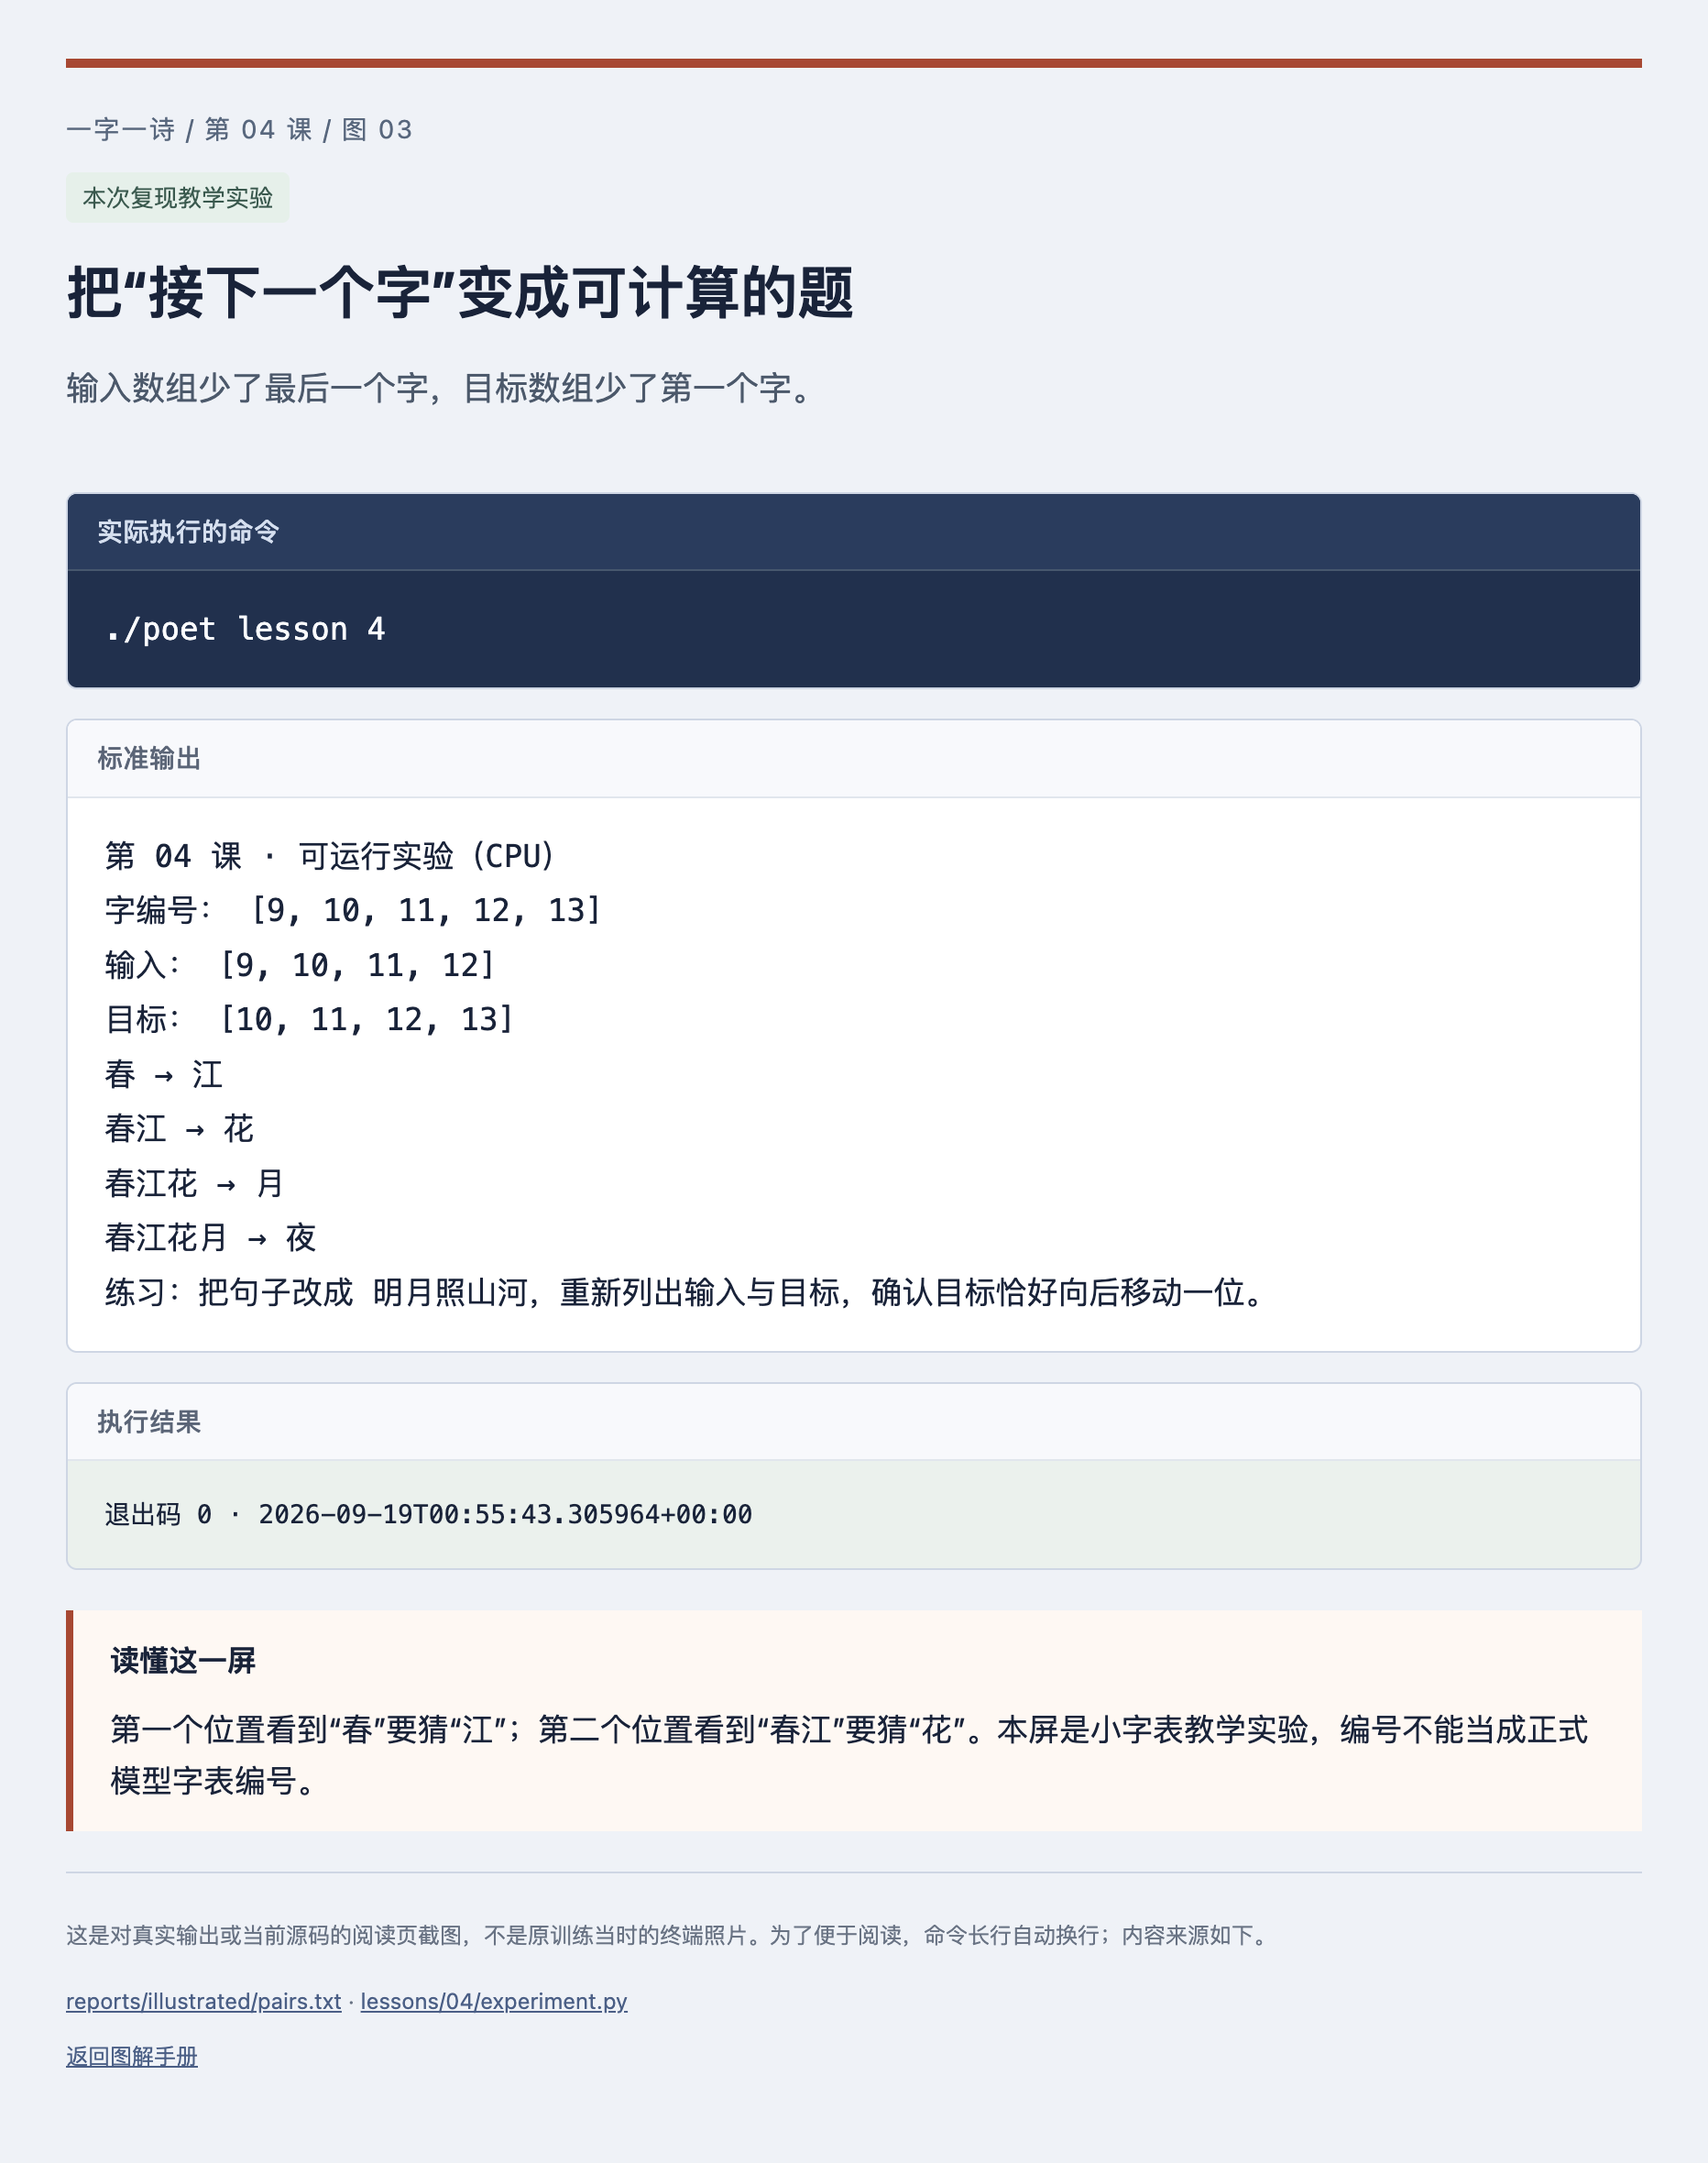
把“接下一个字”变成可计算的题
- 先看哪里
- 输入数组少了最后一个字,目标数组少了第一个字。
- 这说明什么
- 第一个位置看到“春”要猜“江”;第二个位置看到“春江”要猜“花”。本屏是小字表教学实验,编号不能当成正式模型字表编号。
- 你接着做
- 把实验复制为自己的文件,换一句五字诗,检查输入与目标仍相差一位。
来到第 15 课时,不用把 GPT 当成一团不可见的代码。下一张图的每一步,都在第 8—14 课拆开讲过。
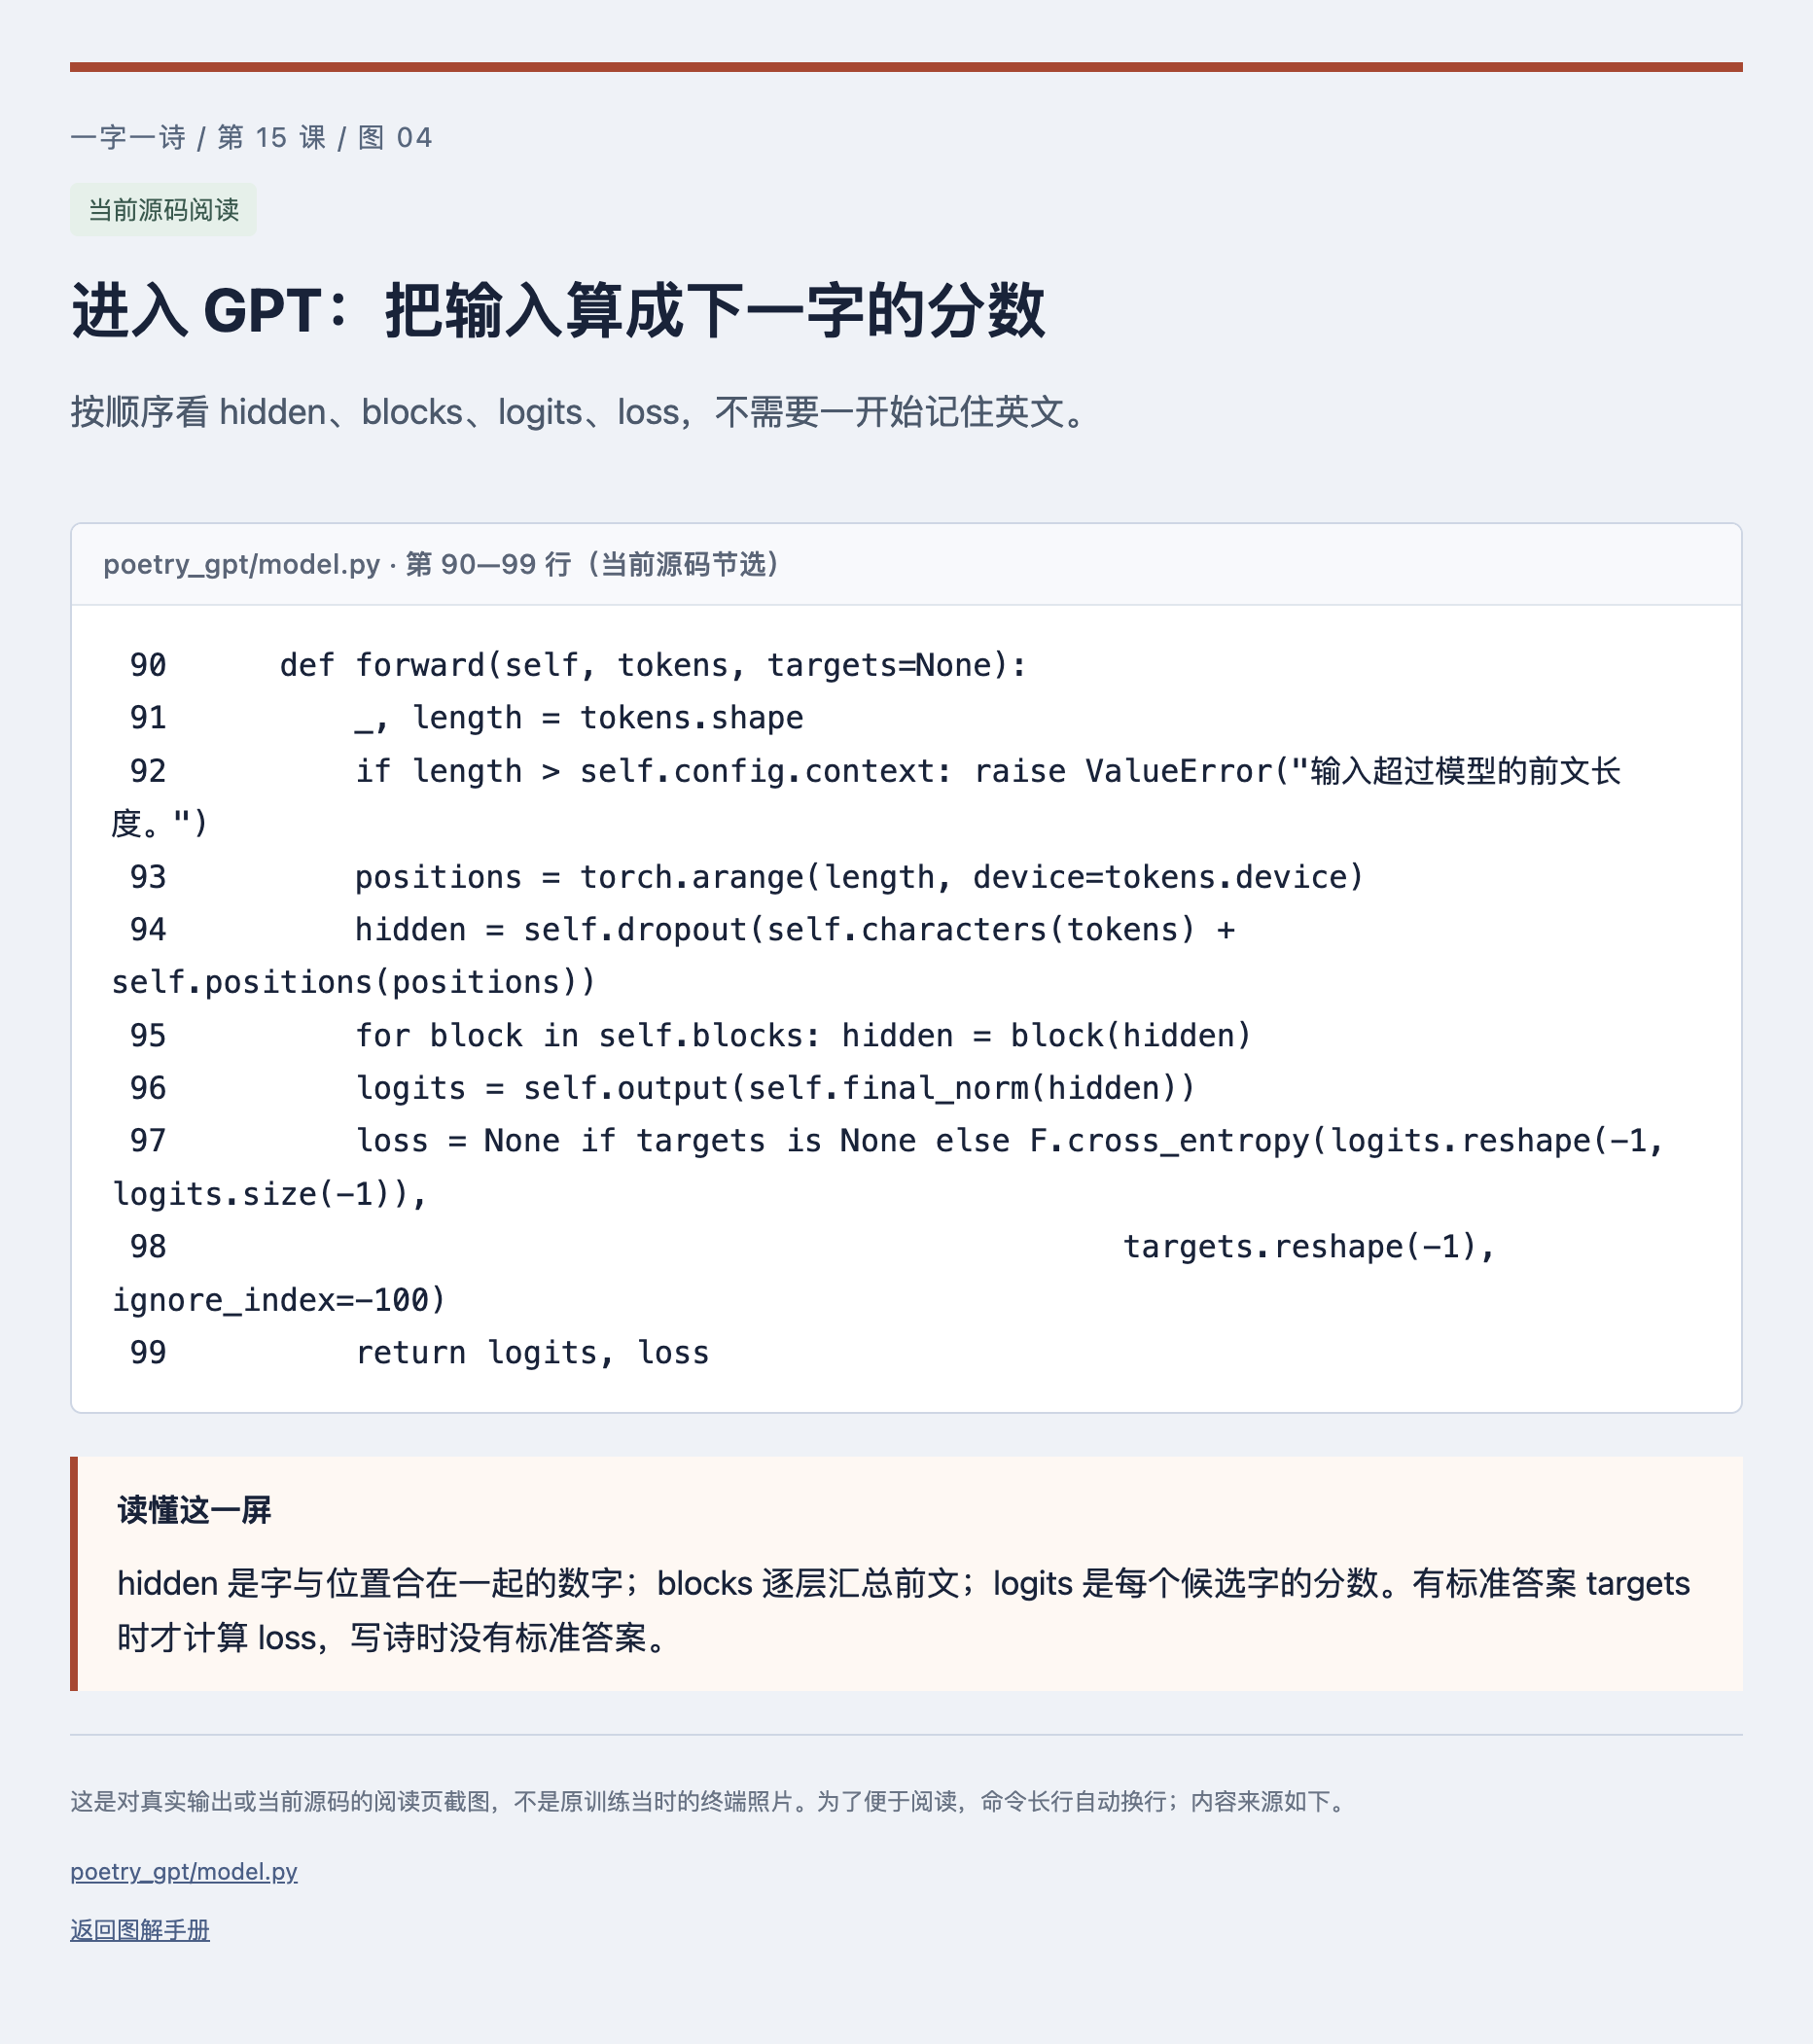
进入 GPT:把输入算成下一字的分数
- 先看哪里
- 按顺序看 hidden、blocks、logits、loss,不需要一开始记住英文。
- 这说明什么
- hidden 是字与位置合在一起的数字;blocks 逐层汇总前文;logits 是每个候选字的分数。有标准答案 targets 时才计算 loss,写诗时没有标准答案。
- 你接着做
- 回到第 8—14 课逐个对应这些部件,再运行第 15 课实验查看尺寸。
② 开始训练,检查进度,再接着练
先看流程图,再把每个动作对应到实际代码。训练就是反复预测下一个字、看答案、调整参数;反复走完一次就是一步。
一张图看懂一次训练更新
- 先看哪里
- 先从左上角读到右上角,再沿红线走到左下角。
- 这说明什么
- 模型要反复经历预测、对照答案、更新参数;网页里的阅读本身不会训练模型。
- 你接着做
- 把每一格对应到下一张训练循环源码截图。
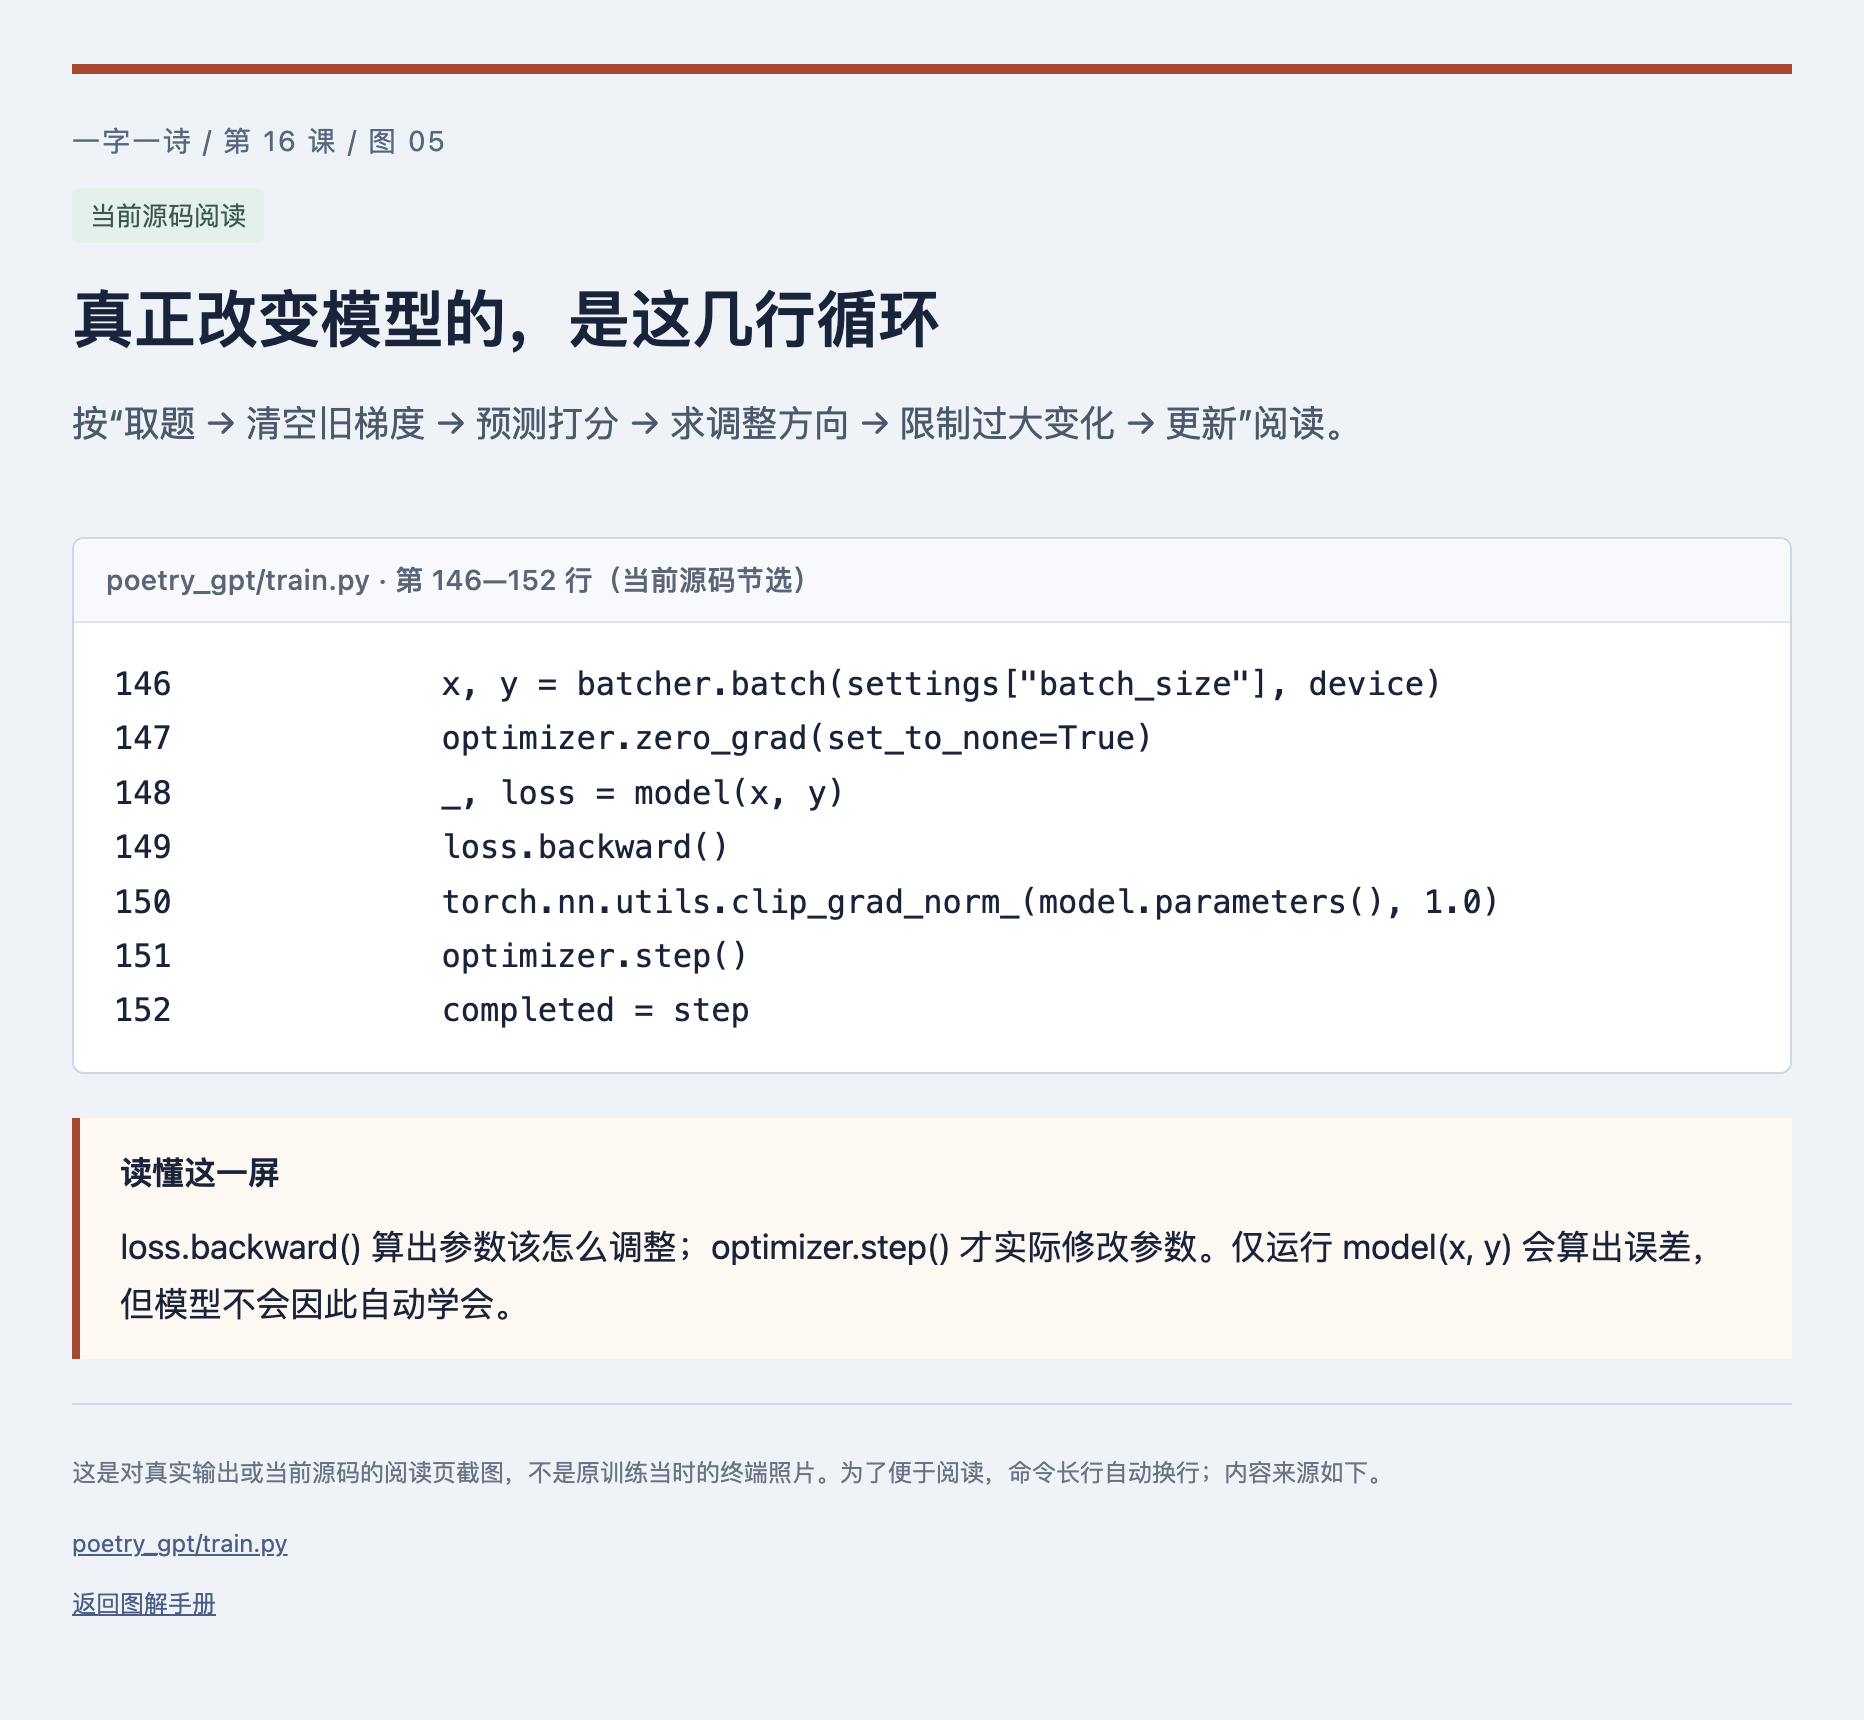
真正改变模型的,是这几行循环
- 先看哪里
- 按“取题 → 清空旧梯度 → 预测打分 → 求调整方向 → 限制过大变化 → 更新”阅读。
- 这说明什么
- loss.backward() 算出参数该怎么调整;optimizer.step() 才实际修改参数。仅运行 model(x, y) 会算出误差,但模型不会因此自动学会。
- 你接着做
- 运行 ./poet lesson 16,观察同一道小题的误差是否下降,再启动诗词短跑。
下面两条命令适合亲手操作。请选择尚不存在的目录;图里的 illustrated-demo 已有本次进度,因此这里使用 my-visual-run。全部命令都在项目根目录执行。
./poet train --config configs/tiny.json --run-dir artifacts/runs/my-visual-run --steps 50 --batch-size 24 --device auto
./poet train --run-dir artifacts/runs/my-visual-run --resume artifacts/runs/my-visual-run/latest.pt --steps 75 --device auto本机 auto 会选择 mps,图中直接写出了 mps。若你的设备选中 CPU,运行速度和末尾小数可能不同;先核对开始步数、目标步数和保存结果。逐项解释在第 16 课和第 18 课。
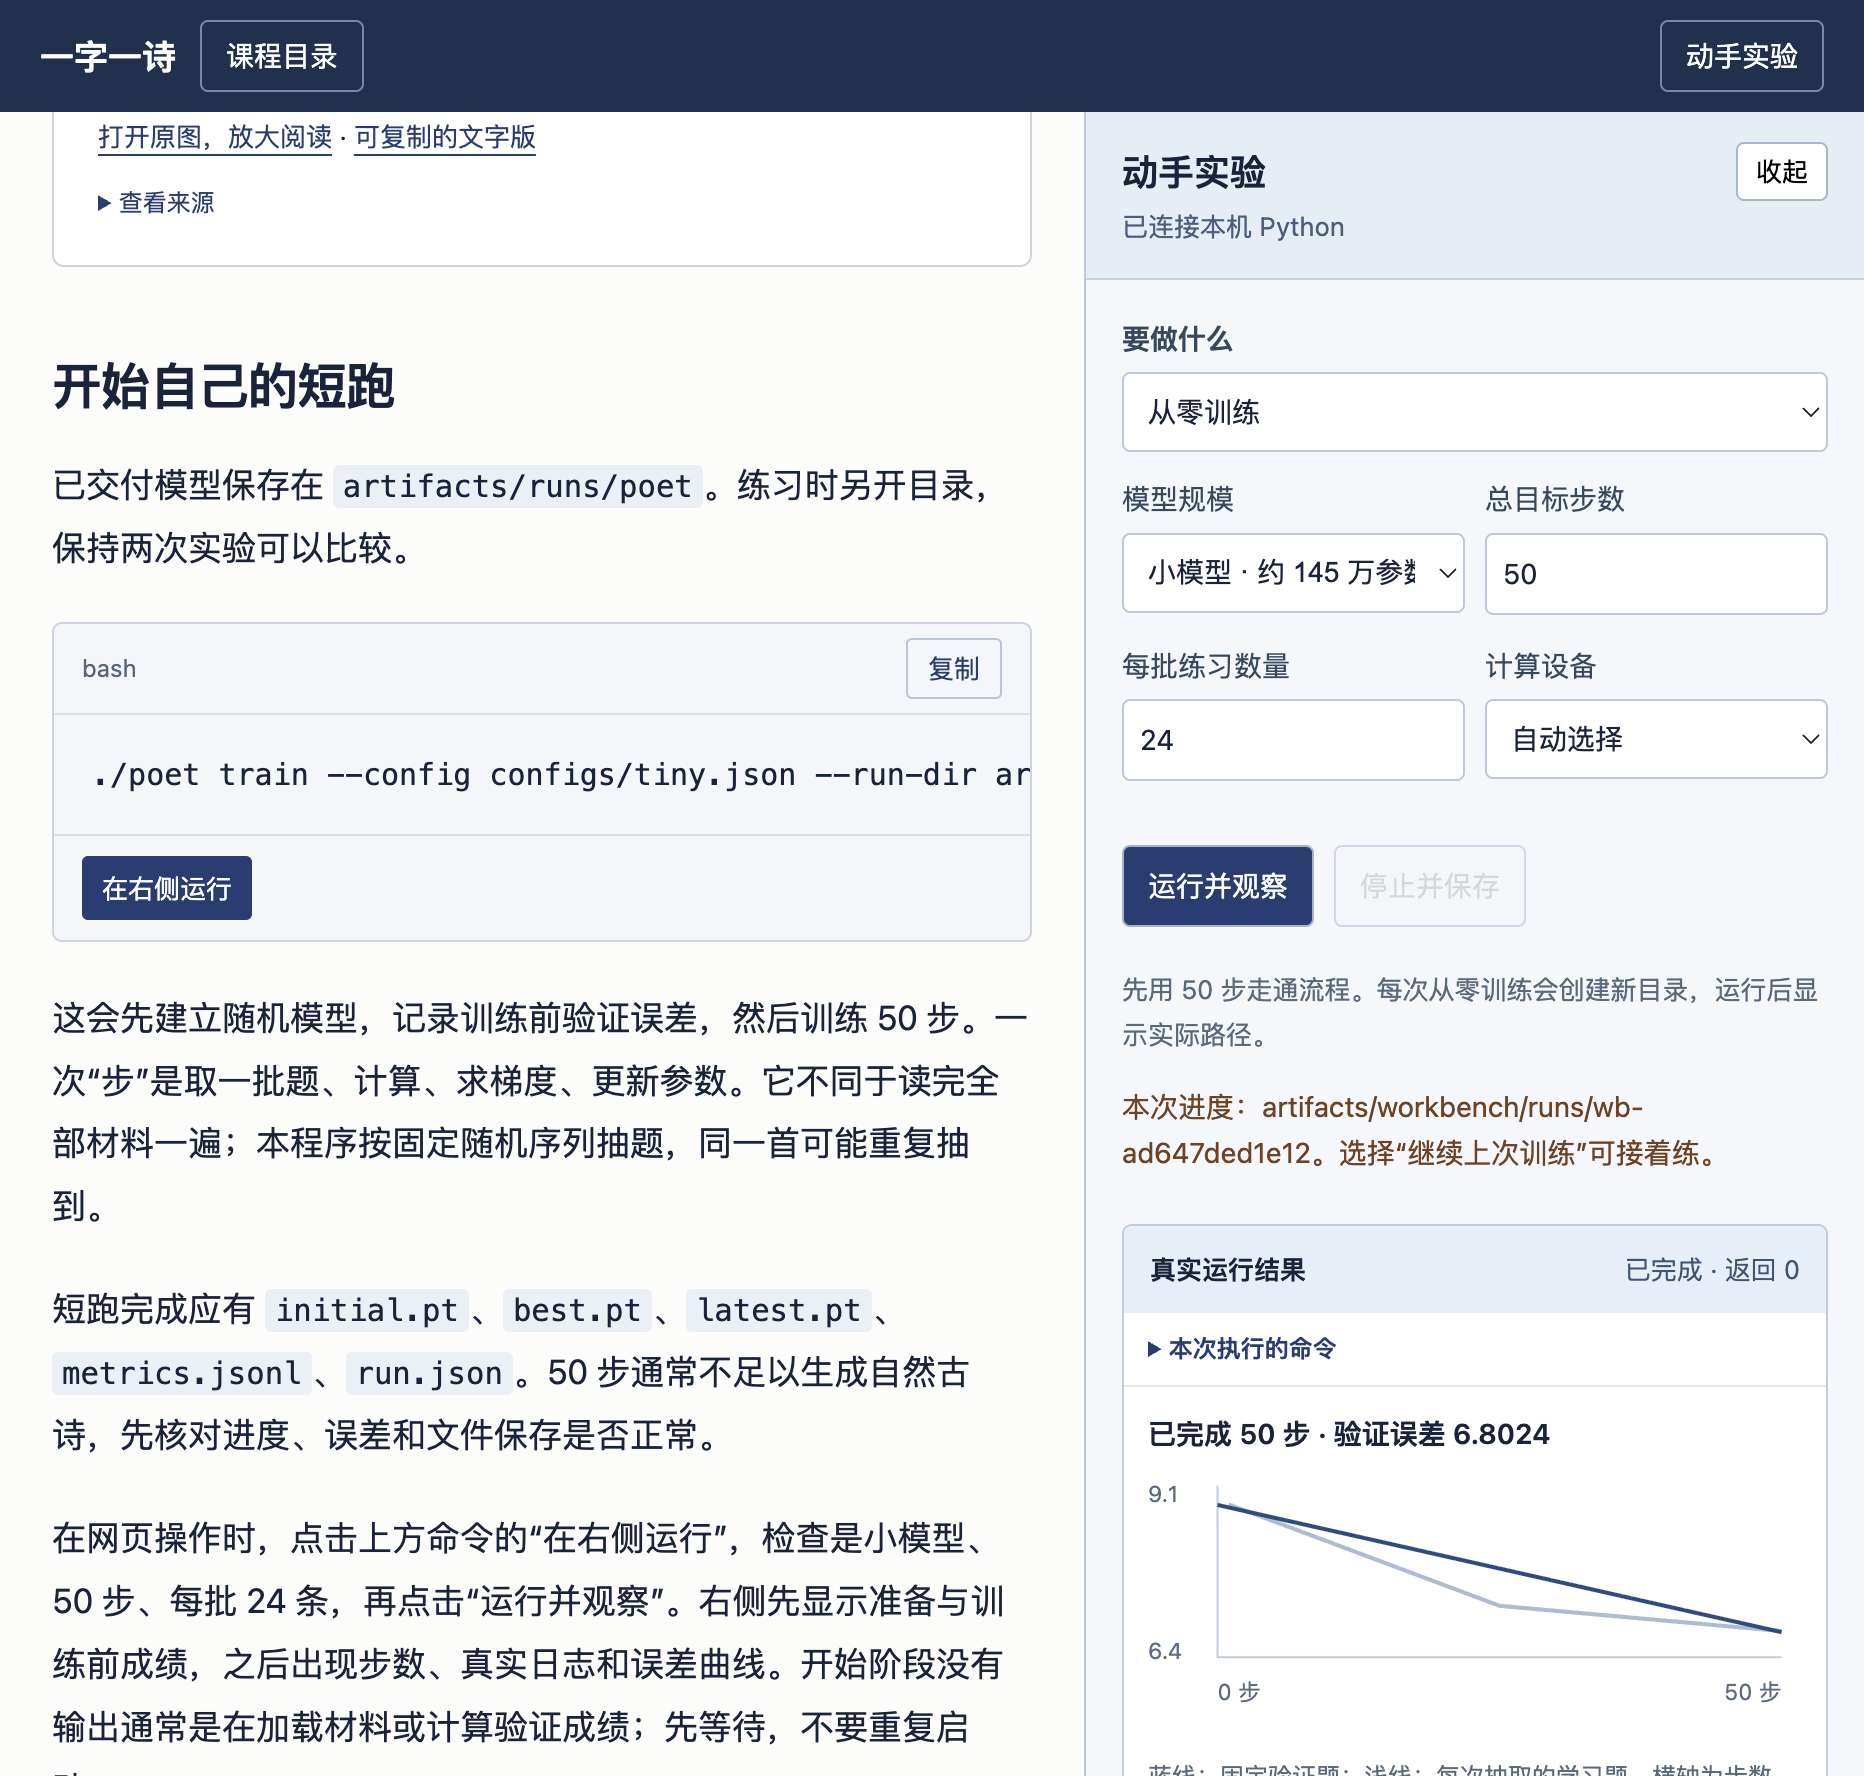
把一次训练的设置和成绩连起来
- 先看哪里
- 右侧是小模型、50 步、每批 24 条。结果区显示已完成 50 步,验证误差约 6.8024。
- 这说明什么
- 这些数字来自本机新建的训练进程。蓝线使用固定验证题,浅线来自每次抽取的学习题;短跑能说明学习过程有效,但还不能保证写诗质量。
- 你接着做
- 向下滚动右侧查看完整日志和实际目录,再到第 18 课选择同一记录继续到 75 步。
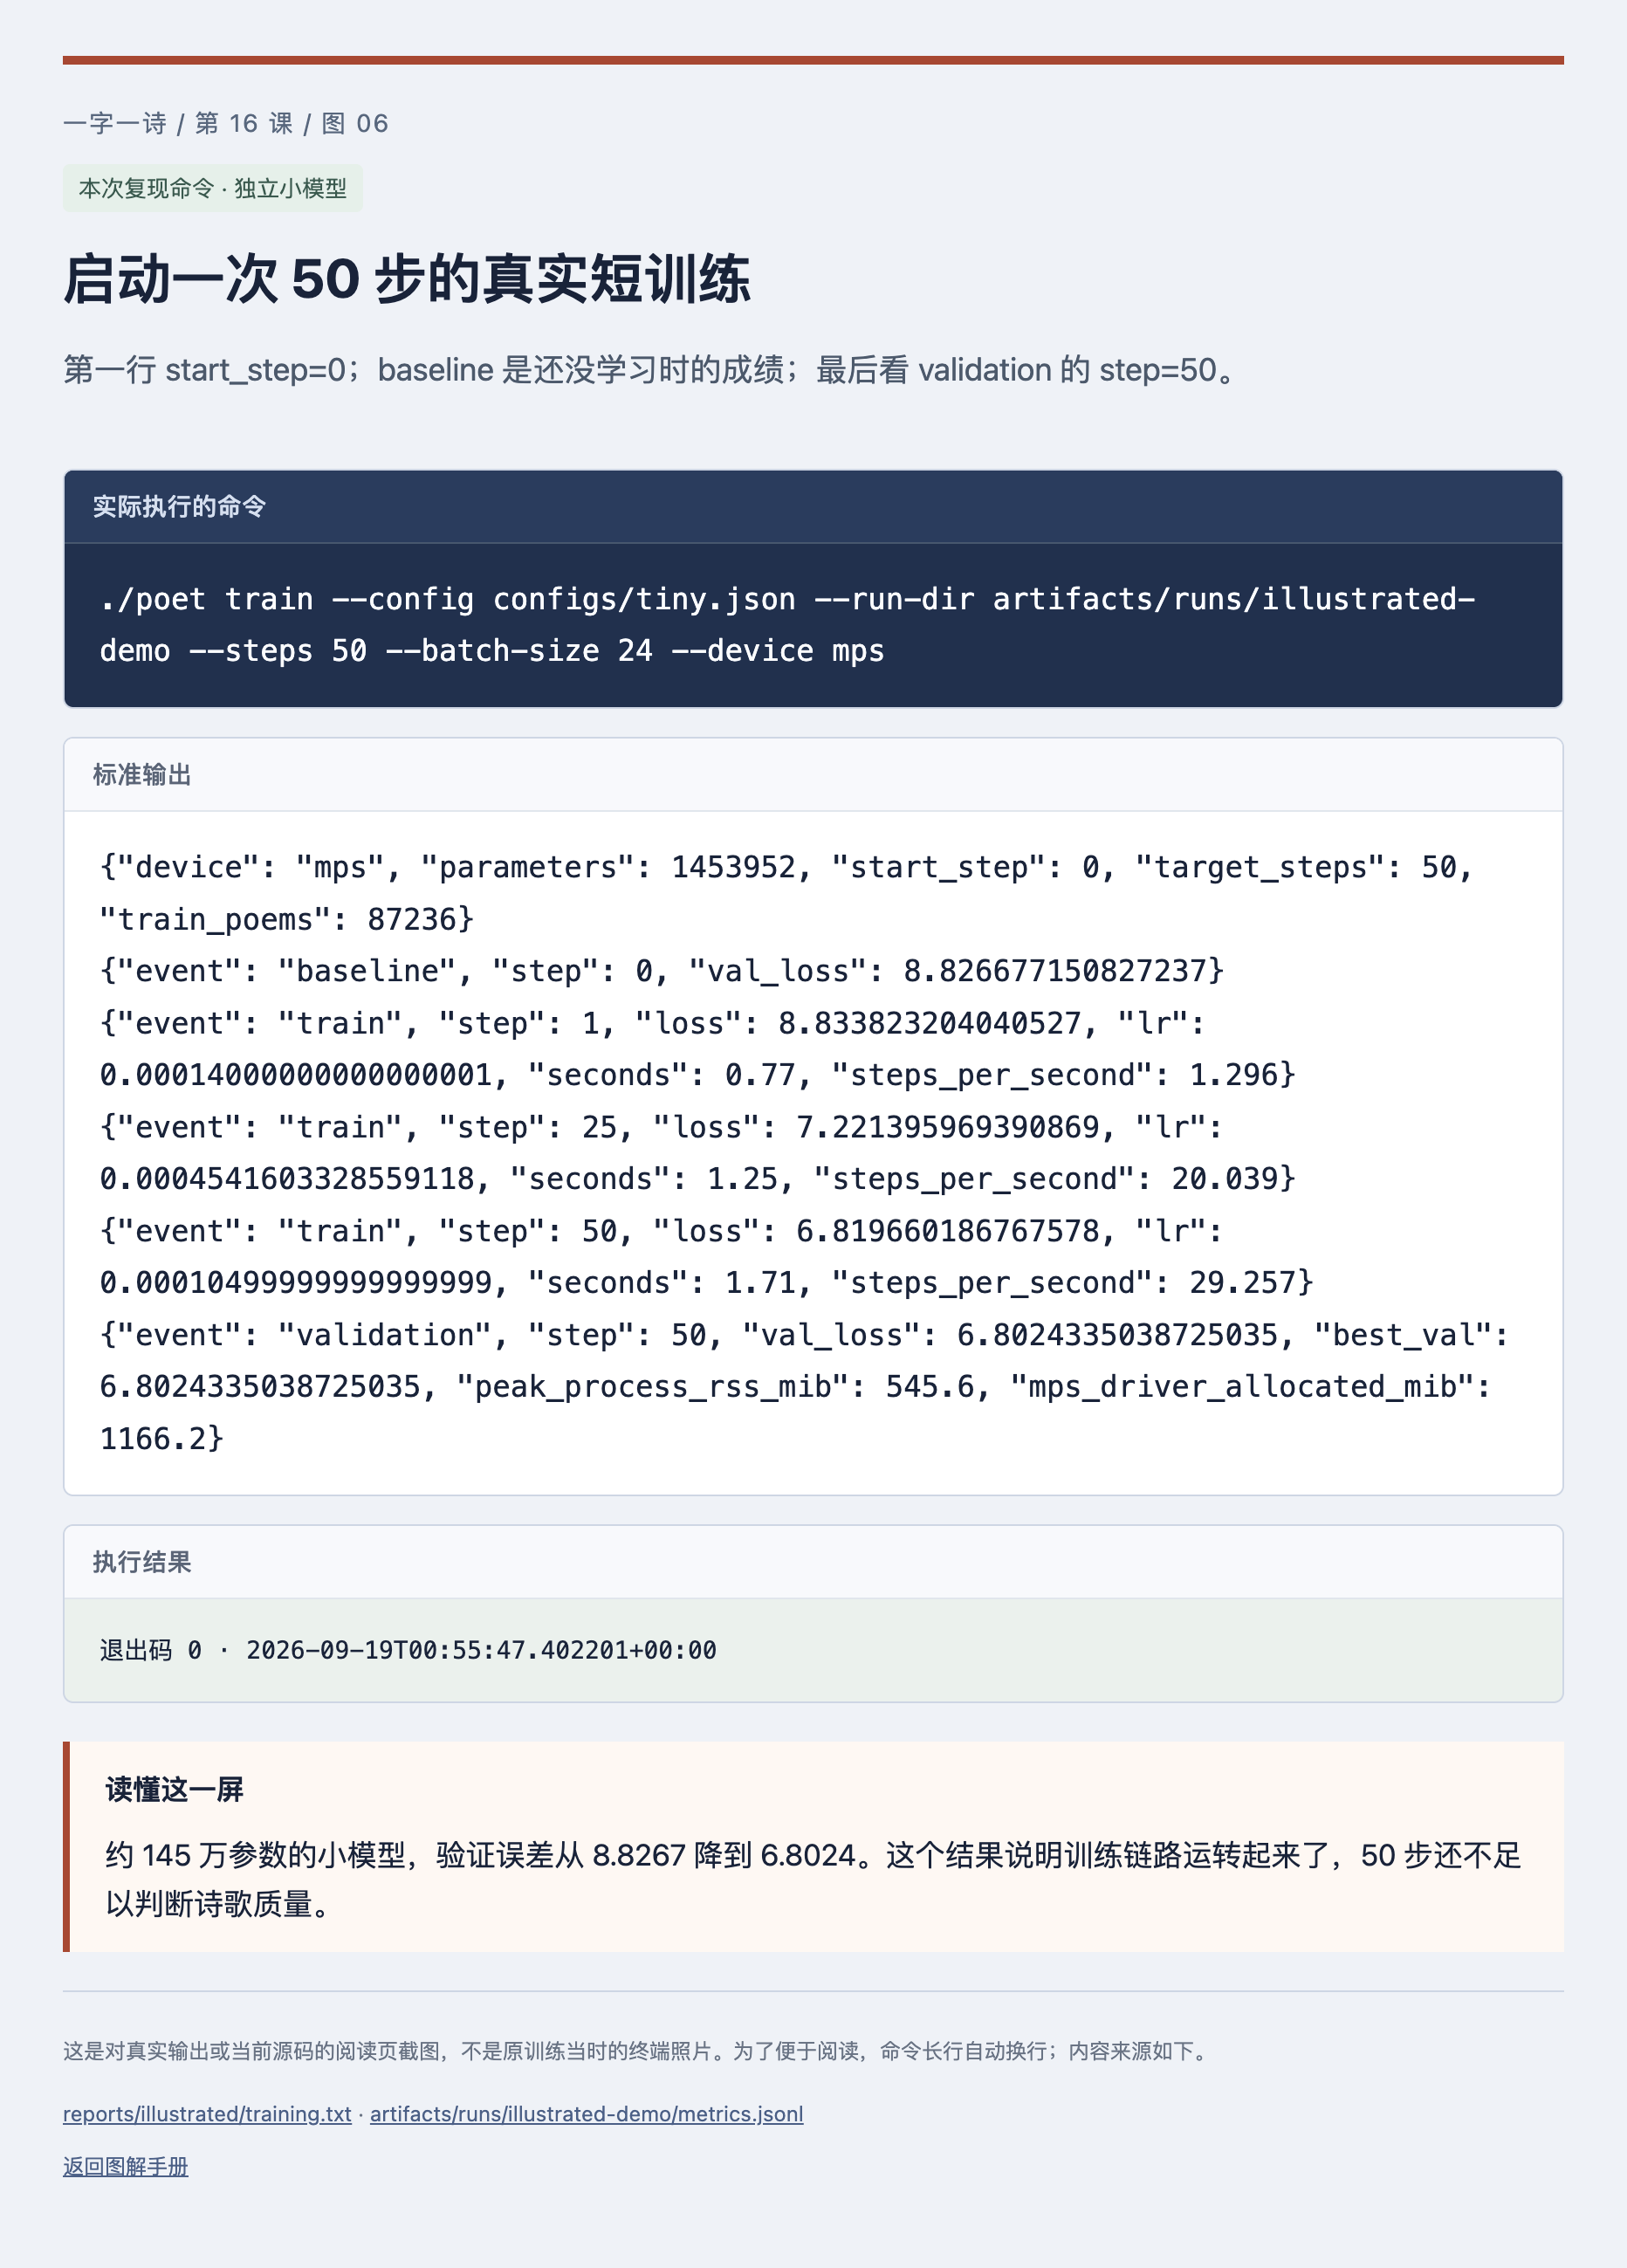
启动一次 50 步的真实短训练
- 先看哪里
- 第一行 start_step=0;baseline 是还没学习时的成绩;最后看 validation 的 step=50。
- 这说明什么
- 约 145 万参数的小模型,验证误差从 8.8267 降到 6.8024。这个结果说明训练链路运转起来了,50 步还不足以判断诗歌质量。
- 你接着做
- 用第 16 课的新目录命令自己跑 50 步;检查 run.json 与 latest.pt 是否出现。不要照抄已经有进度的演示目录。
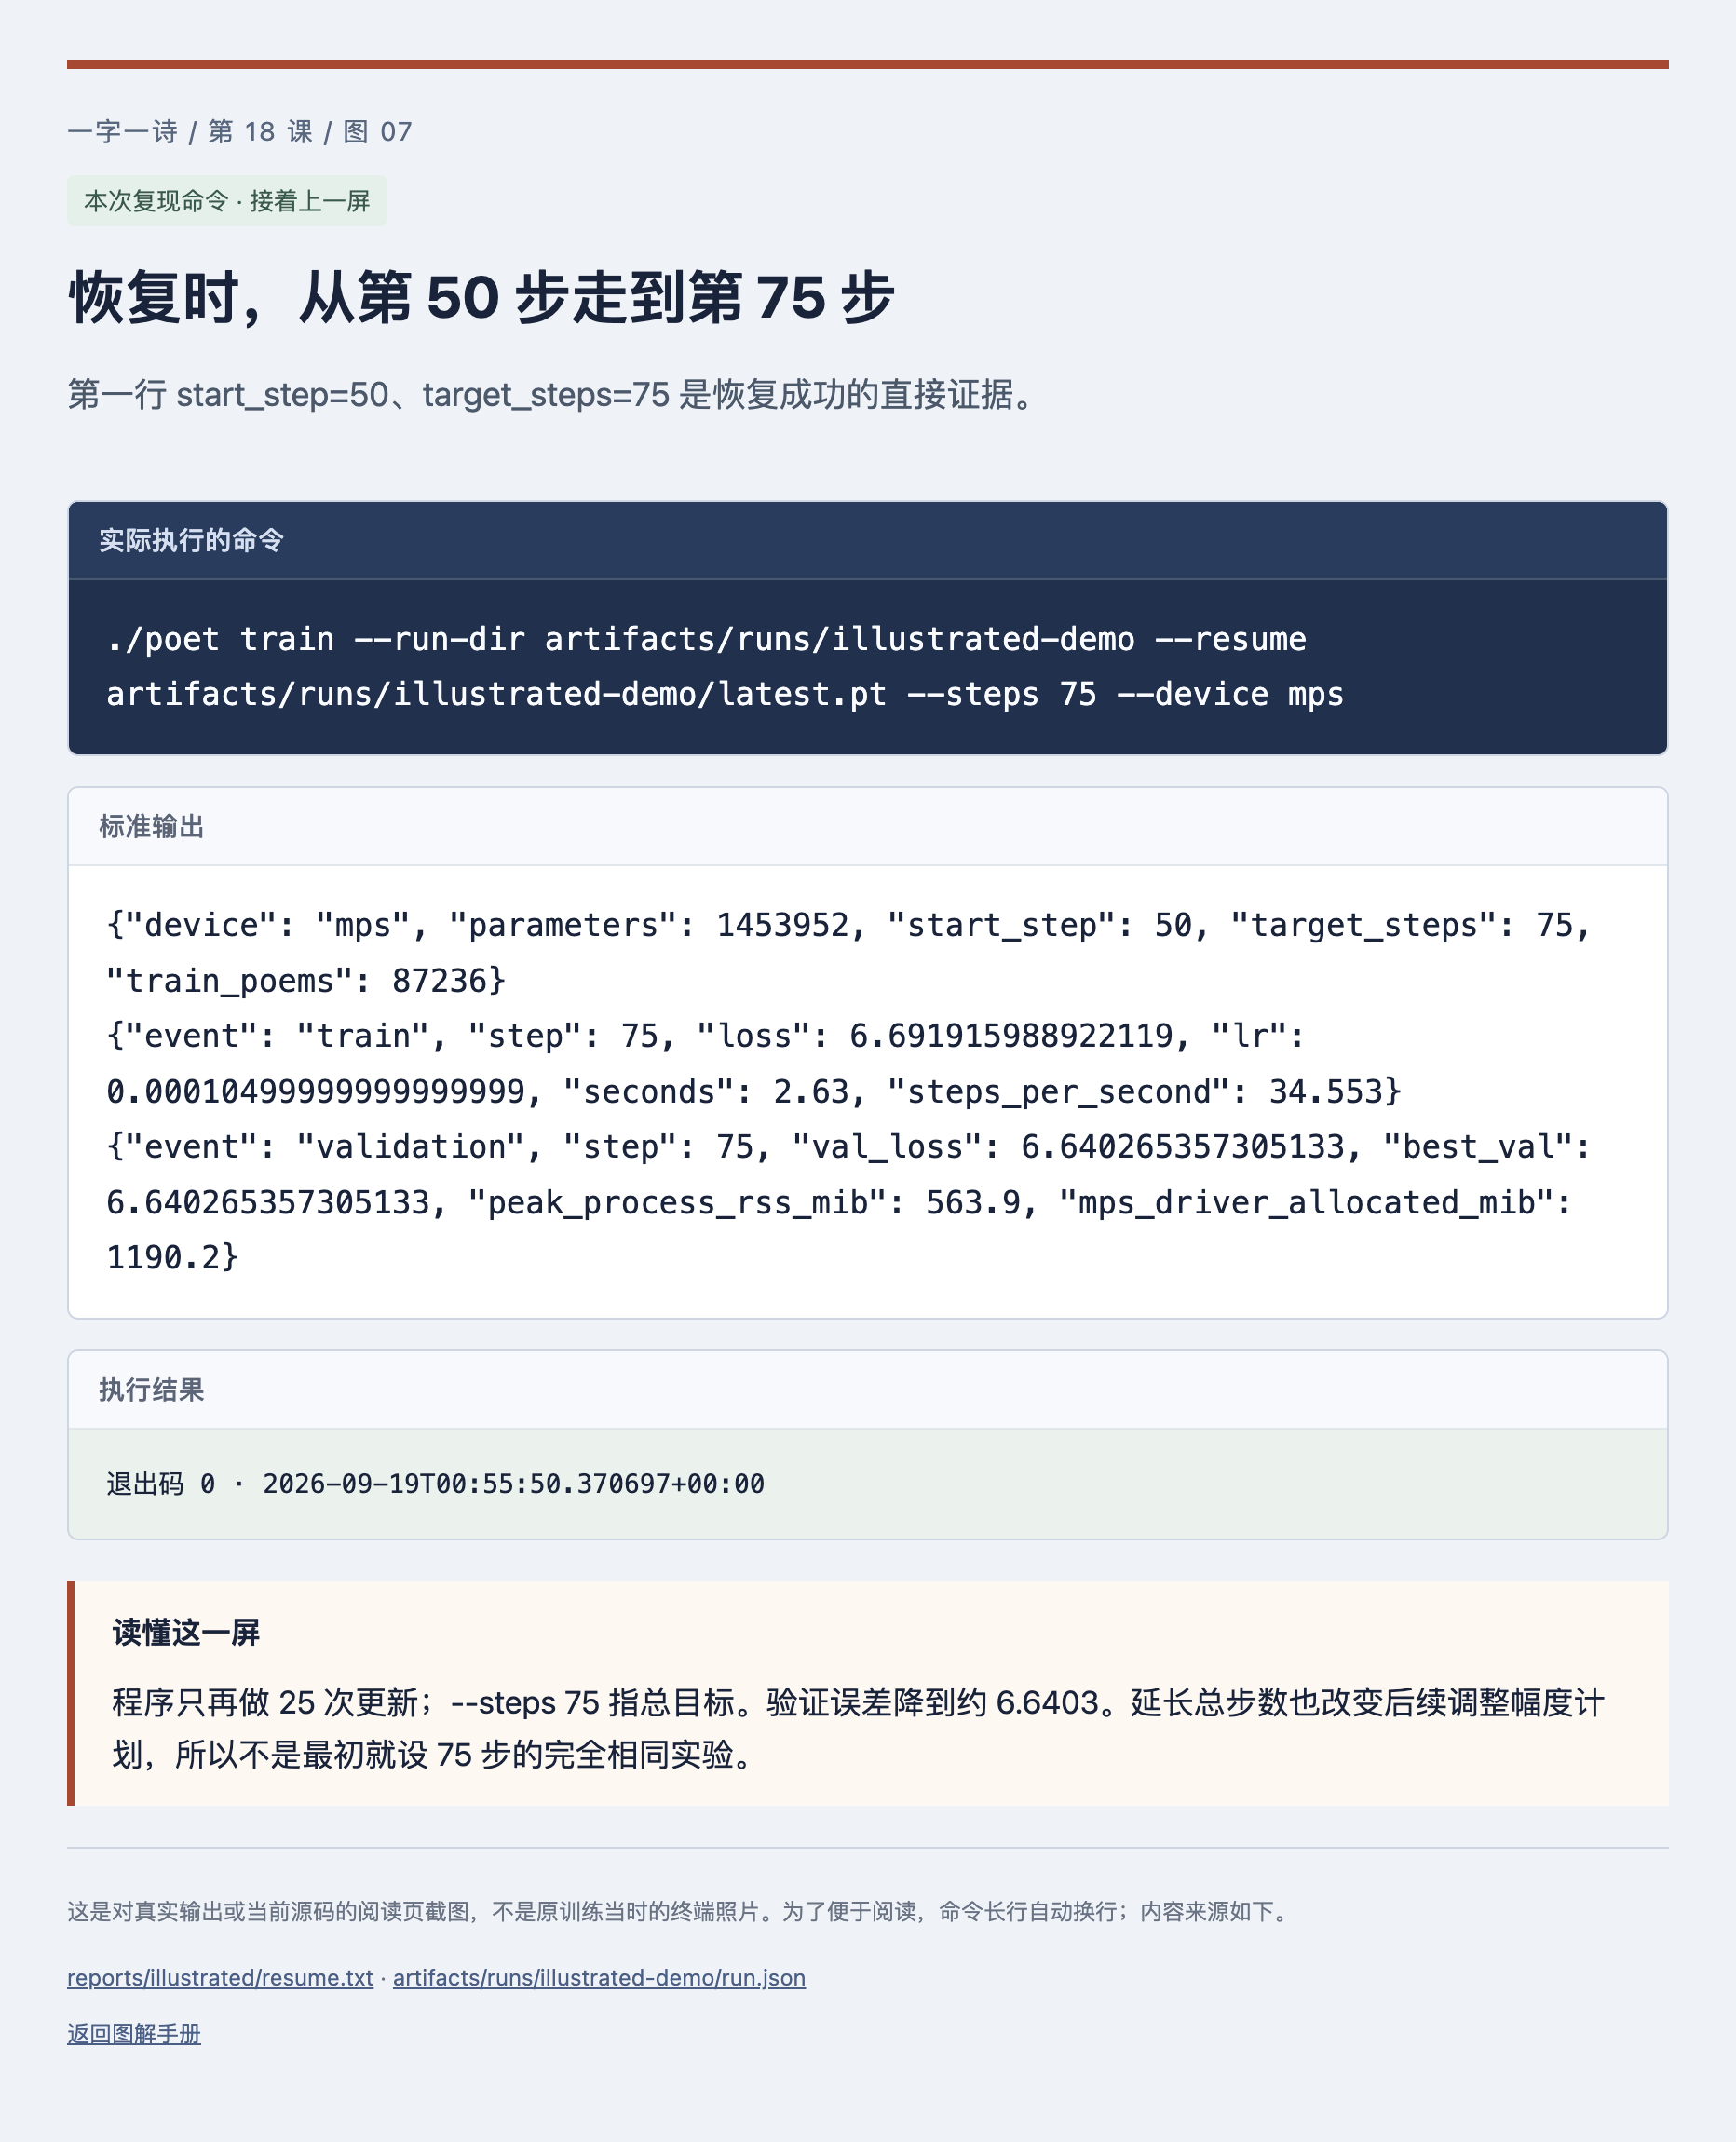
恢复时,从第 50 步走到第 75 步
- 先看哪里
- 第一行 start_step=50、target_steps=75 是恢复成功的直接证据。
- 这说明什么
- 程序只再做 25 次更新;--steps 75 指总目标。验证误差降到约 6.6403。延长总步数也改变后续调整幅度计划,所以不是最初就设 75 步的完全相同实验。
- 你接着做
- 给你自己的目录传入 --resume …/latest.pt;如果 start_step 仍为 0,先核对文件路径。
学会短跑后,再看正式模型的训练记录。下面的约 20 分钟是原来两段正式训练的累计时间,不包含下载、整理材料和编写课程。
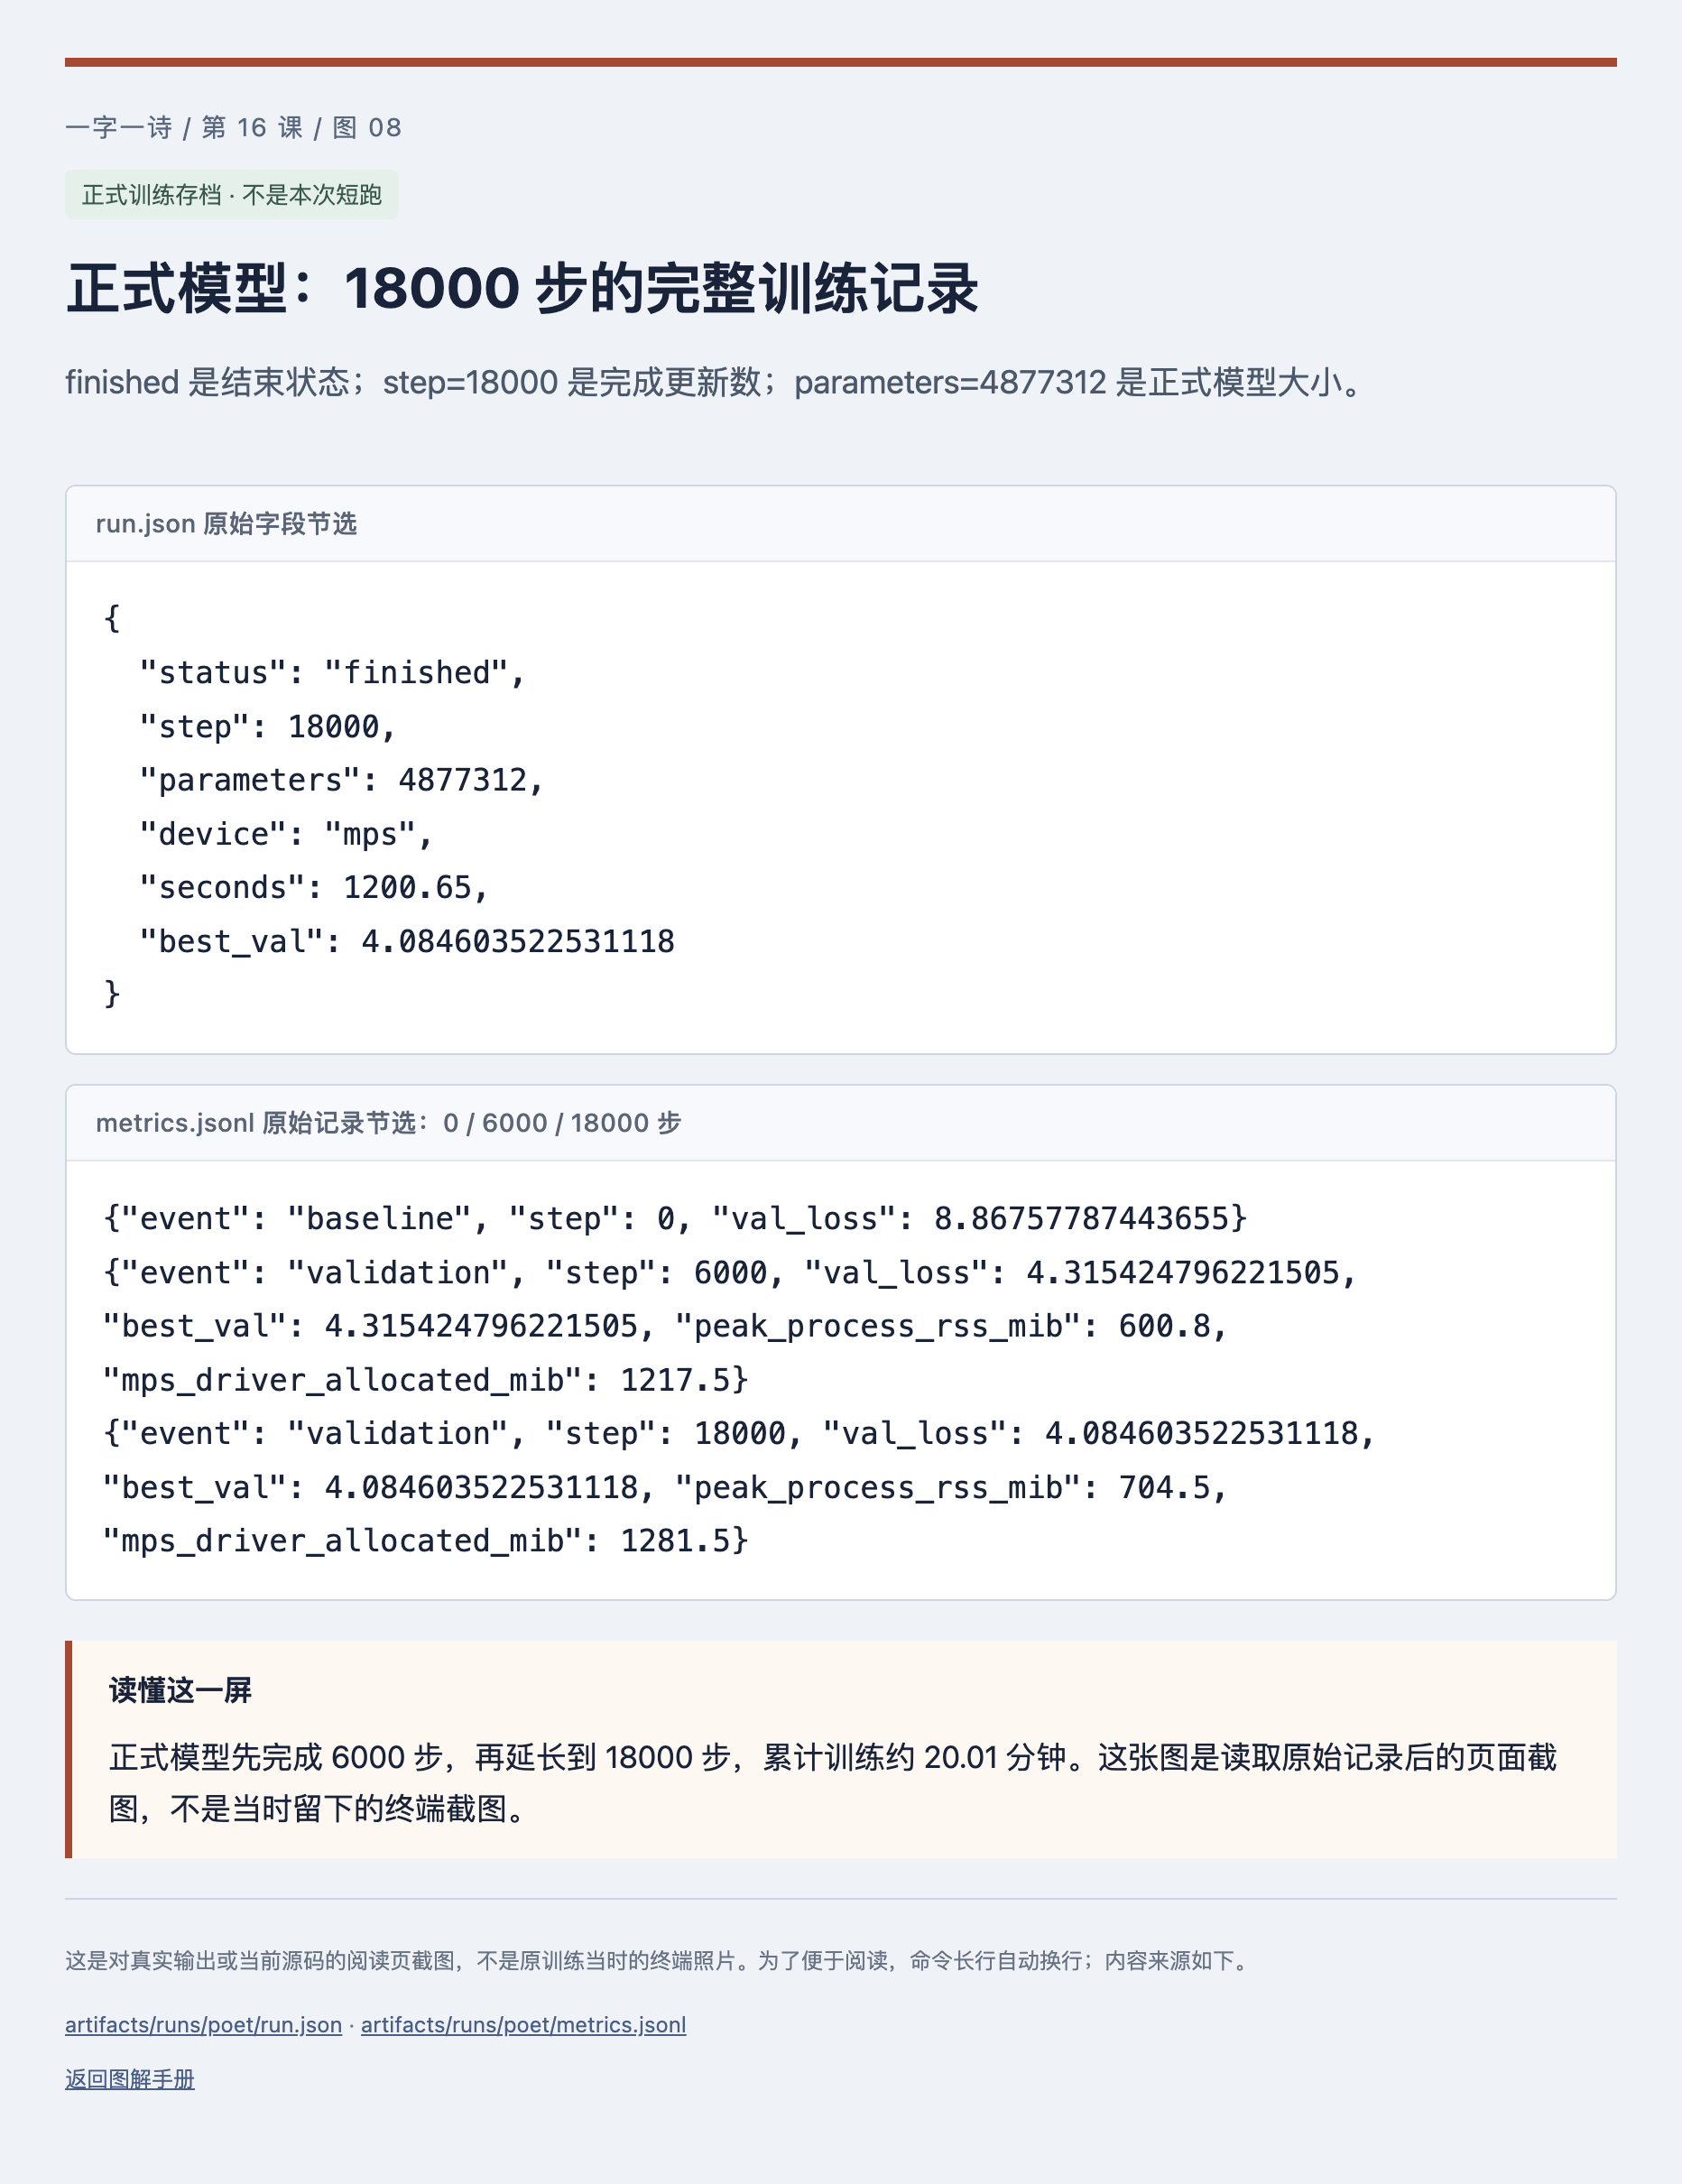
正式模型:18000 步的完整训练记录
- 先看哪里
- finished 是结束状态;step=18000 是完成更新数;parameters=4877312 是正式模型大小。
- 这说明什么
- 正式模型先完成 6000 步,再延长到 18000 步,累计训练约 20.01 分钟。这张图是读取原始记录后的页面截图,不是当时留下的终端截图。
- 你接着做
- 打开下方完整日志或训练曲线,既看中间的波动,也看最终结果;不要只截一个好看的数字。
③ 不只看“完成”,还要看学到了多少
下一张曲线使用完整日志中的 61 条基线与验证记录,未平滑或跳过中间变化。右边放大后半段,便于看到恢复训练后的反弹。两张图纵轴刻度不同,要先读刻度再比较。
完整训练误差曲线:包括中间的波动
- 先看哪里
- 横轴是更新次数;纵轴是固定验证题的平均误差。右图放大后半段。
- 这说明什么
- 曲线直接使用 61 条基线及验证记录,没有平滑。6000 步后恢复并延长训练,调整幅度计划改变,随后出现短暂反弹,再继续下降。
- 你接着做
- 先比较同一口径的曲线;再看第 19 课另外保存的最终评估,不能把不同抽样的数字混在一起。
最终比较使用固定的 60 批、每批 32 条题目,与曲线中每次 12 批、每批 48 条的口径不同。数字略有差异是可解释的,不应拿不同抽样的两次结果直接判断好坏。详见第 17 课和第 19 课。
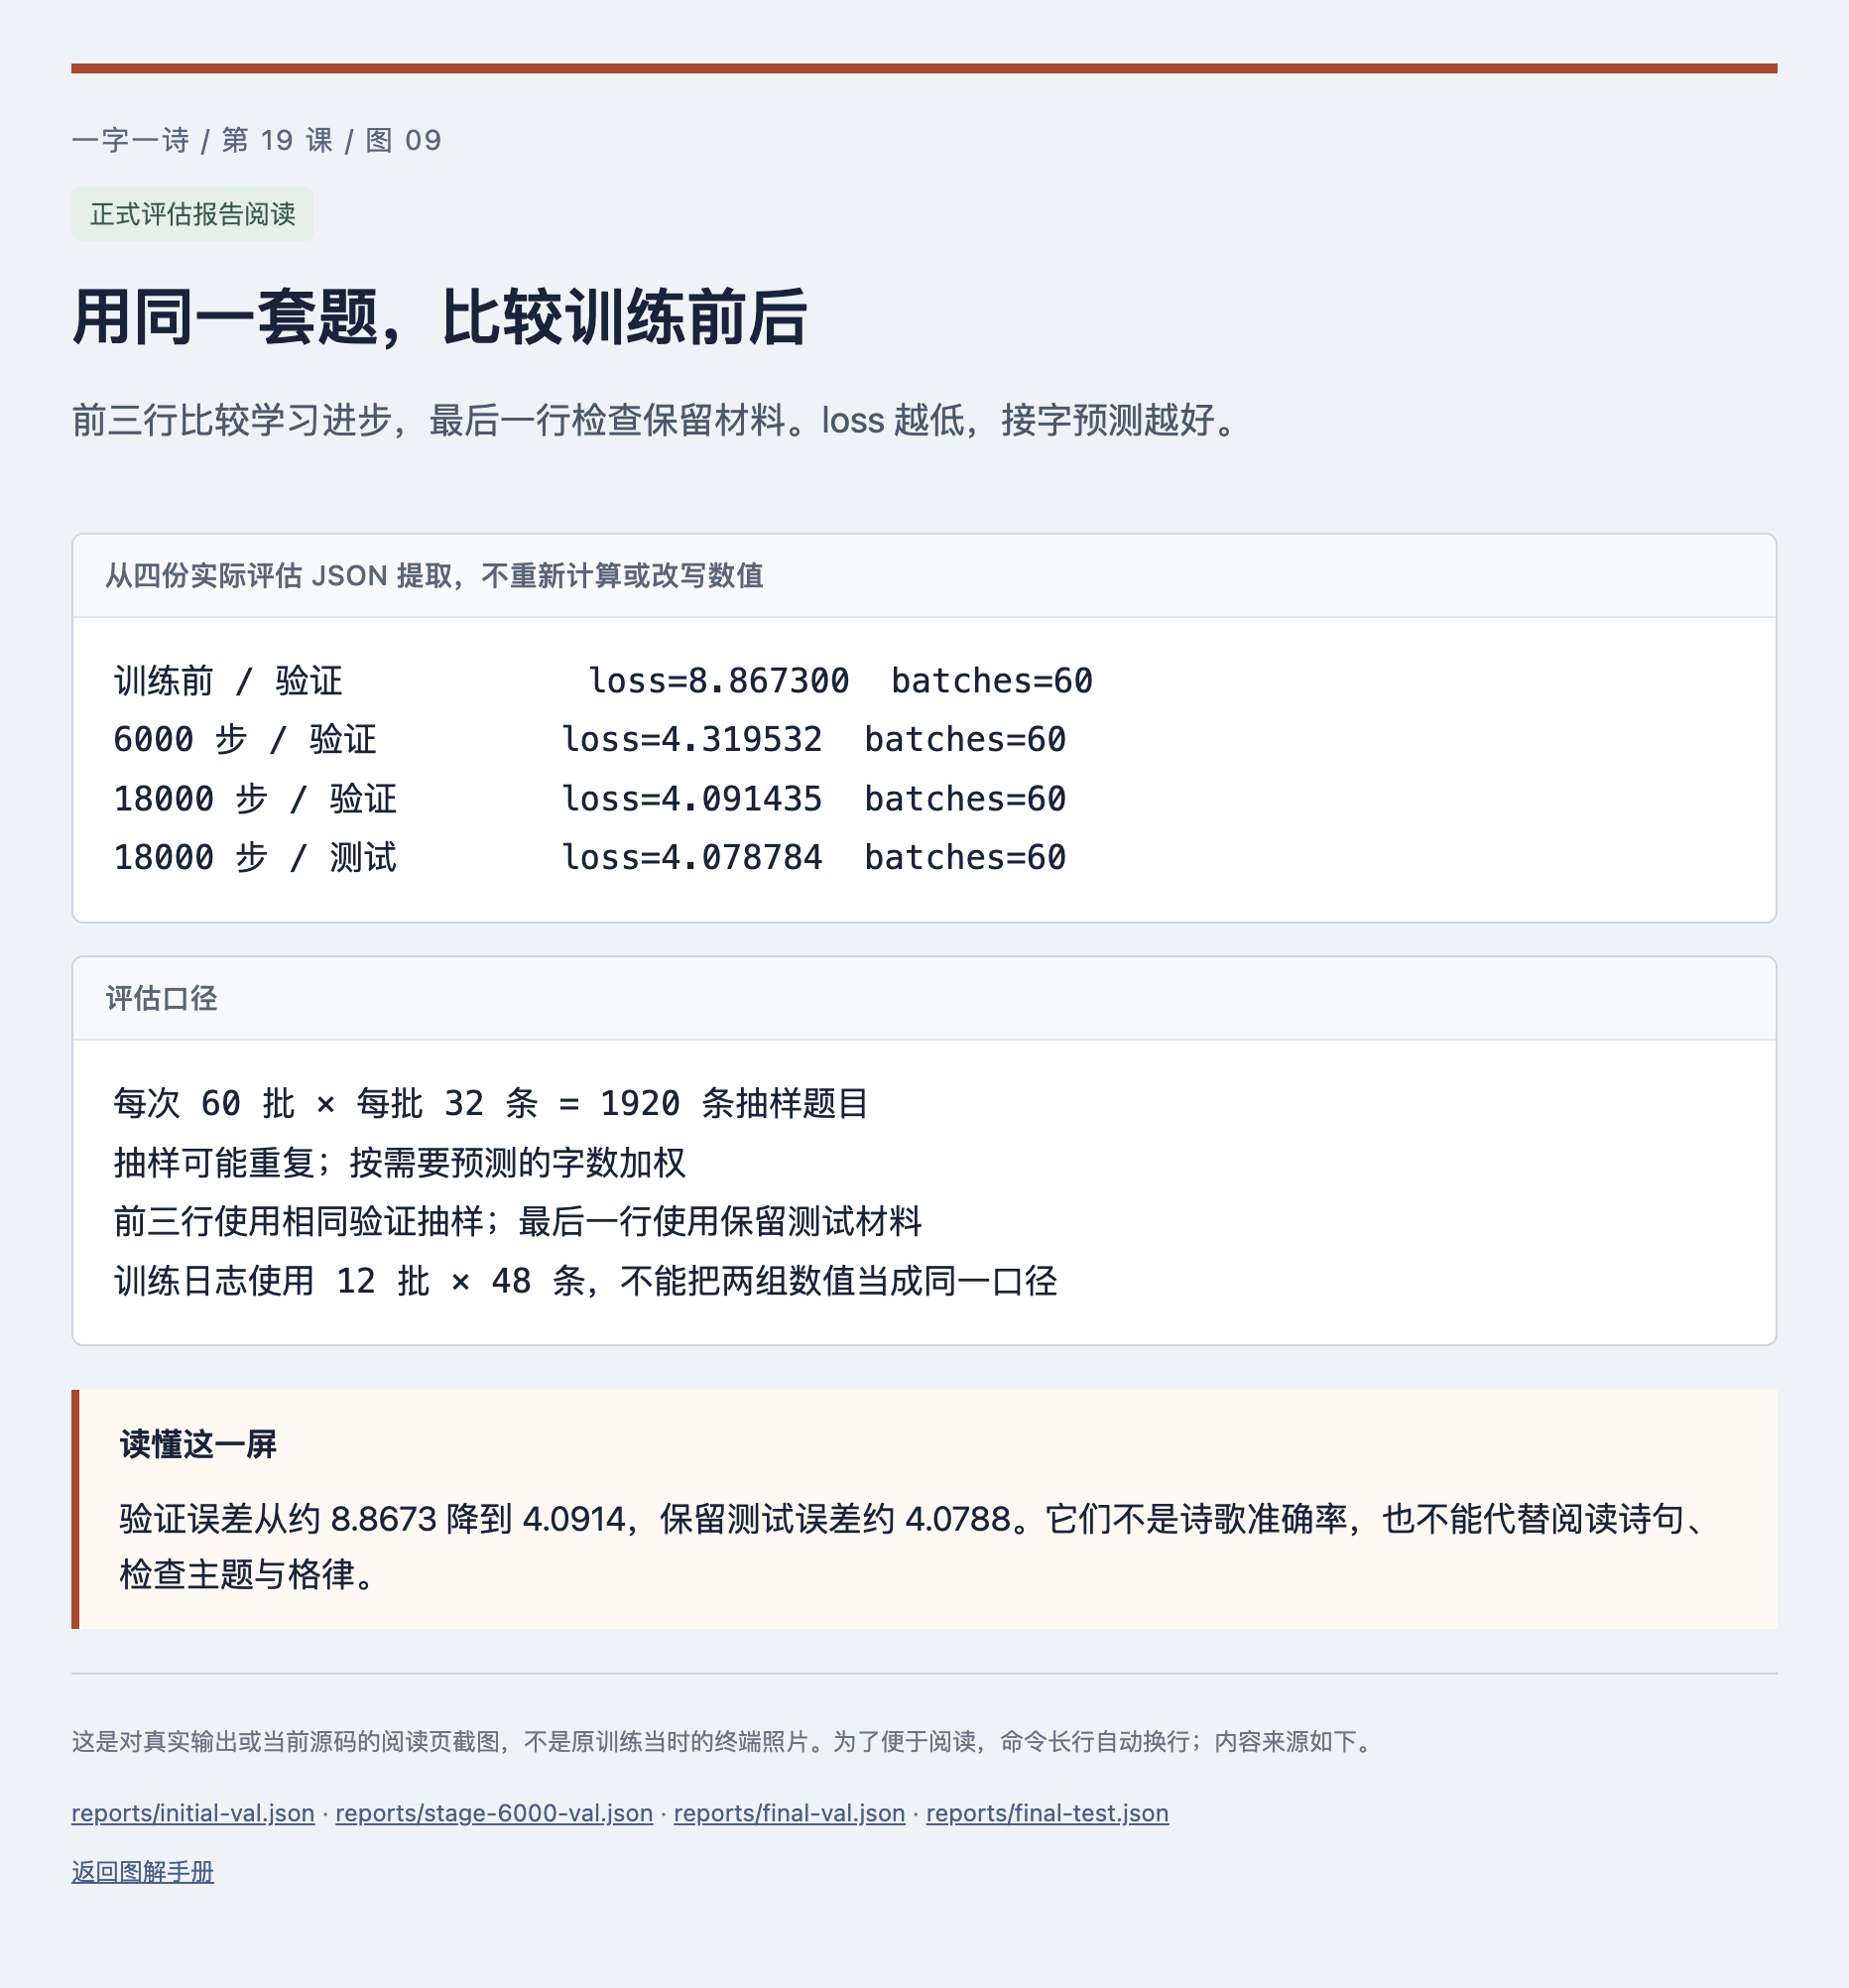
用同一套题,比较训练前后
- 先看哪里
- 前三行比较学习进步,最后一行检查保留材料。loss 越低,接字预测越好。
- 这说明什么
- 验证误差从约 8.8673 降到 4.0914,保留测试误差约 4.0788。它们不是诗歌准确率,也不能代替阅读诗句、检查主题与格律。
- 你接着做
- 用第 19 课的 evaluate 命令评估自己的模型,并明确记录抽了多少批题。
④ 亲手写出 CLI,而不只会使用命令
CLI 就是在终端里通过文字使用程序。我们把编写过程拆为三个能运行的版本;你每完成一个版本,都可以马上看到新增的能力。第 24 课有逐段解释、复制命令、完整源码和验收方法。
一张图追踪 CLI 的完整调用路线
- 先看哪里
- 命令从启动脚本开始,最后返回诗句或可供程序读取的数据。
- 这说明什么
- 训练产生的 best.pt 是写诗阶段的输入;训练和写诗是两次不同的程序运行。
- 你接着做
- 照第 24 课三个渐进版本动手,再阅读完整入口。
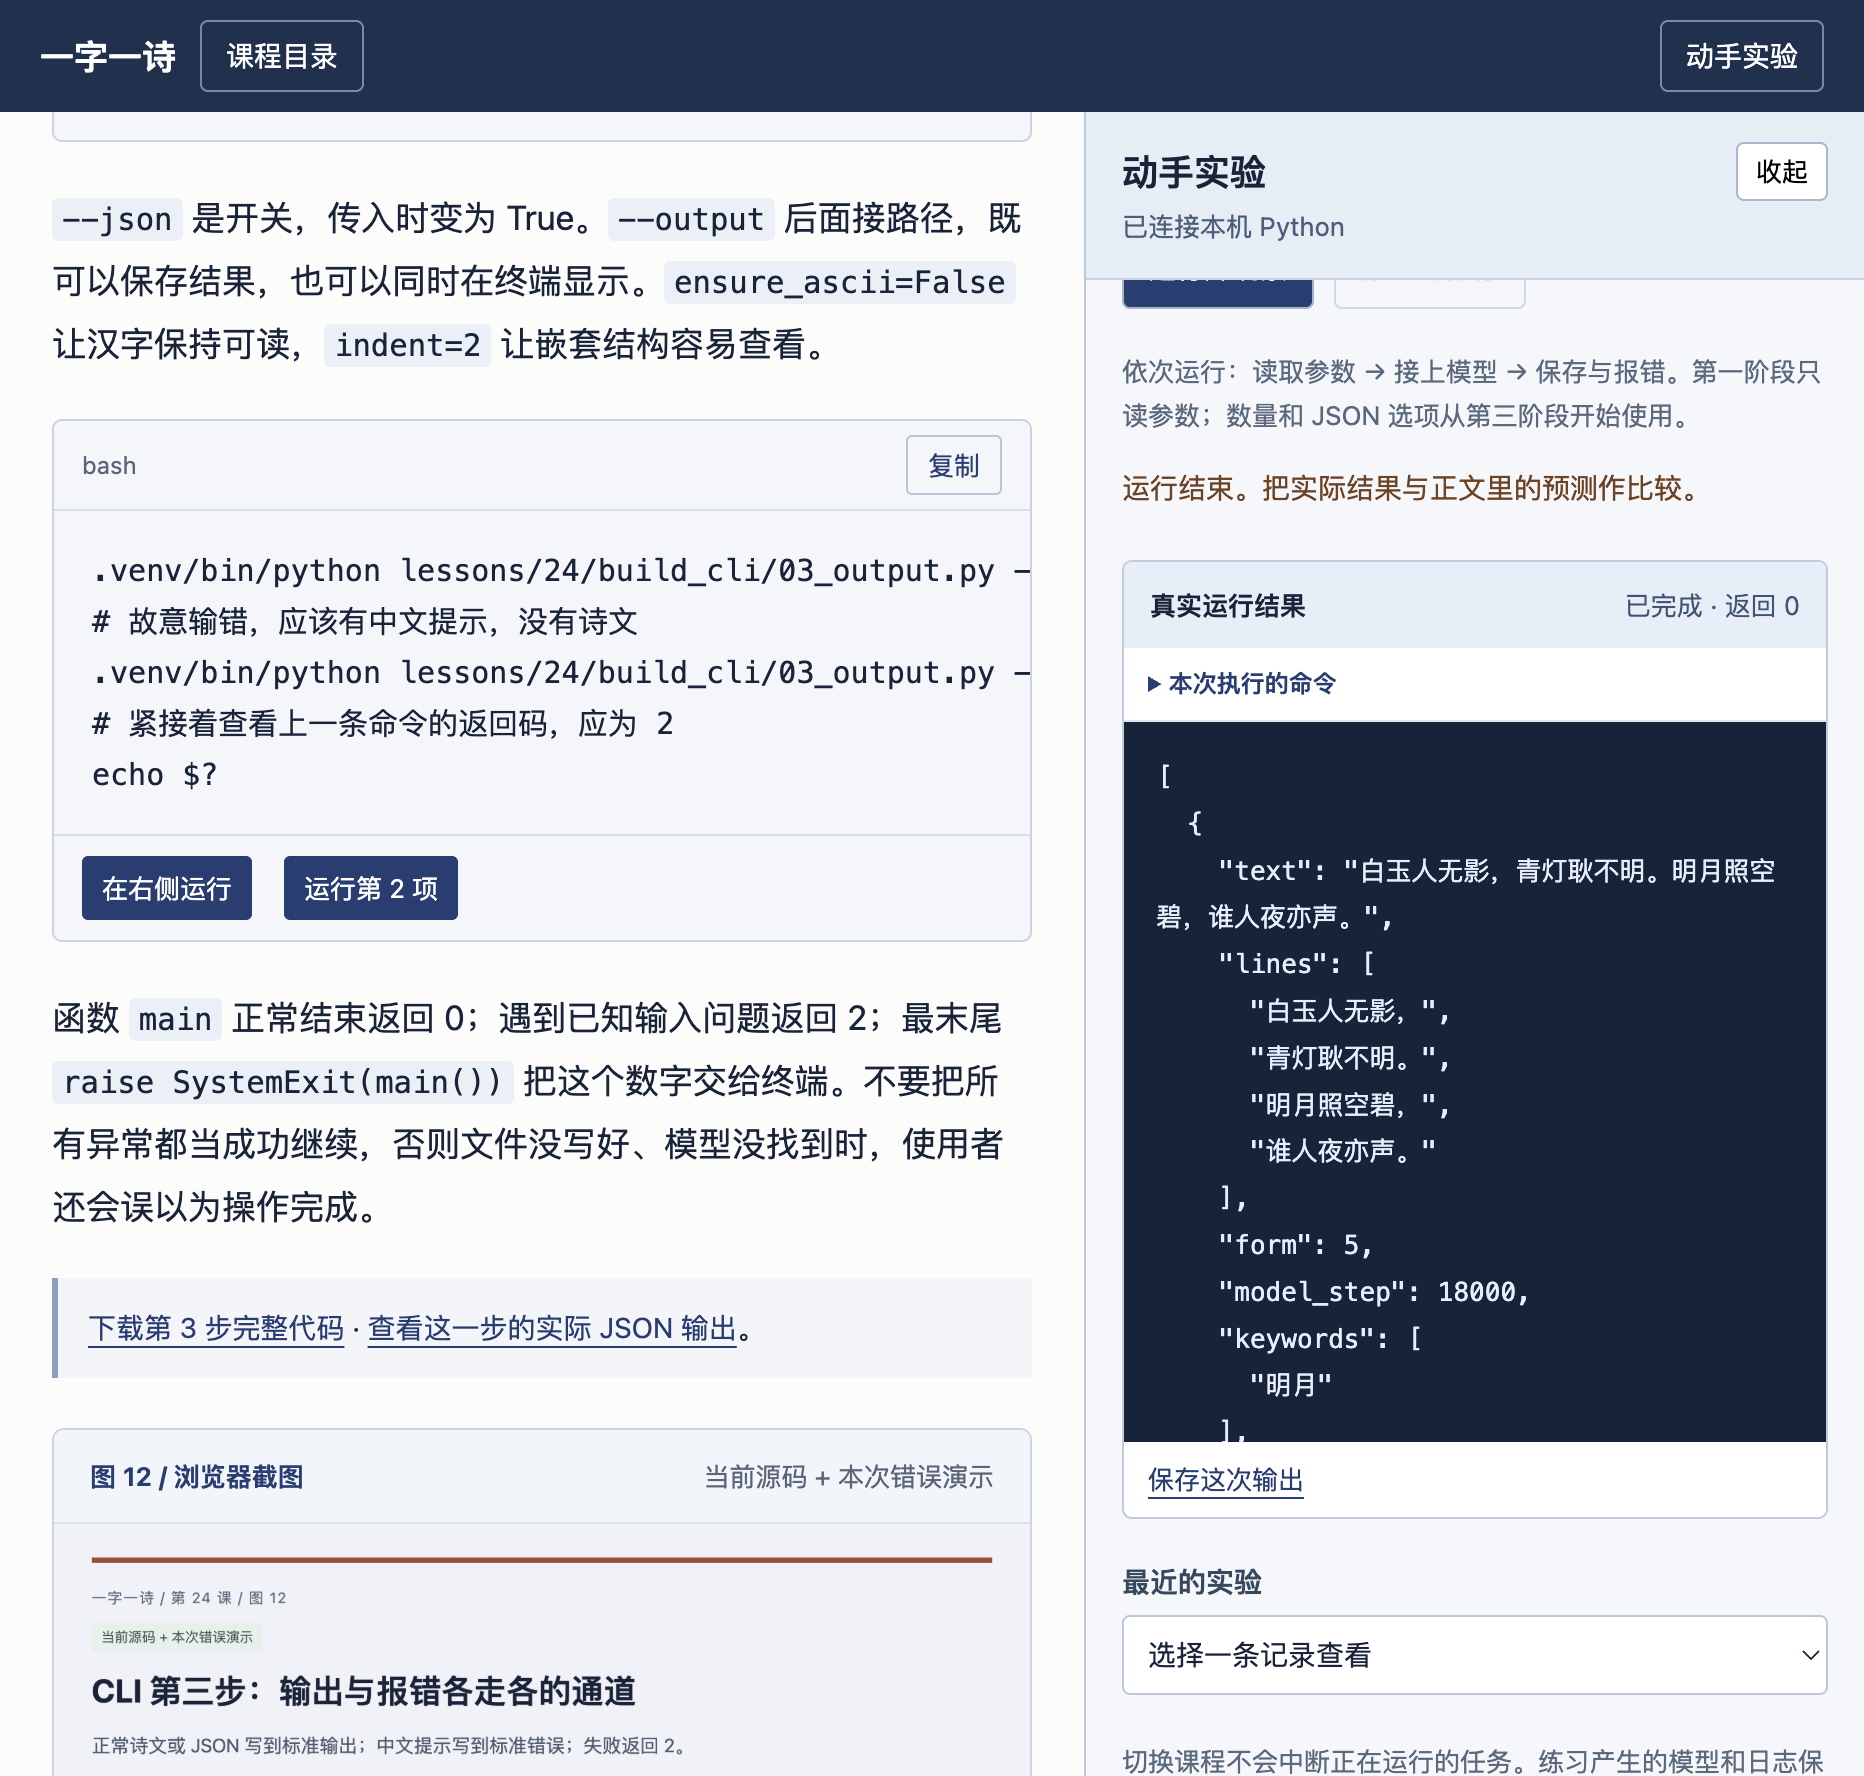
从参数,到可以被其他程序读取的结果
- 先看哪里
- 左侧讲 --json、--output 和返回码;右侧运行第三版 CLI,展示真实生成结果的 JSON。
- 这说明什么
- 返回 0 表示程序正常结束。JSON 里的 text 是诗文,model_step 是模型训练阶段,keyword_literal_hits 是关键词直接出现情况;它们各自回答不同问题。
- 你接着做
- 先运行读取参数和接上模型两个阶段,再运行第三阶段。把生成数量改为 0,观察中文错误提示和返回码 2。
# 第一步:只看参数怎样被读进来
.venv/bin/python lessons/24/build_cli/01_arguments.py --start 春 --form five
# 第二步:接上模型,输出四行诗
.venv/bin/python lessons/24/build_cli/02_write.py --start 春 --device cpu
# 第三步:返回可供程序读取的数据,并保存到文件
.venv/bin/python lessons/24/build_cli/03_output.py --keywords 明月 --json --output reports/my-cli-poem.json --device cpu配图中的 CLI 演示明确使用 CPU,便于同一设备、同一设置下对照;它不意味着训练必须使用 CPU。模型和训练数据始终来自本地文件。
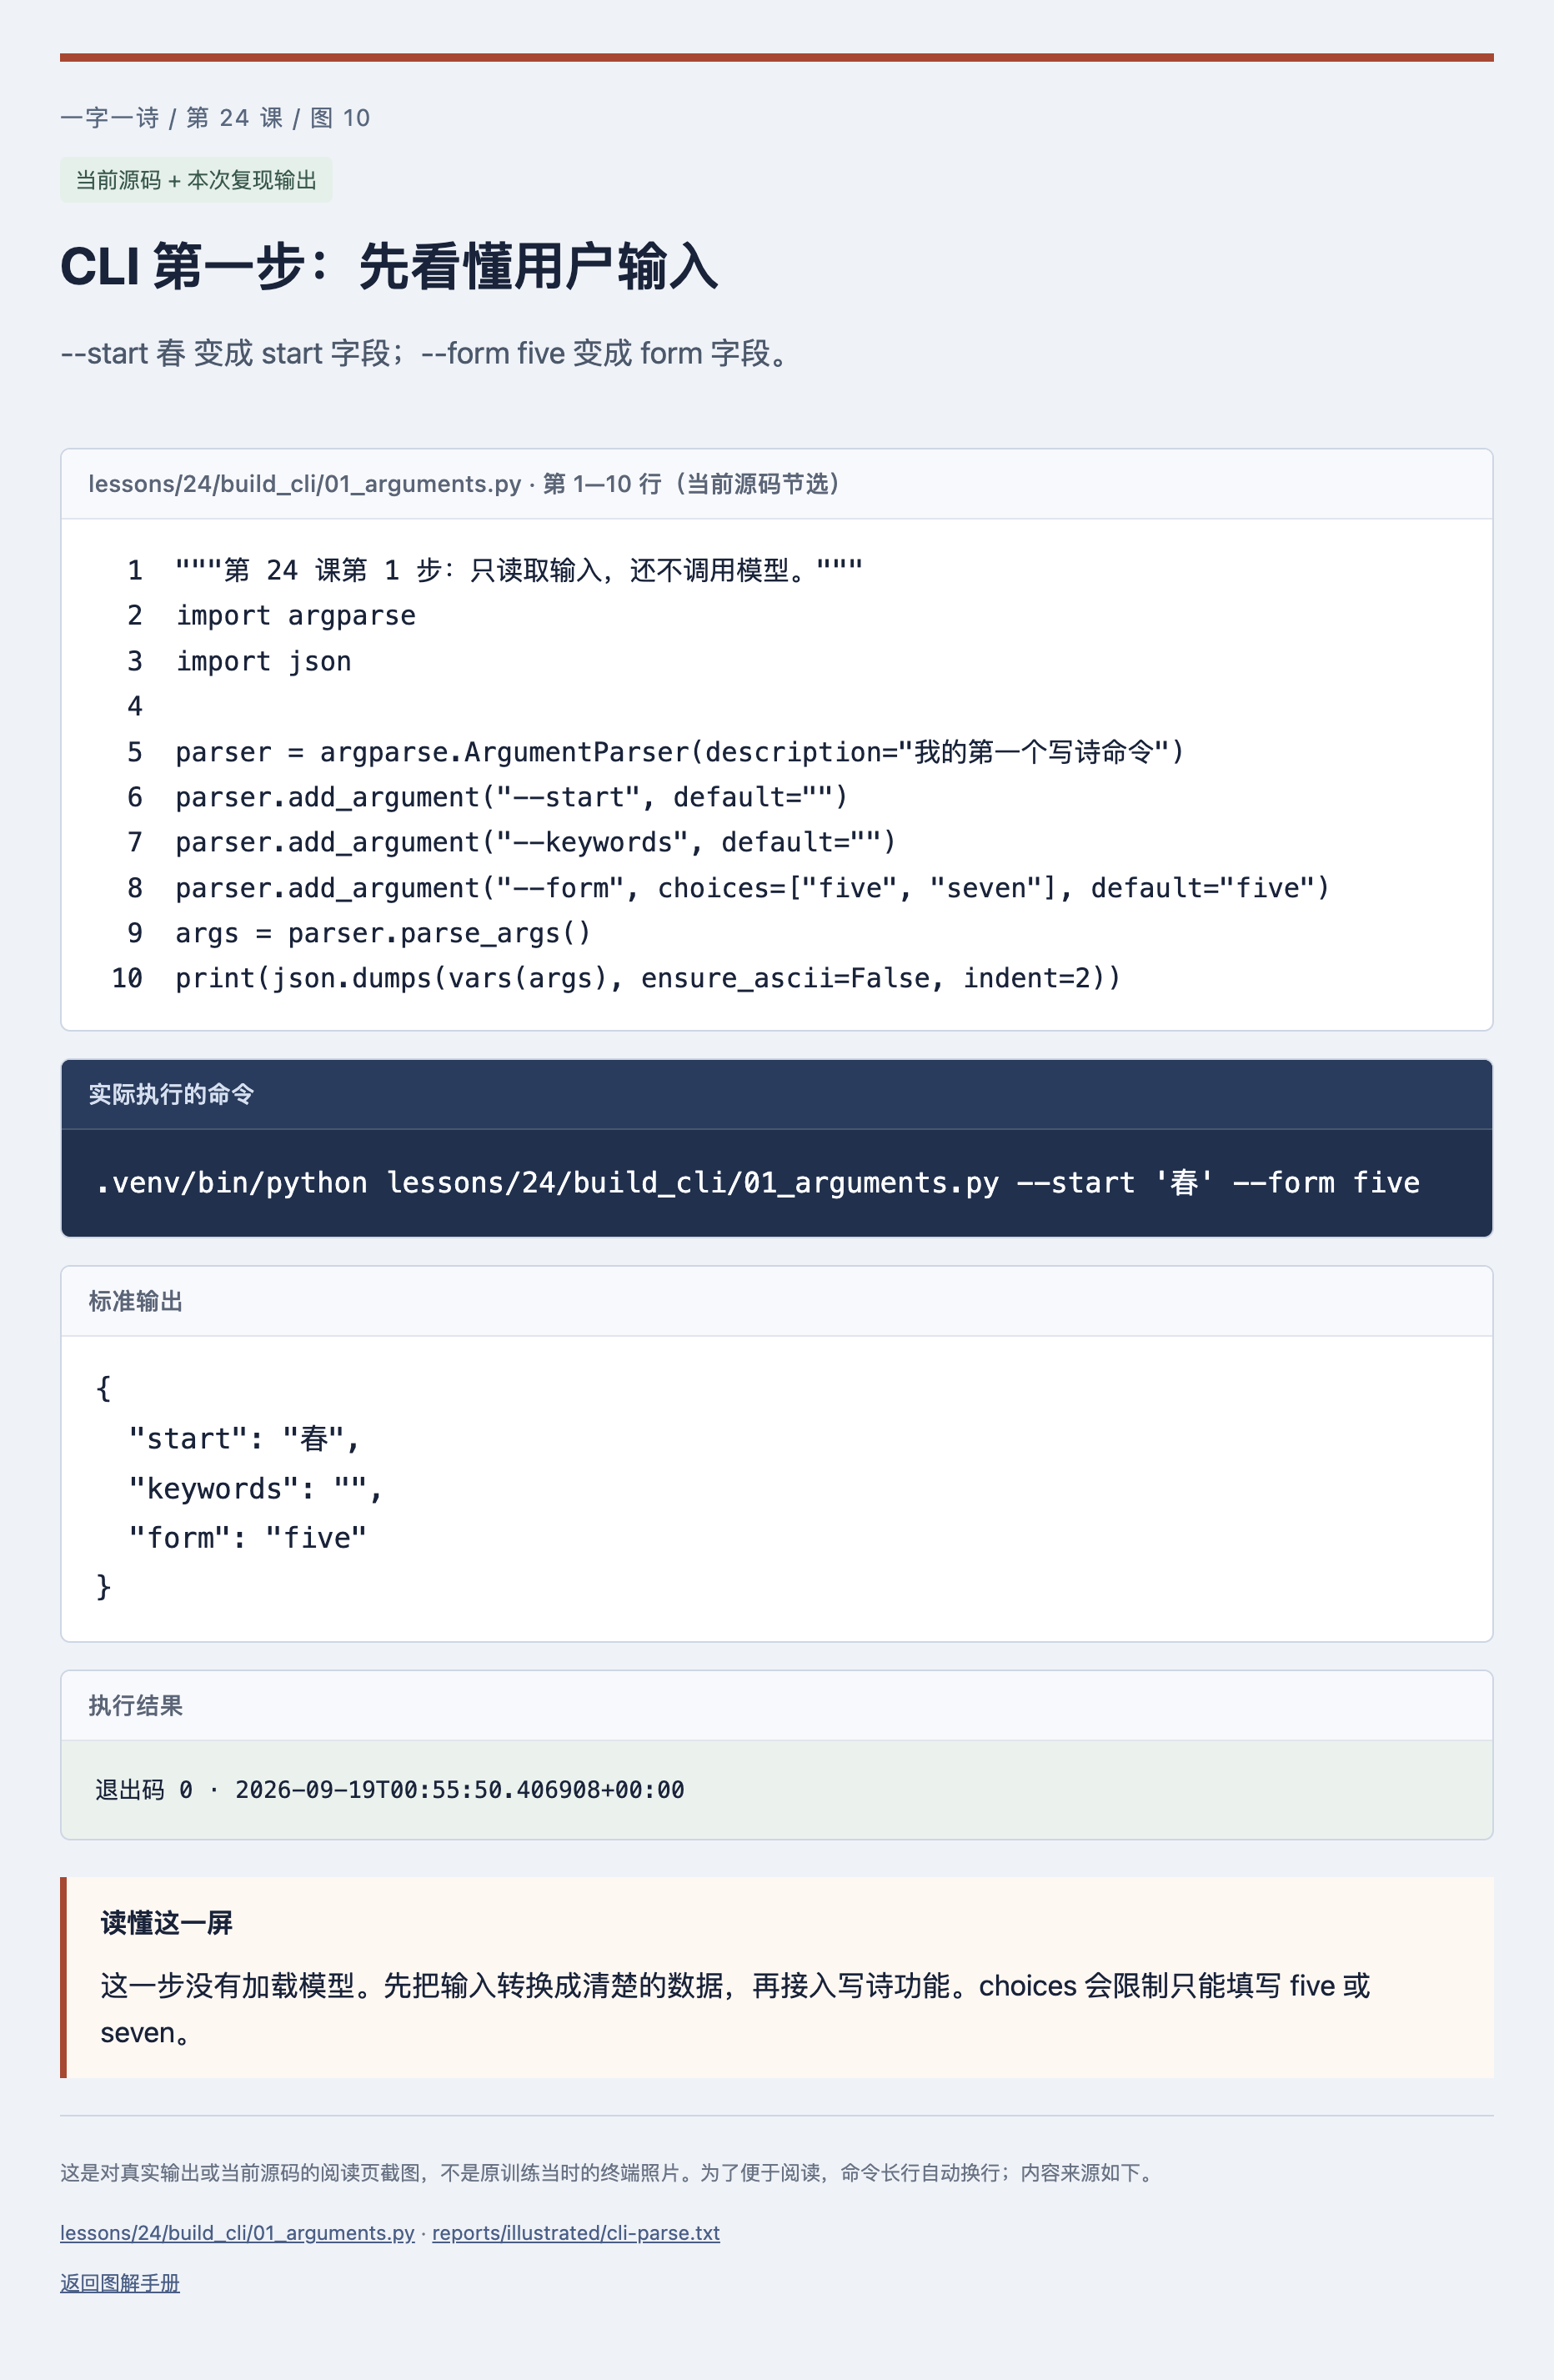
CLI 第一步:先看懂用户输入
- 先看哪里
- --start 春 变成 start 字段;--form five 变成 form 字段。
- 这说明什么
- 这一步没有加载模型。先把输入转换成清楚的数据,再接入写诗功能。choices 会限制只能填写 five 或 seven。
- 你接着做
- 先运行 01_arguments.py;把 five 换成 seven,再故意试试 eight,看帮助信息如何报错。
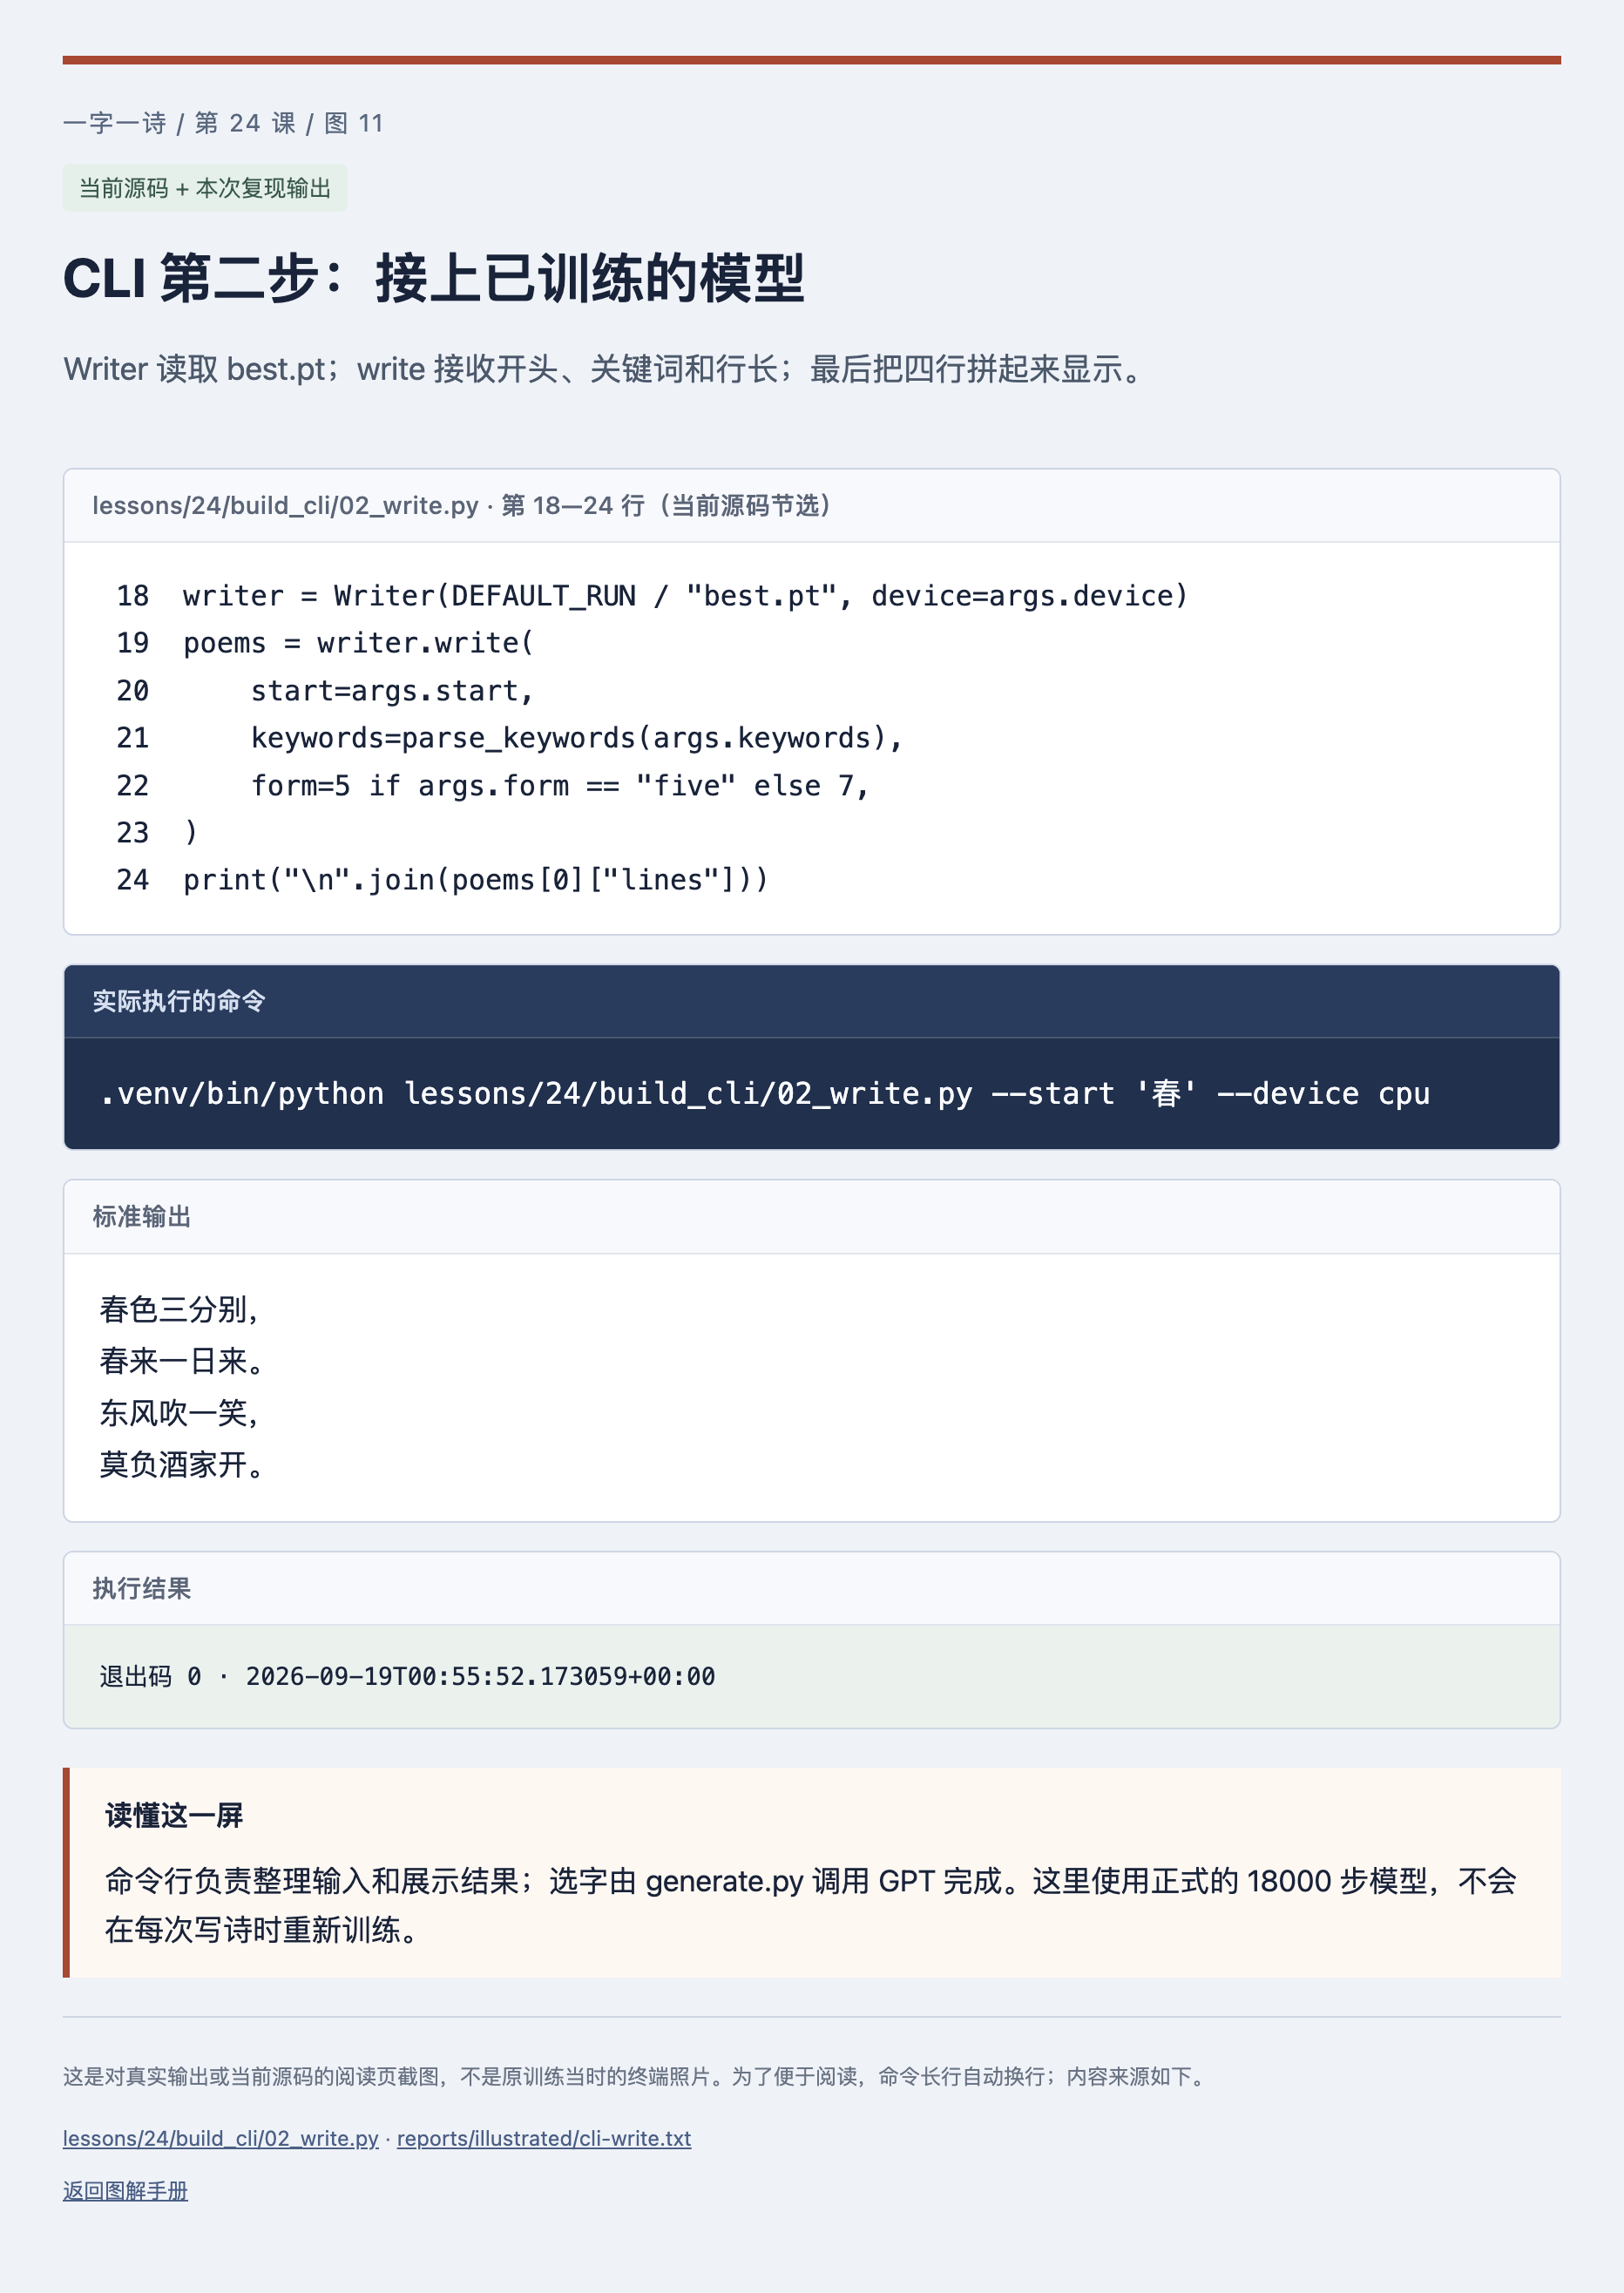
CLI 第二步:接上已训练的模型
- 先看哪里
- Writer 读取 best.pt;write 接收开头、关键词和行长;最后把四行拼起来显示。
- 这说明什么
- 命令行负责整理输入和展示结果;选字由 generate.py 调用 GPT 完成。这里使用正式的 18000 步模型,不会在每次写诗时重新训练。
- 你接着做
- 运行 02_write.py,再回到第 20—23 课核对逐字采样、固定字数和候选比较各自负责什么。
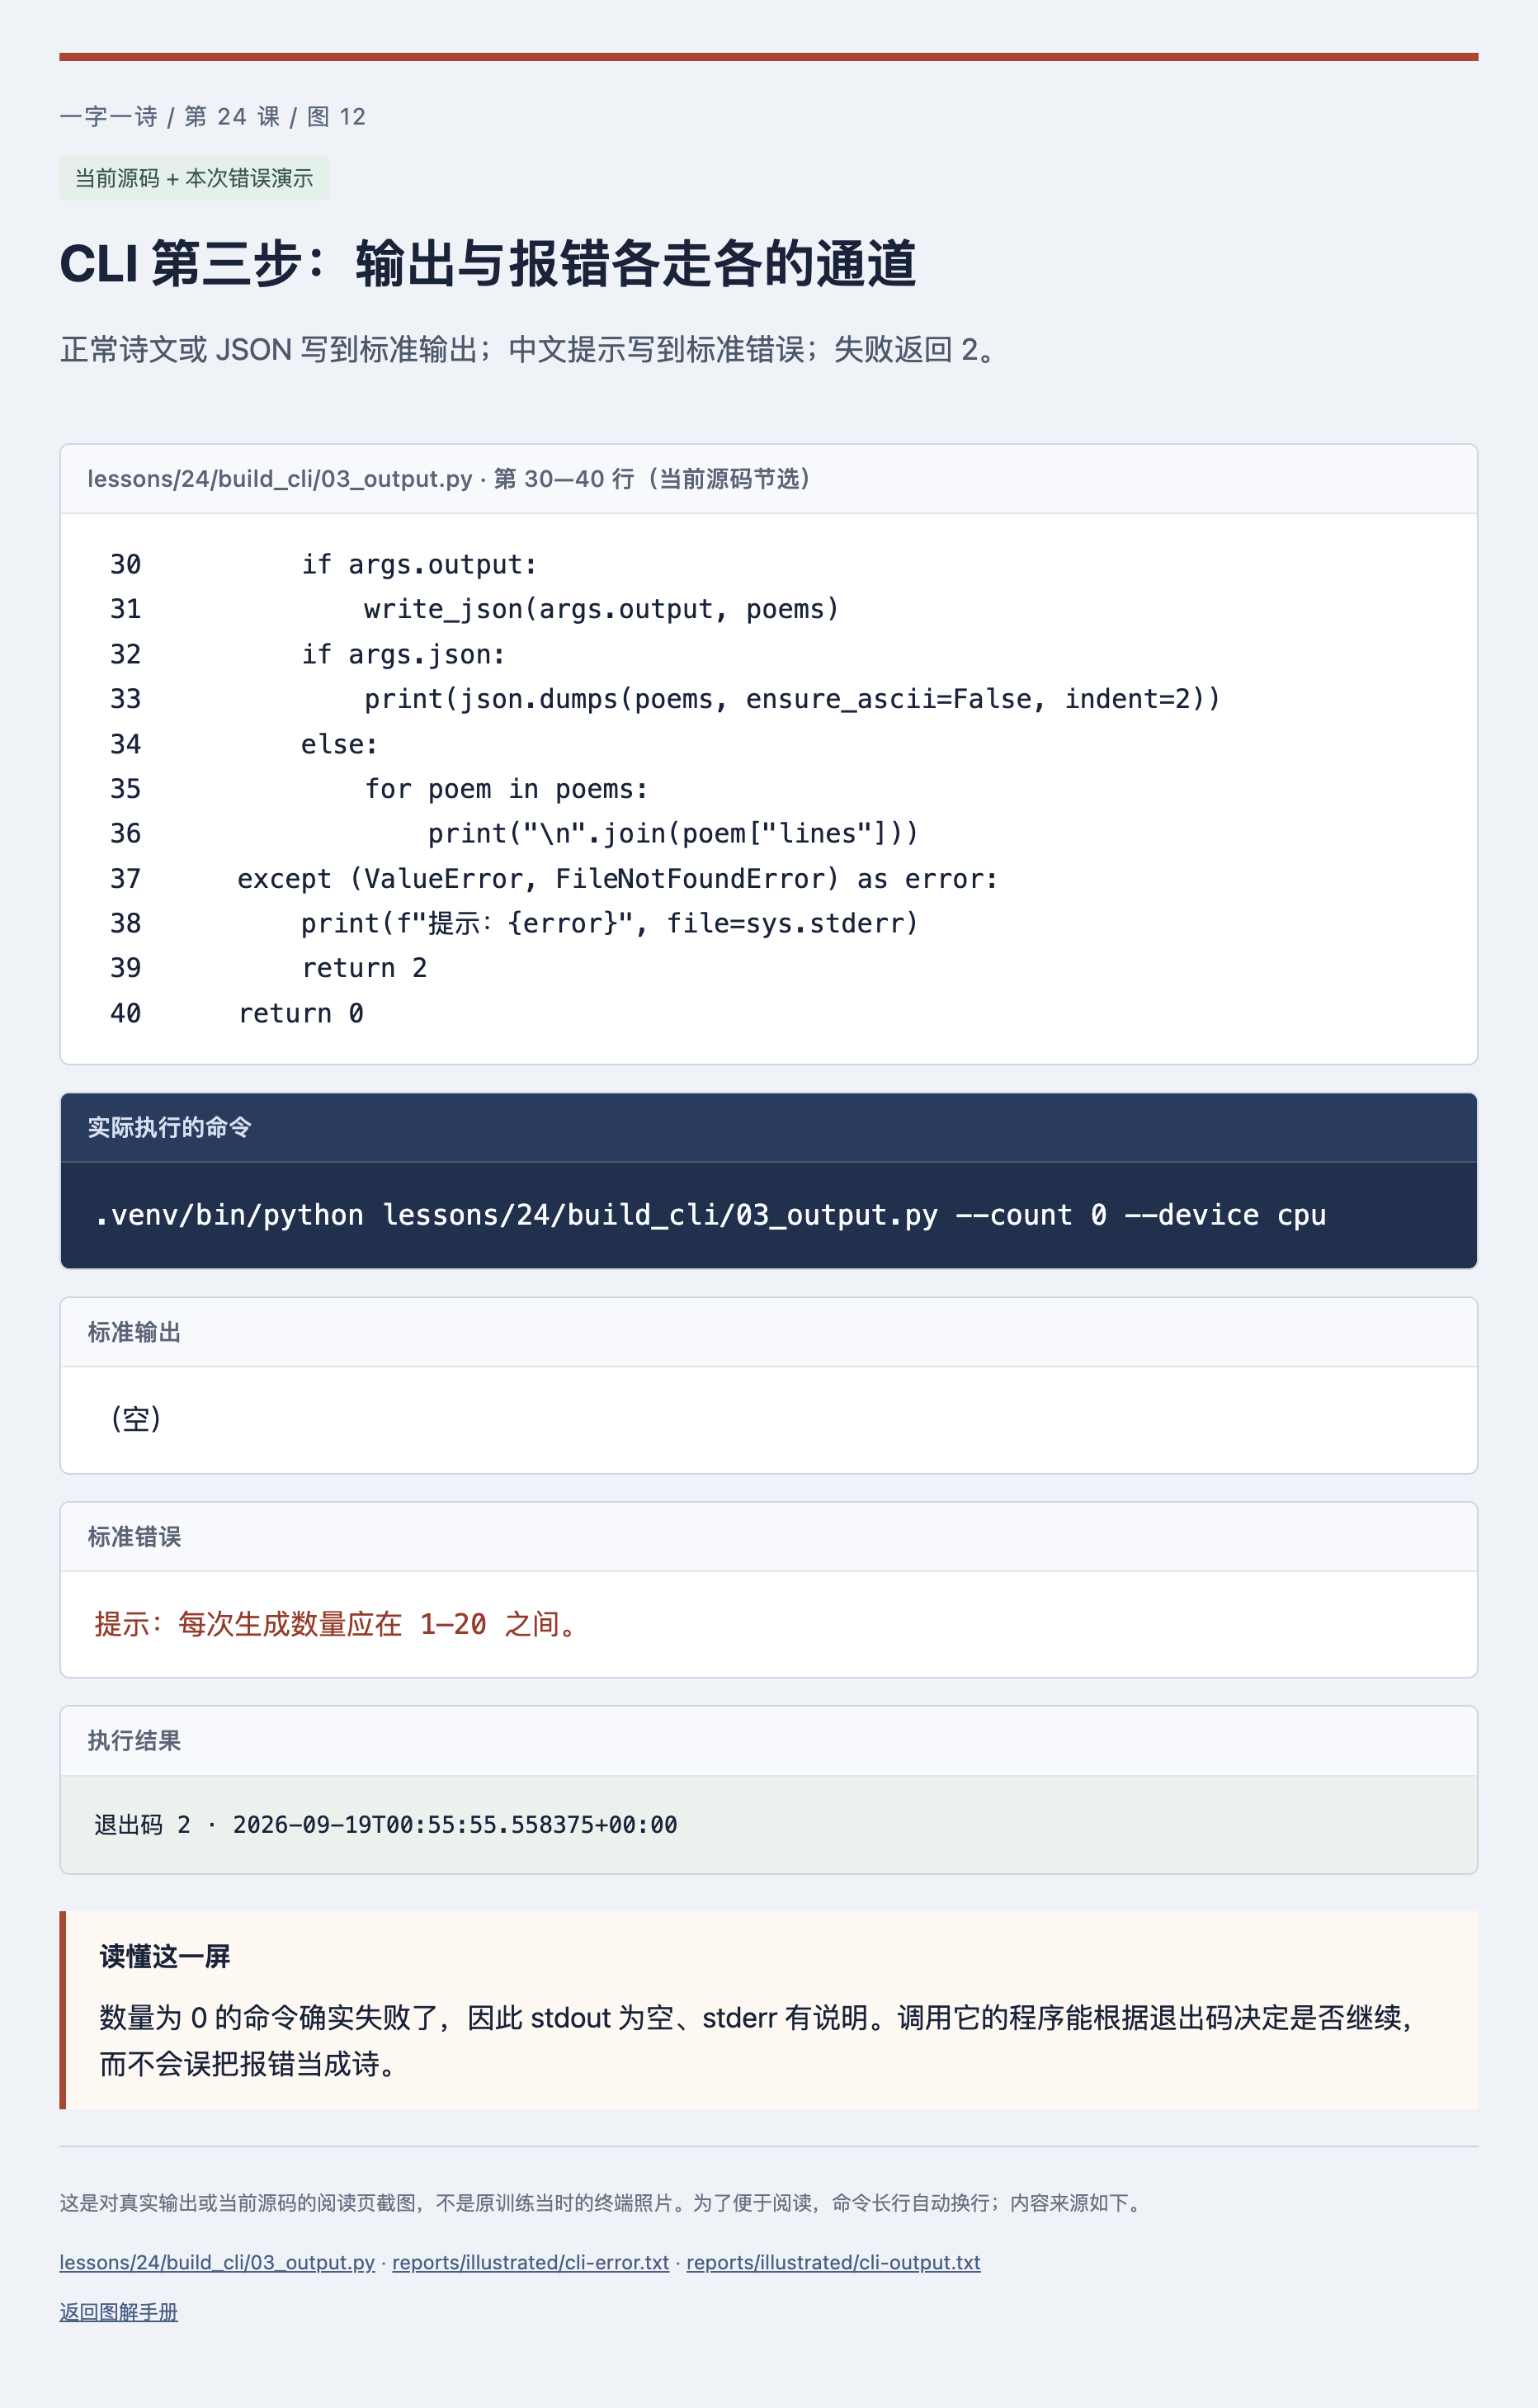
CLI 第三步:输出与报错各走各的通道
- 先看哪里
- 正常诗文或 JSON 写到标准输出;中文提示写到标准错误;失败返回 2。
- 这说明什么
- 数量为 0 的命令确实失败了,因此 stdout 为空、stderr 有说明。调用它的程序能根据退出码决定是否继续,而不会误把报错当成诗。
- 你接着做
- 运行 03_output.py 的 --json --output 示例;再运行 --count 0,对比两次的输出和退出码。
有了一个能写诗的小脚本,再学习如何接上 train、evaluate、chat 等命令,最后通过启动入口把它交给使用者。
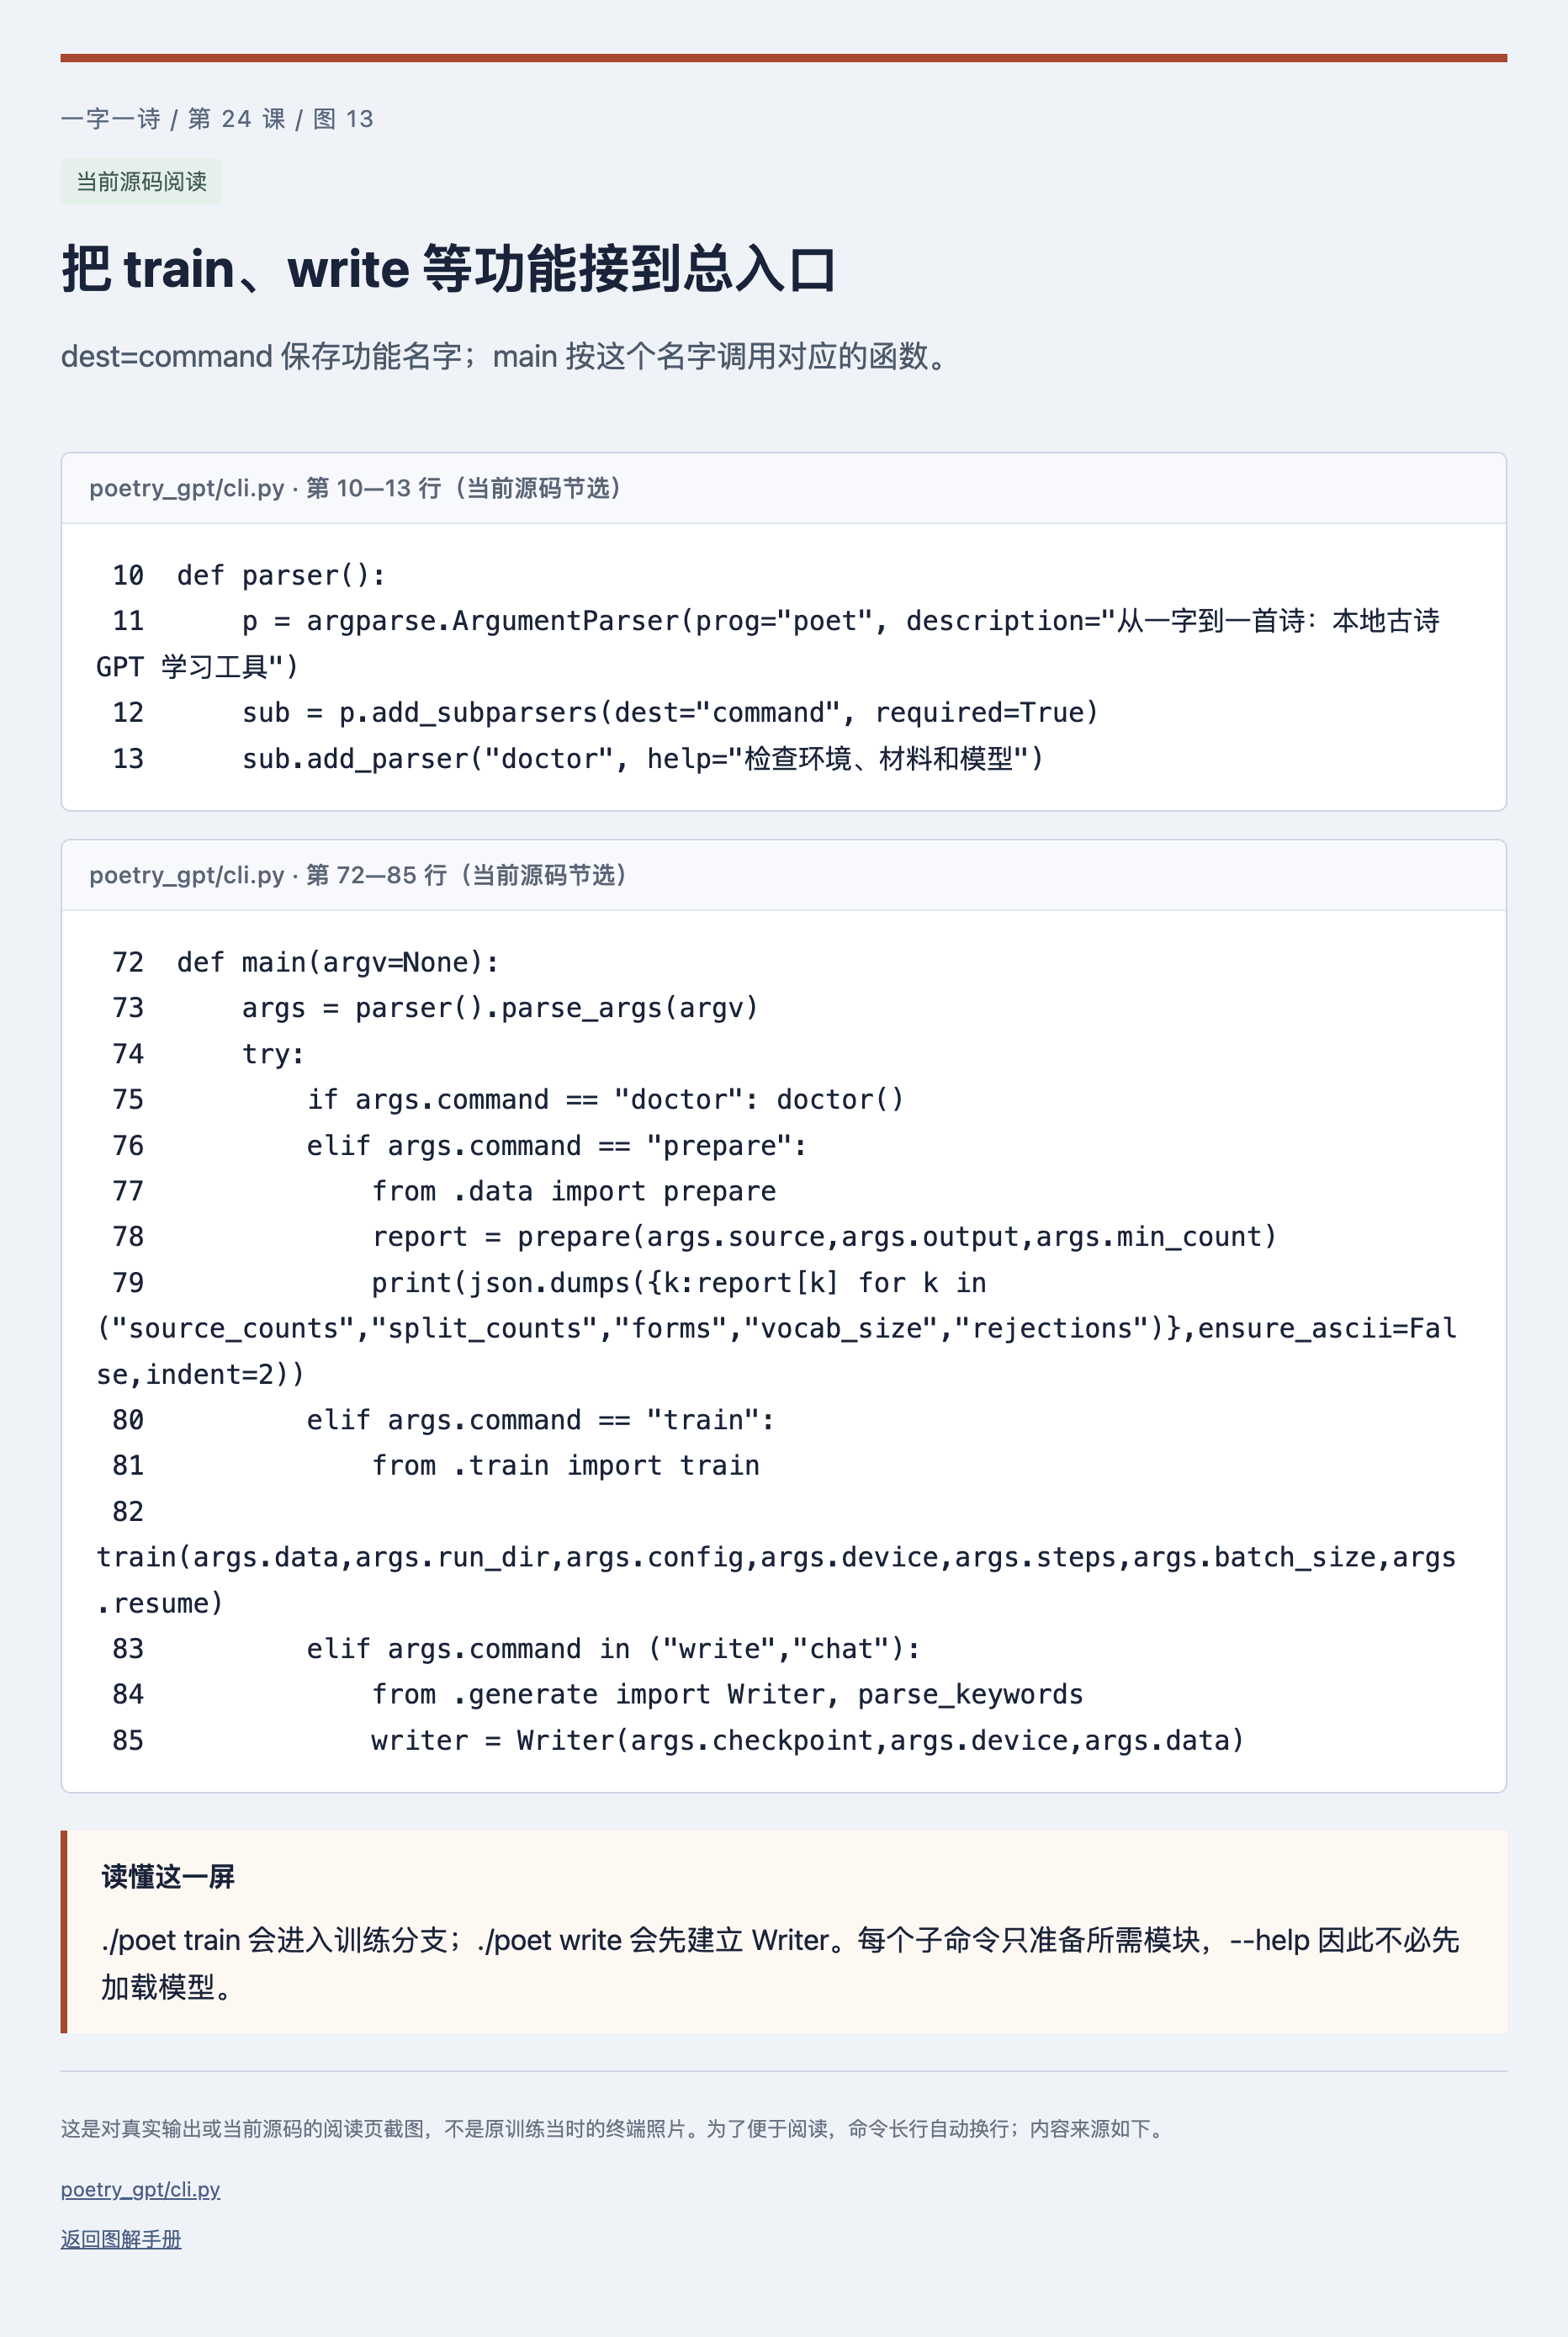
把 train、write 等功能接到总入口
- 先看哪里
- dest=command 保存功能名字;main 按这个名字调用对应的函数。
- 这说明什么
- ./poet train 会进入训练分支;./poet write 会先建立 Writer。每个子命令只准备所需模块,--help 因此不必先加载模型。
- 你接着做
- 用第 24 课的功能对照表,从 parser 的参数一路找到 main 对应分支,再打开被调用的实现文件。
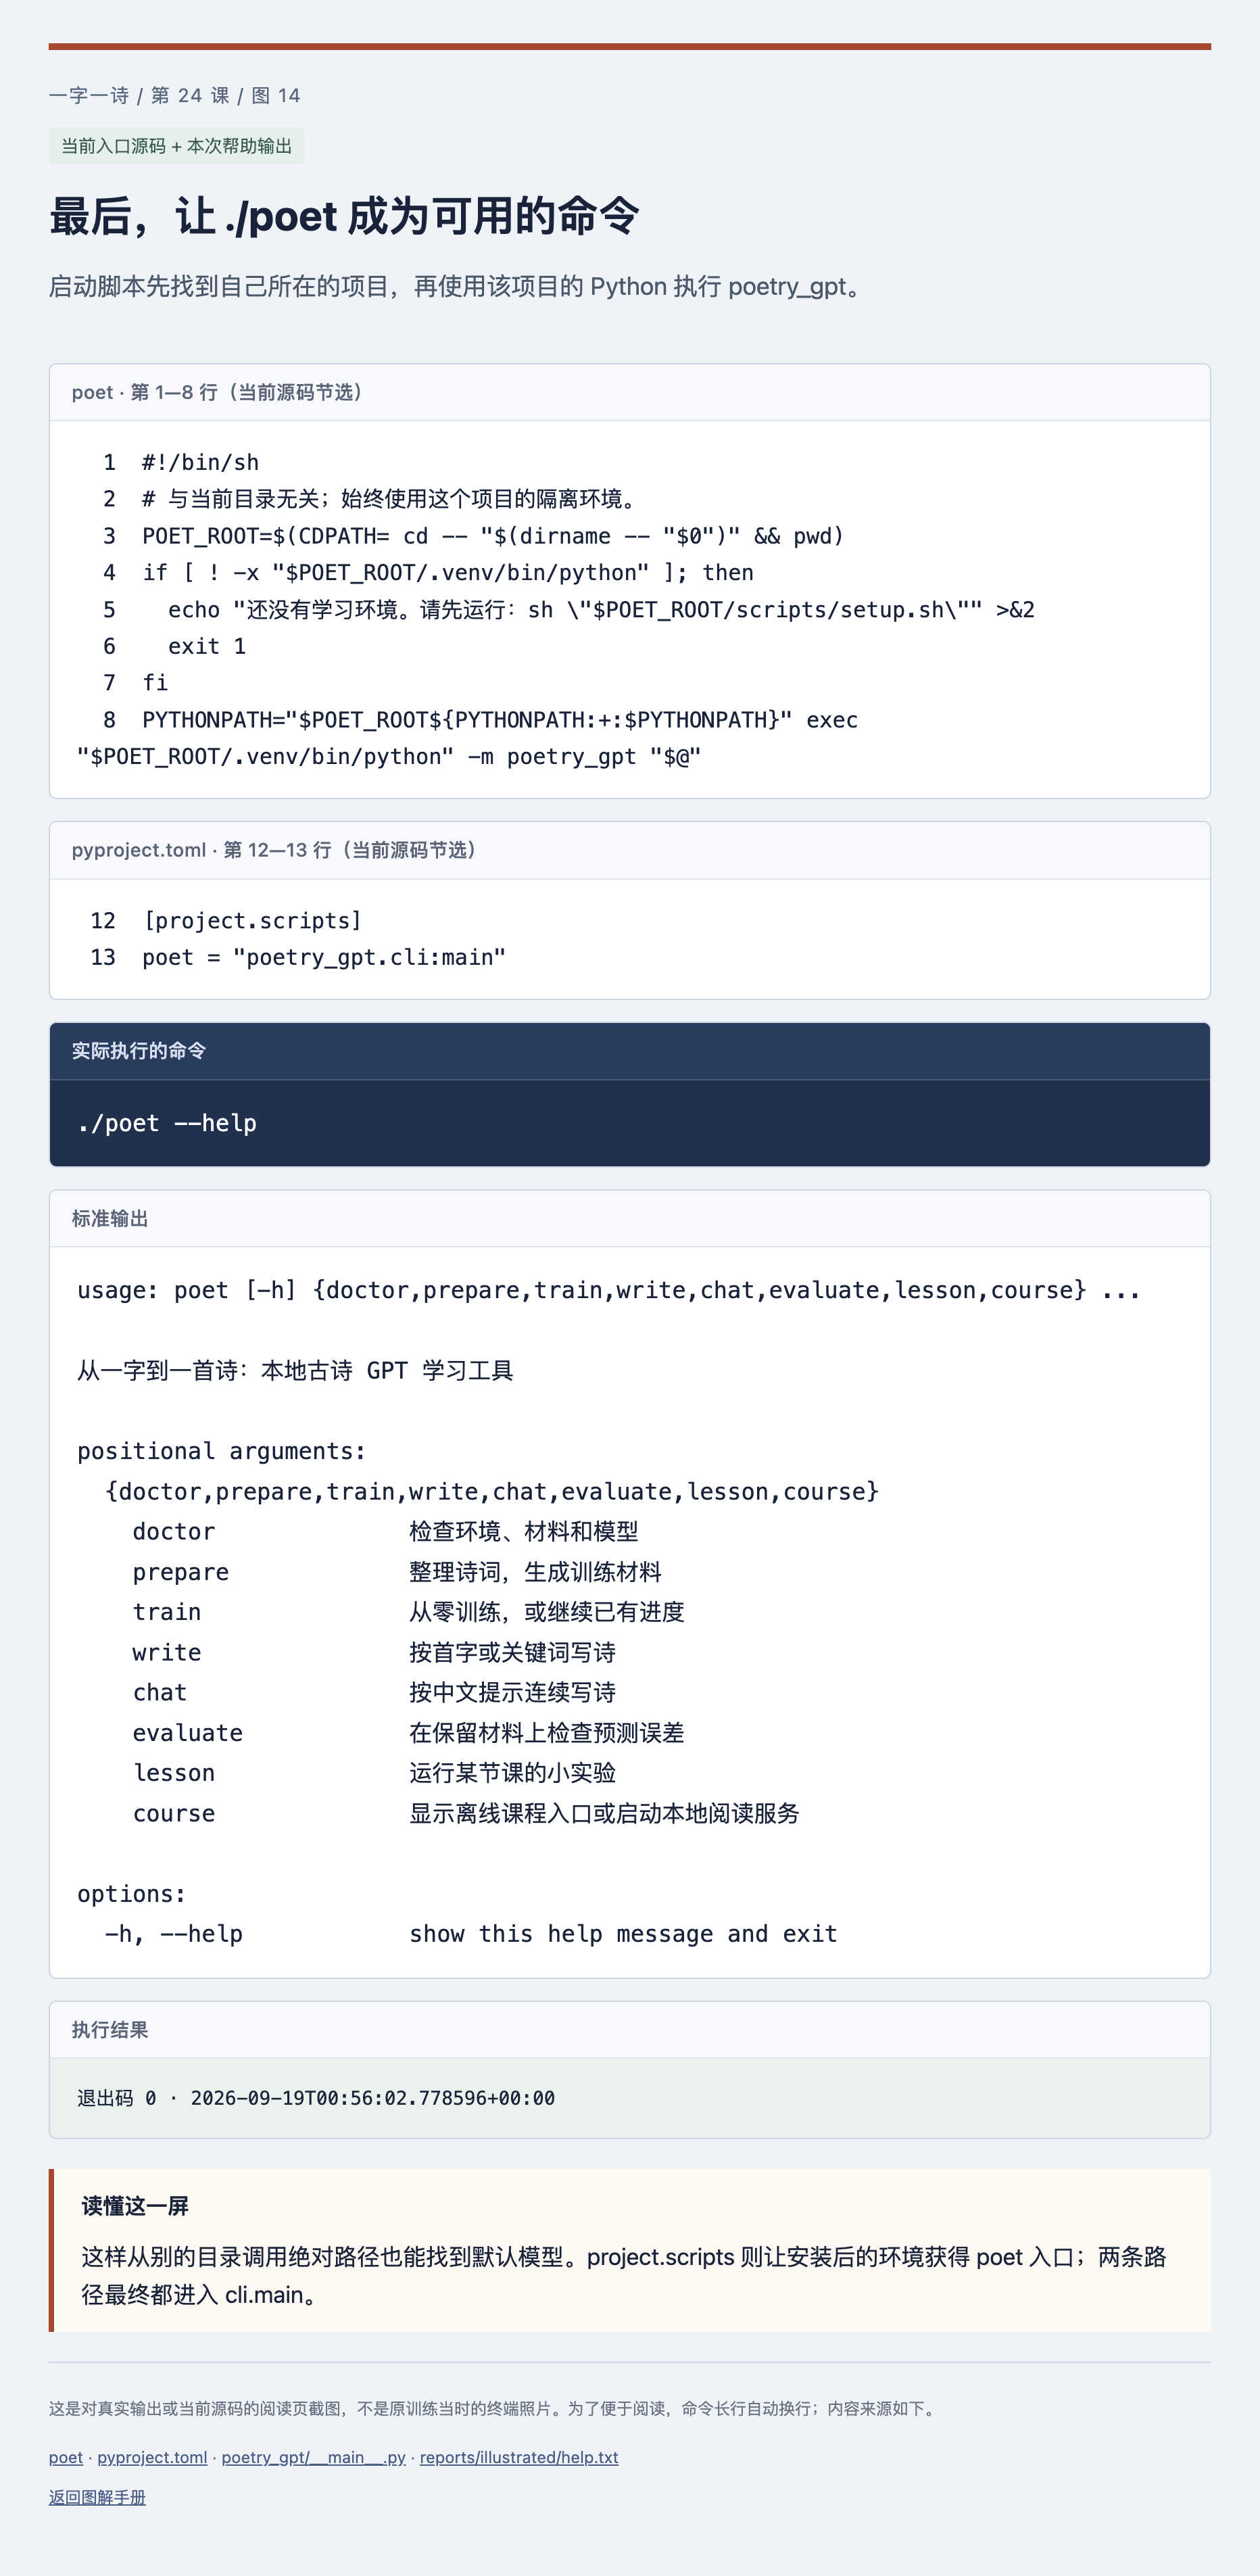
最后,让 ./poet 成为可用的命令
- 先看哪里
- 启动脚本先找到自己所在的项目,再使用该项目的 Python 执行 poetry_gpt。
- 这说明什么
- 这样从别的目录调用绝对路径也能找到默认模型。project.scripts 则让安装后的环境获得 poet 入口;两条路径最终都进入 cli.main。
- 你接着做
- 运行 ./poet --help,再运行 ./poet write --help。帮助列出的每一项都应该能在 parser 找到。
⑤ 核对首字、关键词、报错与连续输入
外形正确不代表语义流畅,查重通过也不代表所有表达都是全新的。以下保留本次固定输入的实际结果,用来示范怎样检查,而不把每首诗都当作合格成品。
./poet write --start 春 --form five --seed 2026 --device cpu
./poet write --keywords 秋雨,故乡 --form seven --json --seed 2026 --device cpu
# 故意输错:应出现中文提示,返回码为 2
./poet write --count 0 --device cpu
./poet chat --device cpu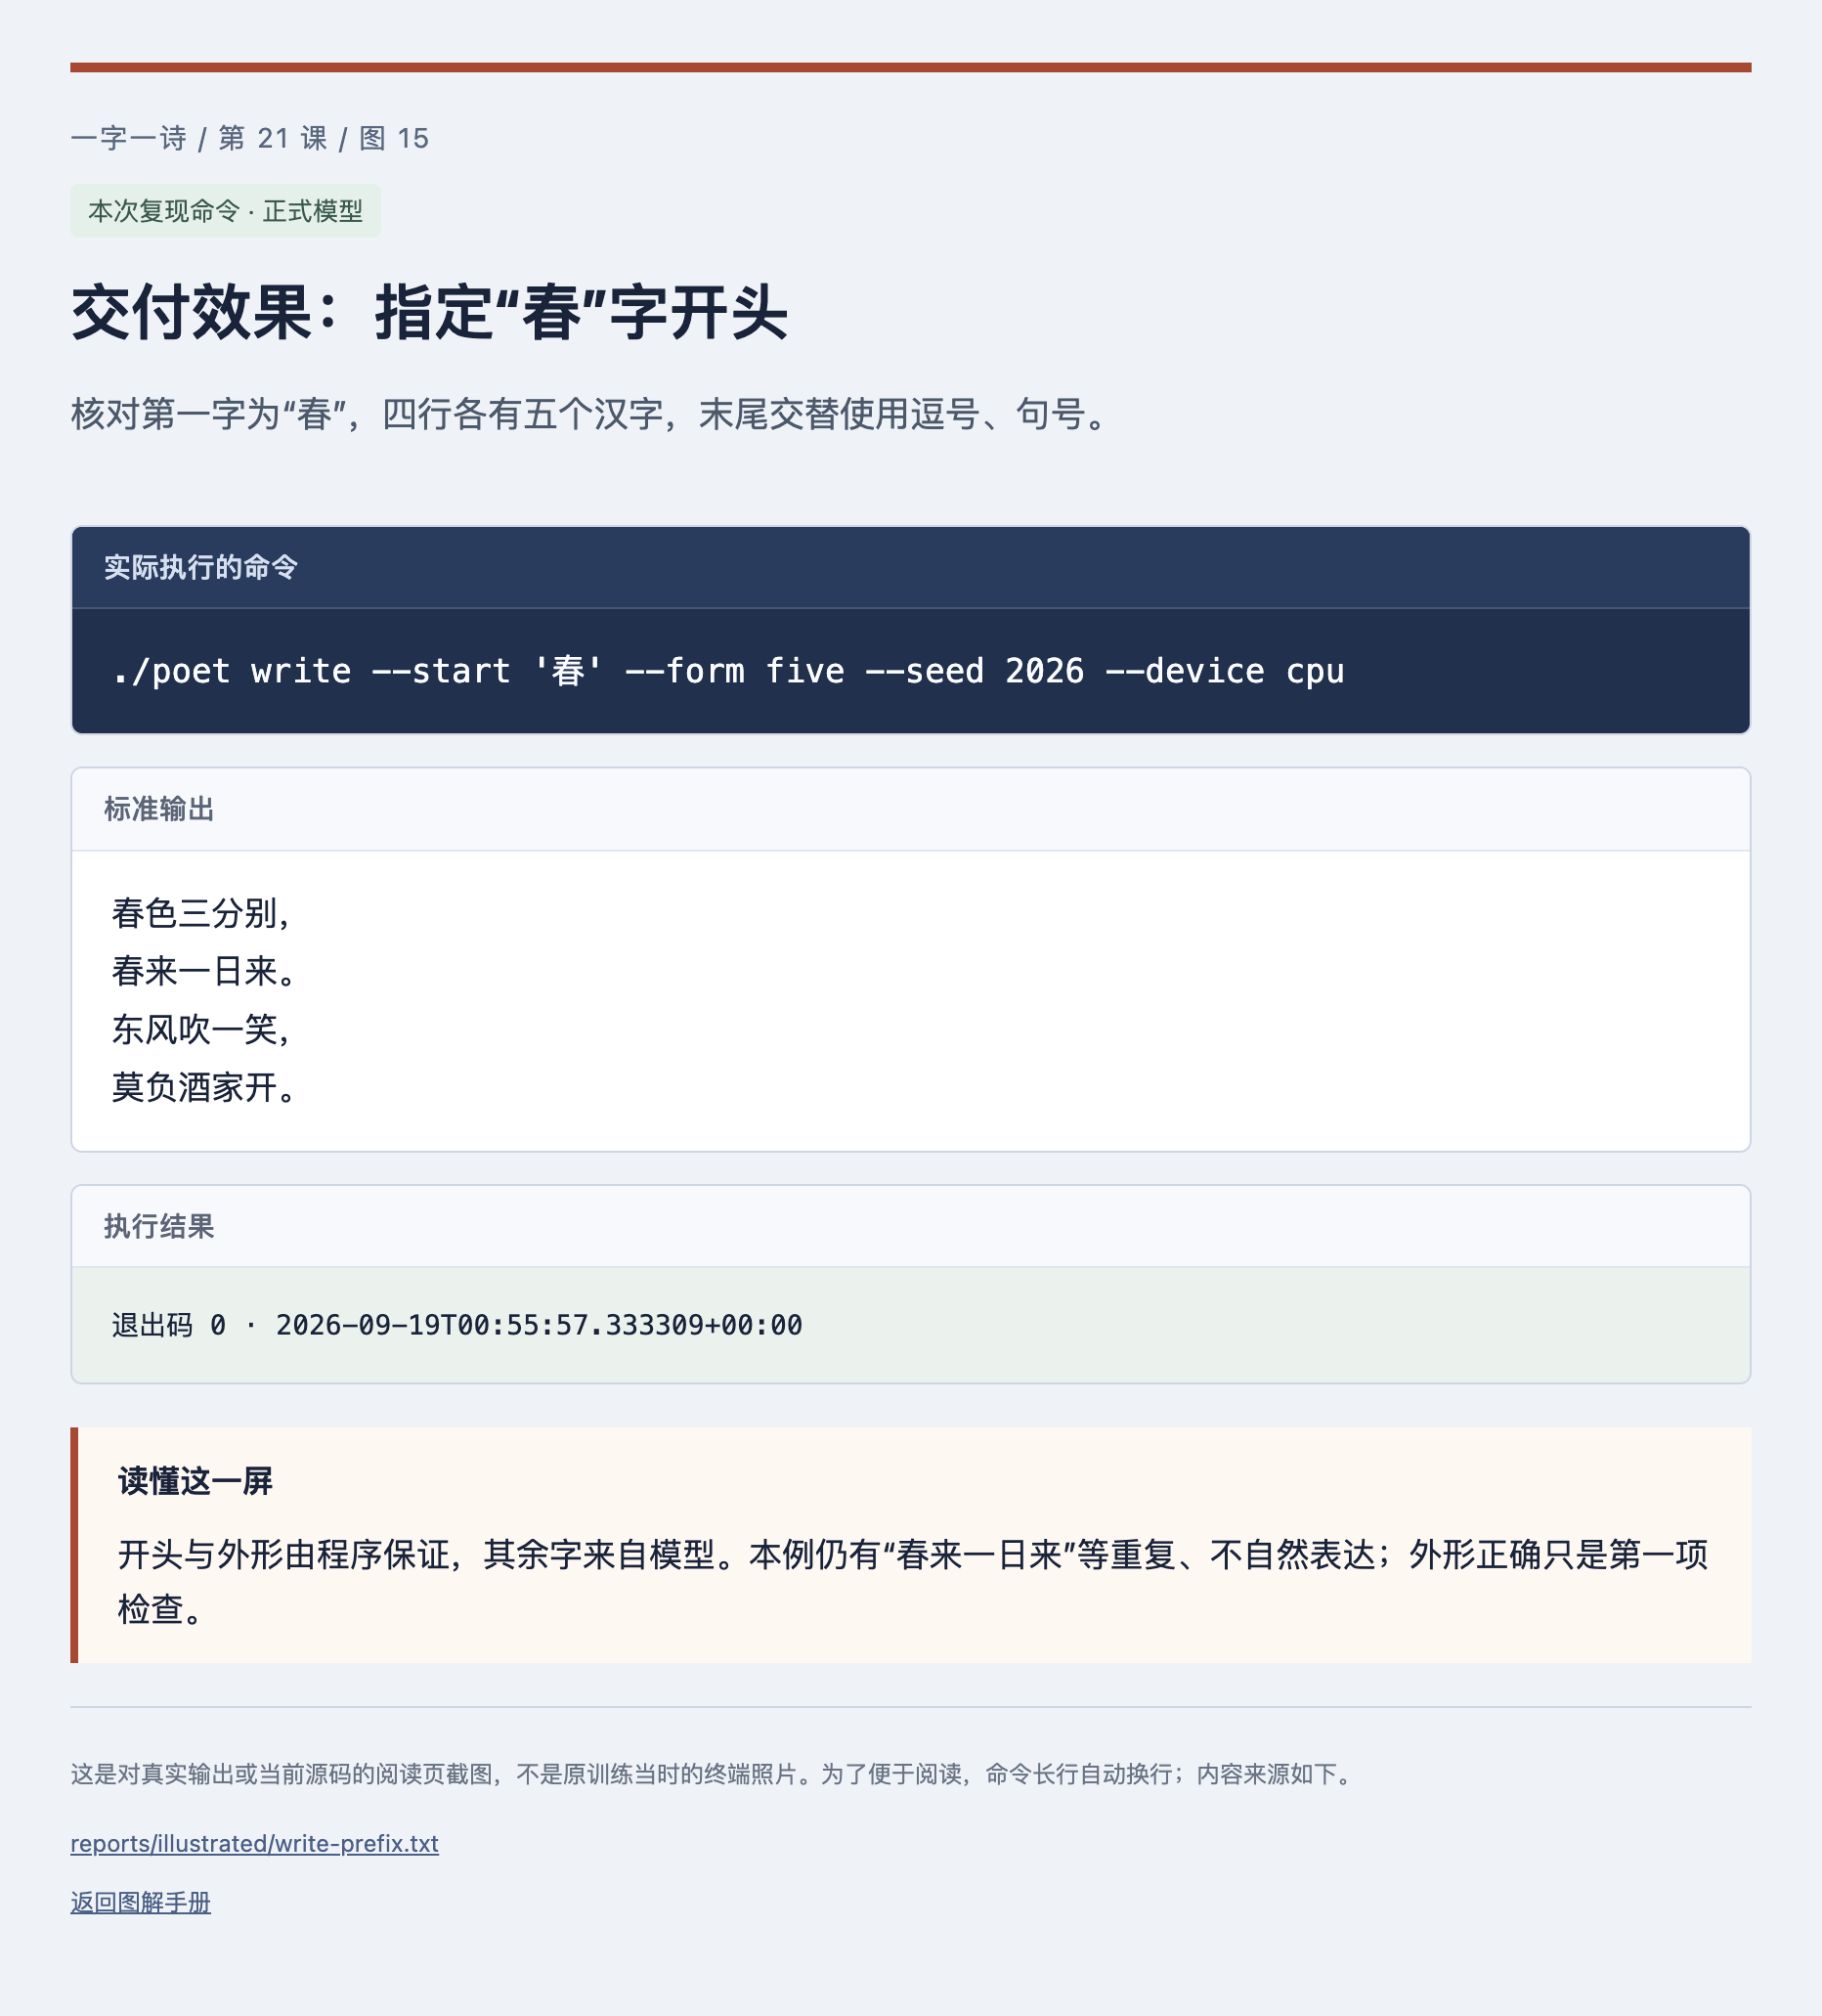
交付效果:指定“春”字开头
- 先看哪里
- 核对第一字为“春”,四行各有五个汉字,末尾交替使用逗号、句号。
- 这说明什么
- 开头与外形由程序保证,其余字来自模型。本例仍有“春来一日来”等重复、不自然表达;外形正确只是第一项检查。
- 你接着做
- 换一个常见开头,检查字数之后再用自己的话复述诗意;如果难以复述,就记为语义问题。
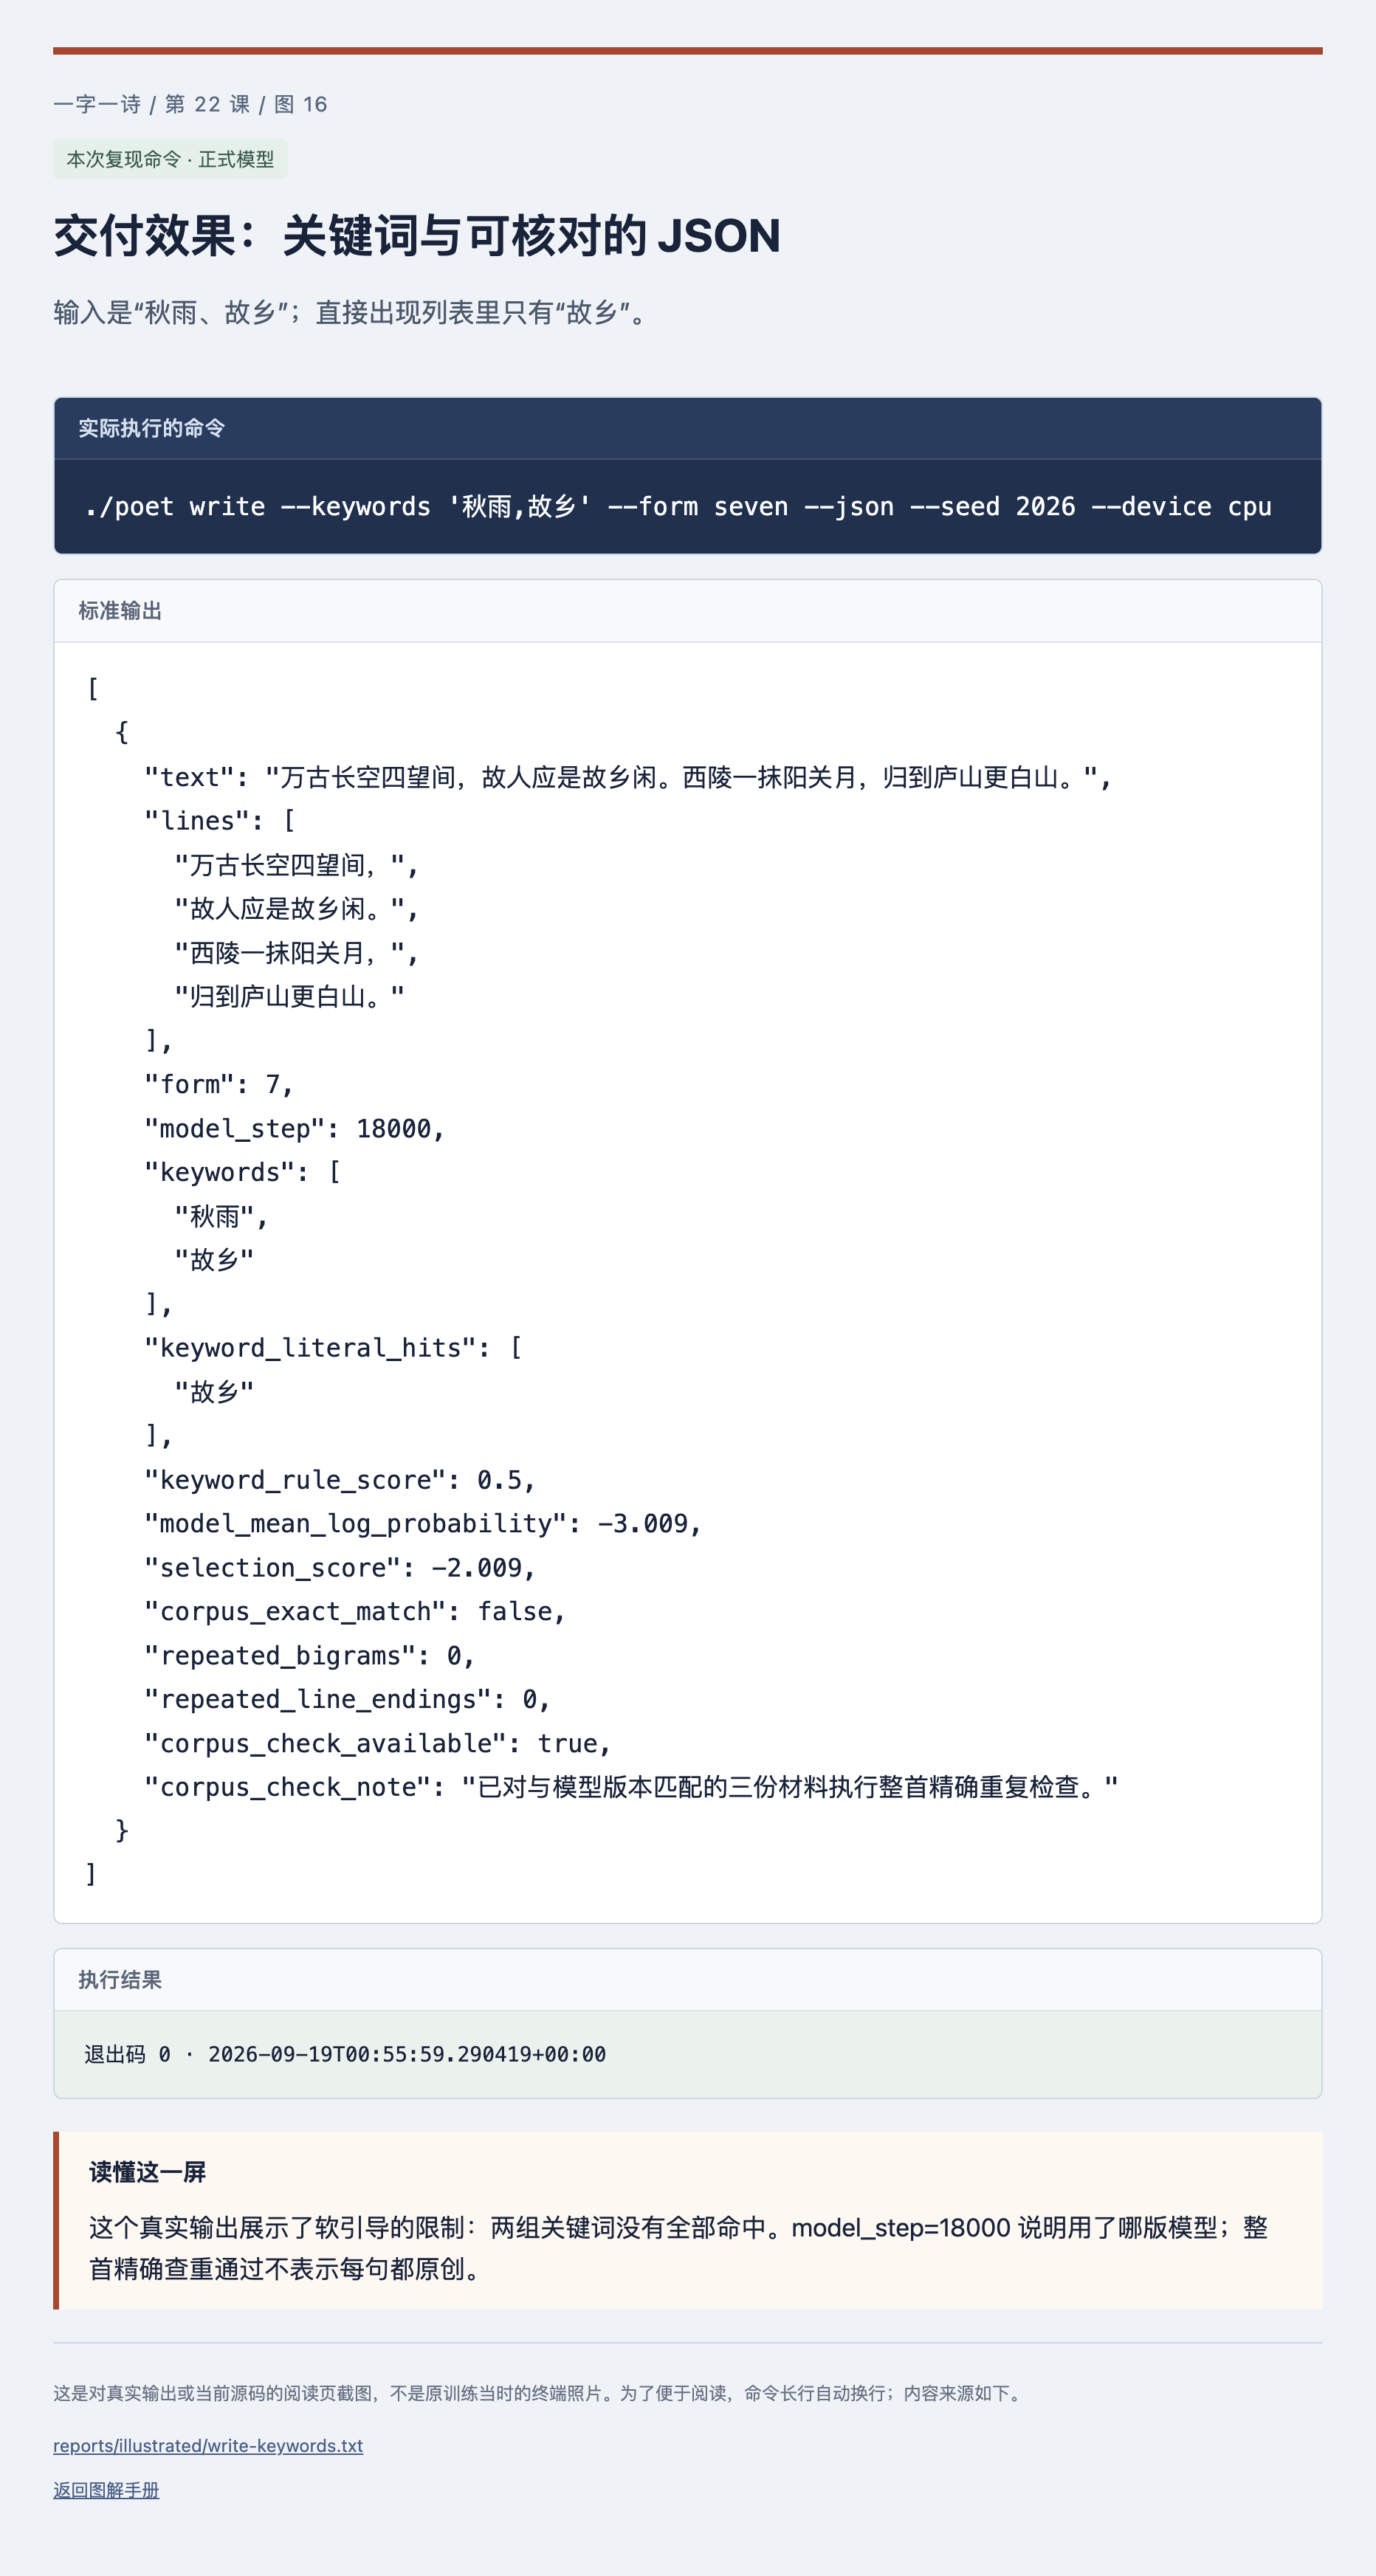
交付效果:关键词与可核对的 JSON
- 先看哪里
- 输入是“秋雨、故乡”;直接出现列表里只有“故乡”。
- 这说明什么
- 这个真实输出展示了软引导的限制:两组关键词没有全部命中。model_step=18000 说明用了哪版模型;整首精确查重通过不表示每句都原创。
- 你接着做
- 对照 keywords 与 keyword_literal_hits,分别记录外形、主题、重复、语义,不要把 selection_score 当成人工诗歌评分。
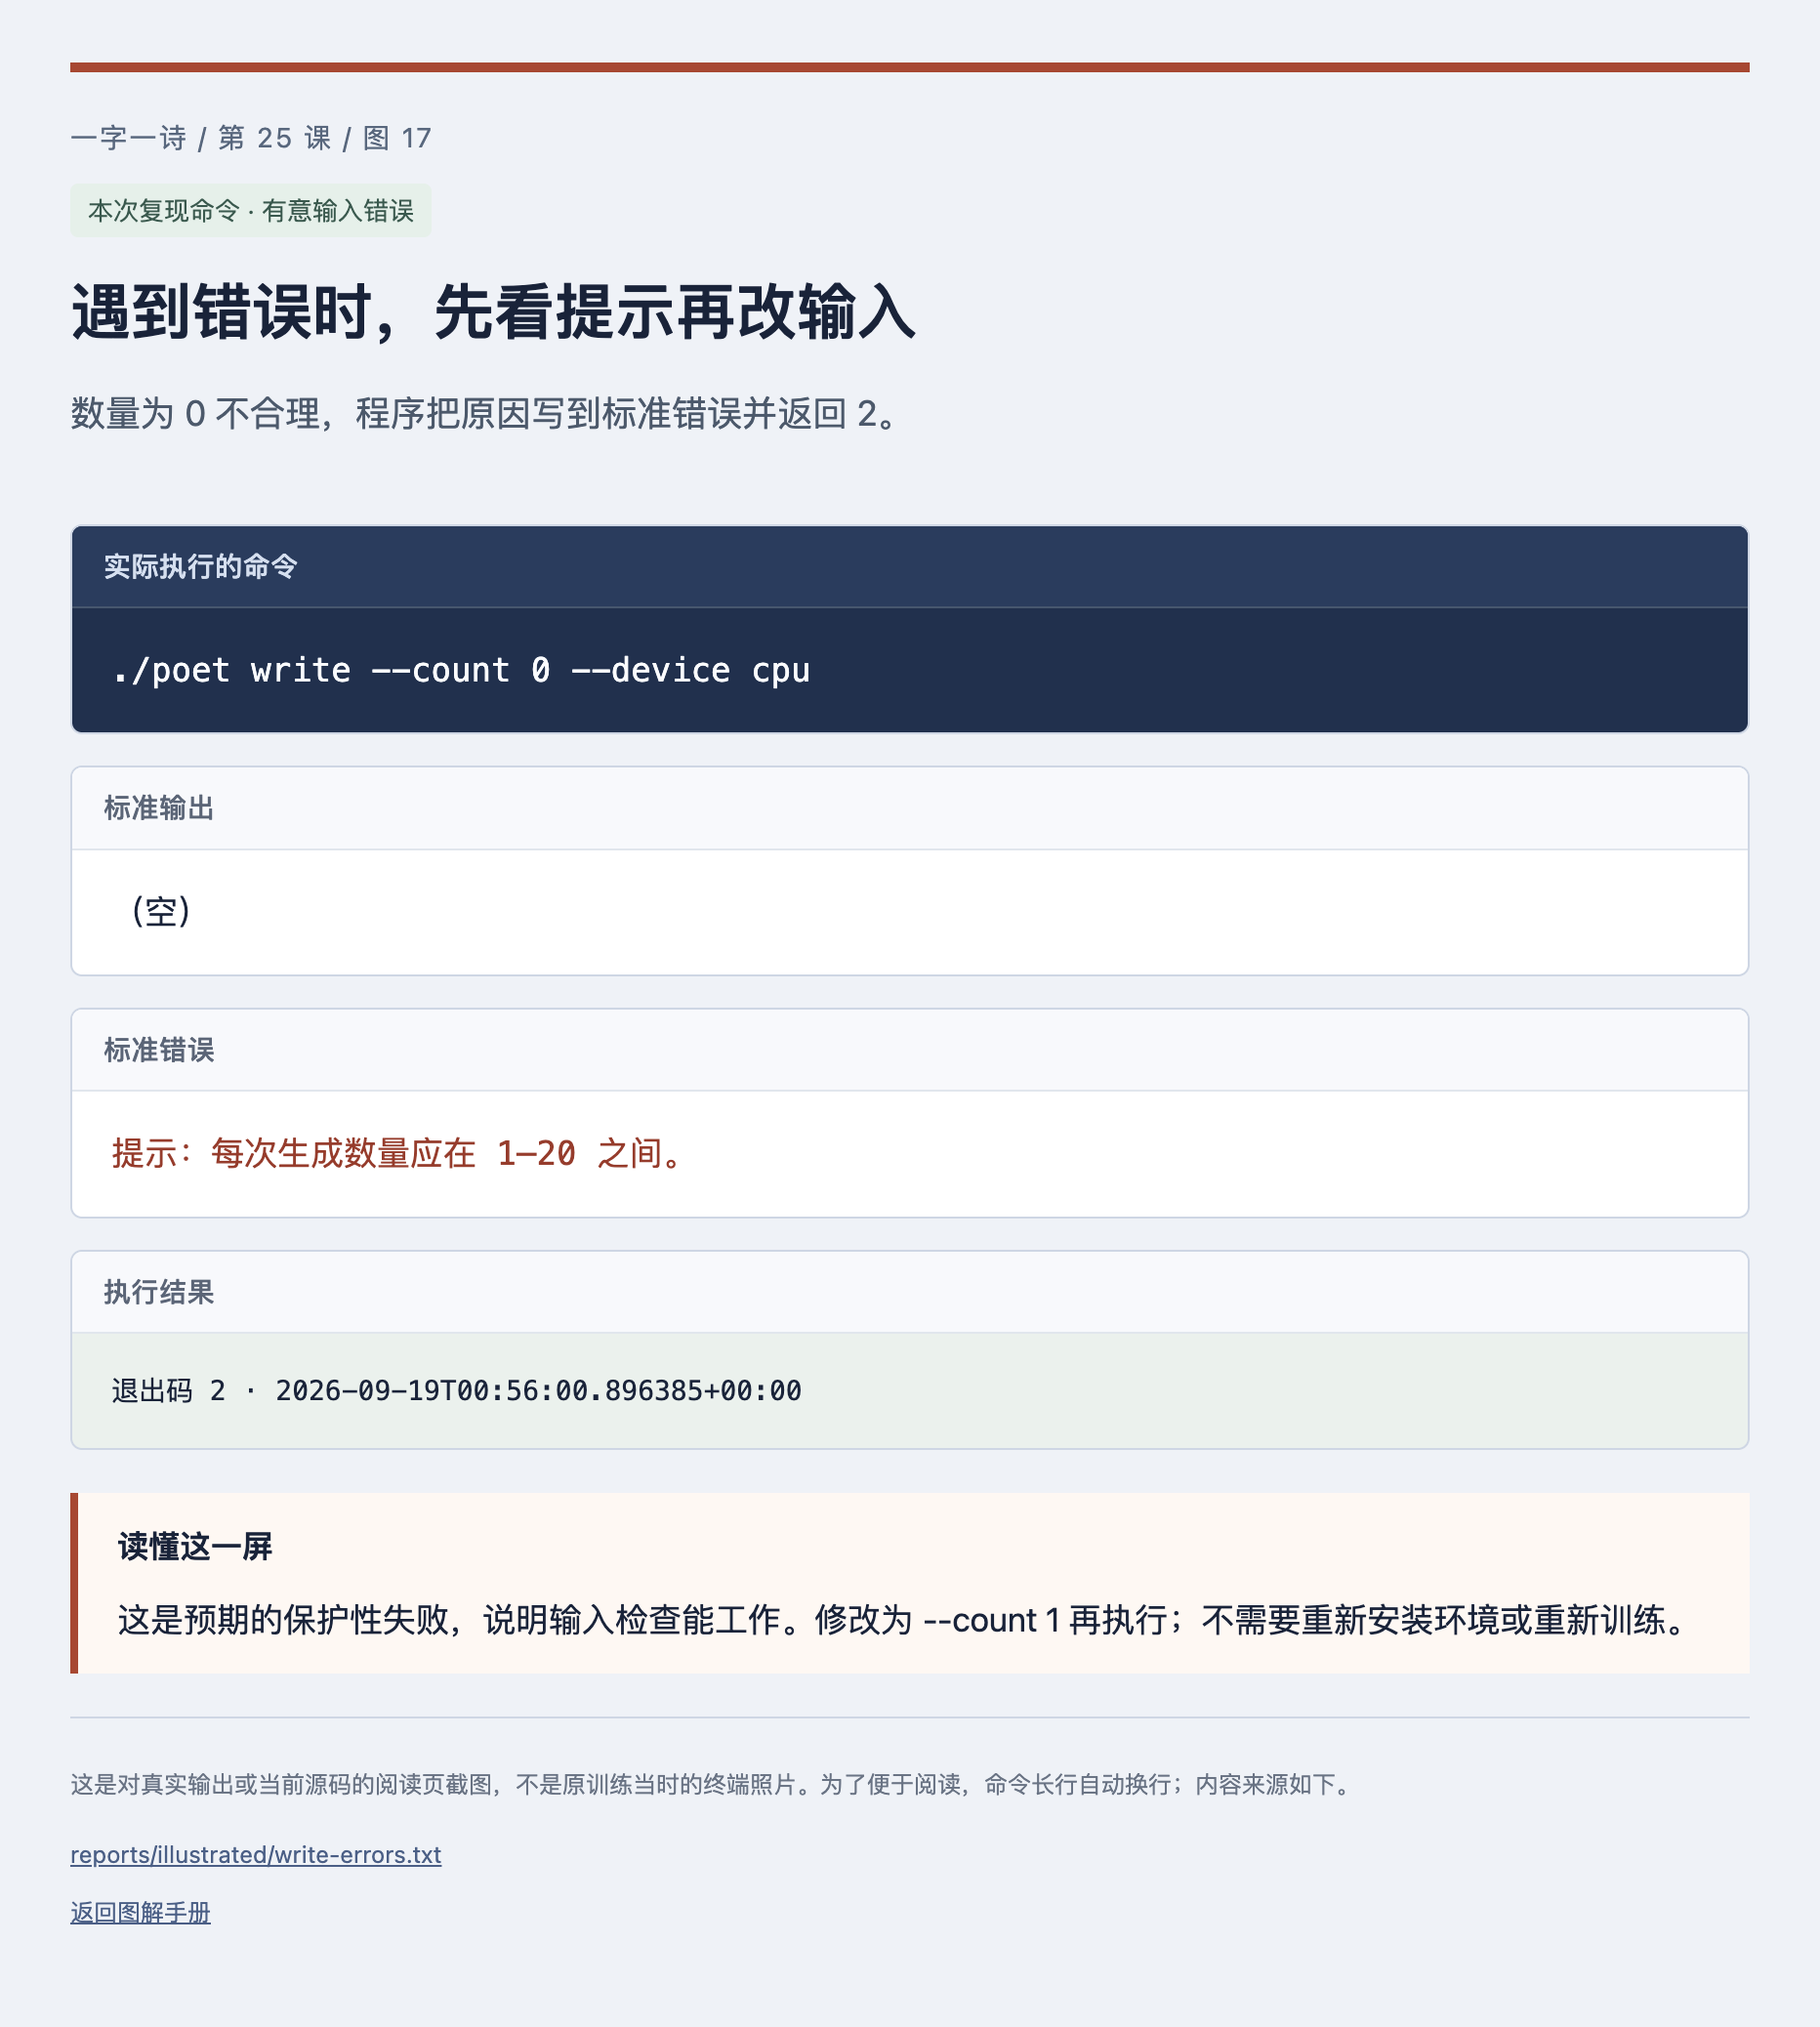
遇到错误时,先看提示再改输入
- 先看哪里
- 数量为 0 不合理,程序把原因写到标准错误并返回 2。
- 这说明什么
- 这是预期的保护性失败,说明输入检查能工作。修改为 --count 1 再执行;不需要重新安装环境或重新训练。
- 你接着做
- 也可以用 --form eight 练习识别参数错误。先读提示中的具体字段,避免盲目重跑长训练。
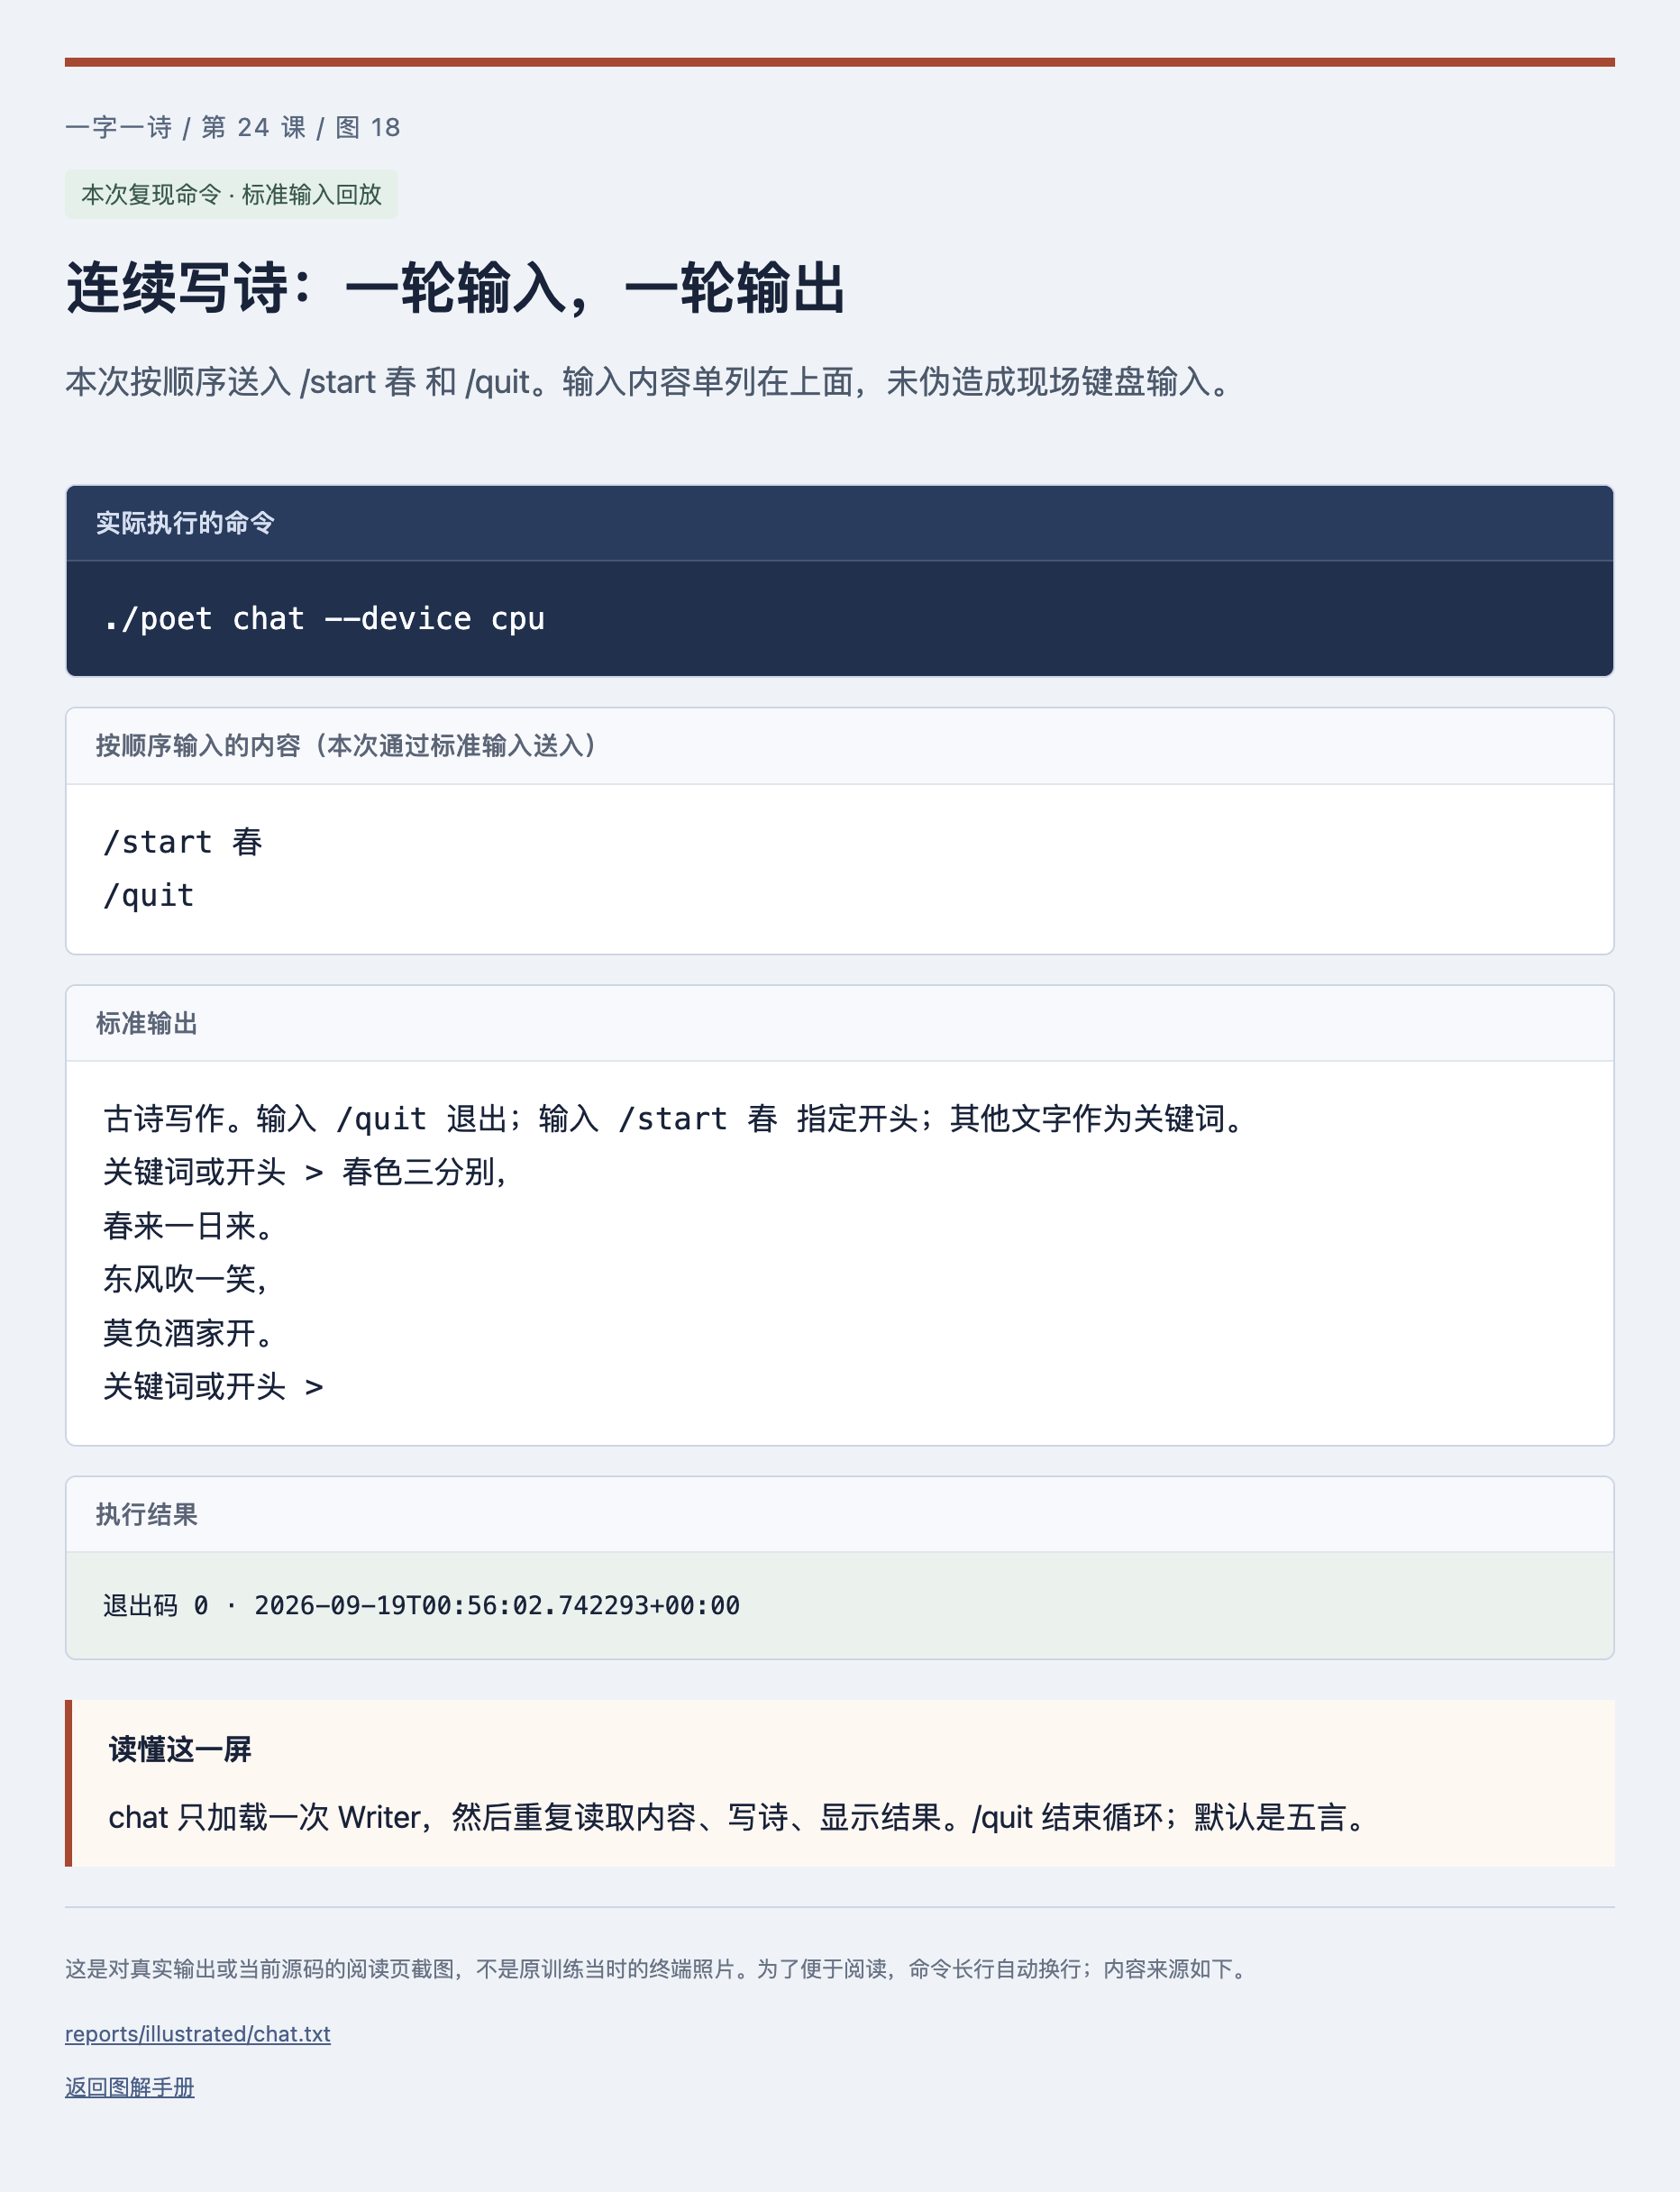
连续写诗:一轮输入,一轮输出
- 先看哪里
- 本次按顺序送入 /start 春 和 /quit。输入内容单列在上面,未伪造成现场键盘输入。
- 这说明什么
- chat 只加载一次 Writer,然后重复读取内容、写诗、显示结果。/quit 结束循环;默认是五言。
- 你接着做
- 在终端亲自运行 ./poet chat。输入 /start 春,读完后输入 /quit;七言和更多设置用 write。
你的完成标准
- 能指出输入与目标为什么相差一位。
- 能找到训练循环中真正更新参数的那一行。
- 能从 start_step、target_steps 和最终 step 判断恢复是否成功。
- 能解释截图中的误差为什么不是诗歌准确率。
- 能独立运行三个 CLI 版本,并解释参数如何到达模型。
- 能区分格式正确、关键词命中、语义通顺与原创性检查。
完整记录:本次命令与输出、截图来源与尺寸、演示训练与正式模型校验、曲线使用的全部数据。