这一课完成什么
把文字转成模型能够处理的整数,并把“接下一个字”写成明确的输入和目标。编号只负责查找,编号较大的字并不更重要,也不代表读音、笔画或意义。
同一串字,错开一位就是题和答案
每个位置预测下一个字。字编号只是查表地址,不代表大小、优劣或语义。
用文字逐步读这张图
- 原句:春 江 花 月 夜;五个汉字
- 临时字表:春0 江1 花2;月3 夜4
- 模型输入:春 江 花 月;0 1 2 3
- 正确答案:江 花 月 夜;1 2 3 4
- 第二道题:已经看到“春江”;下一个应为“花”
- 恢复文字:按同一张表反查;编号 → 原来的字
看到第三个输入位置时,可以利用“夜”吗?
不能。第三个输入位置只看到春、江、花;遮挡机制会阻止偷看后文。
用同一首句子制作练习题
假设临时字表是“春=0,江=1,花=2,月=3,夜=4”。完整序列是 [0,1,2,3,4]。训练时输入取前四项,目标取后四项:
输入 x:春 江 花 月     [0,1,2,3]
目标 y:江 花 月 夜     [1,2,3,4]
第一个位置看到“春”,目标是“江”;第二个位置可以看到“春江”,目标是“花”。一次计算可以给所有位置出题,但每个位置只能看到自己及之前的输入。第 12 课专门实现这种限制。
运行并观察
./poet lesson 4
.venv/bin/python lessons/04/experiment.py正式实验先放了若干特殊标记,因此显示的字编号与上面的临时字表不同。重要的是同一份字表前后一致,以及目标始终向后错开一位。把数字再查回文字,应该能还原原文。
text = "春江花月夜"
ids = tokenizer.encode(text)
x = ids[:-1]
y = ids[1:]
assert tokenizer.decode(ids) == text
正式材料多了什么
一个练习题由开头标记、五七言格式、关键词区、正文区、诗文和结束标记组成。特殊标记是一个独立编号,虽然显示成多个字符。正文中的汉字则是一个字一个编号。
<bos> <五言> <关键词> 明 月 <正文> 春 风 …… 。 <eos>前面的格式与关键词是已知条件。我们只给“接出正文与结束标记”评分;前面条件区和补齐的位置不计入误差。代码使用 -100 标记不评分的位置,这是 PyTorch 此处指定的忽略值,不是字表中的一个汉字。
未收录的字怎么办
本课程的字表固定在训练之前。用户输入未收录字时,CLI 会明确提示,而不悄悄换成别的字。若想增加生僻字,需要重新准备字表并训练相应模型。编号一旦变动,旧模型某一行参数对应的汉字也会变,不能只替换 JSON 文件。
验收与排错
- 输入与目标长度相同,目标比输入晚一个字。
- 还原后的文字和原文一致。
- 若预测成绩好得异常,检查是否把输入直接当作目标,或让模型看到了未来位置。
- 若传入编号超过字表长度,检查模型与字表是否来自同一次训练。
看懂这一次实际输出
把“春江花月夜”的小实验输出和前面的解释对照。这里的编号来自专门给实验准备的小字表,不是正式模型的汉字编号。
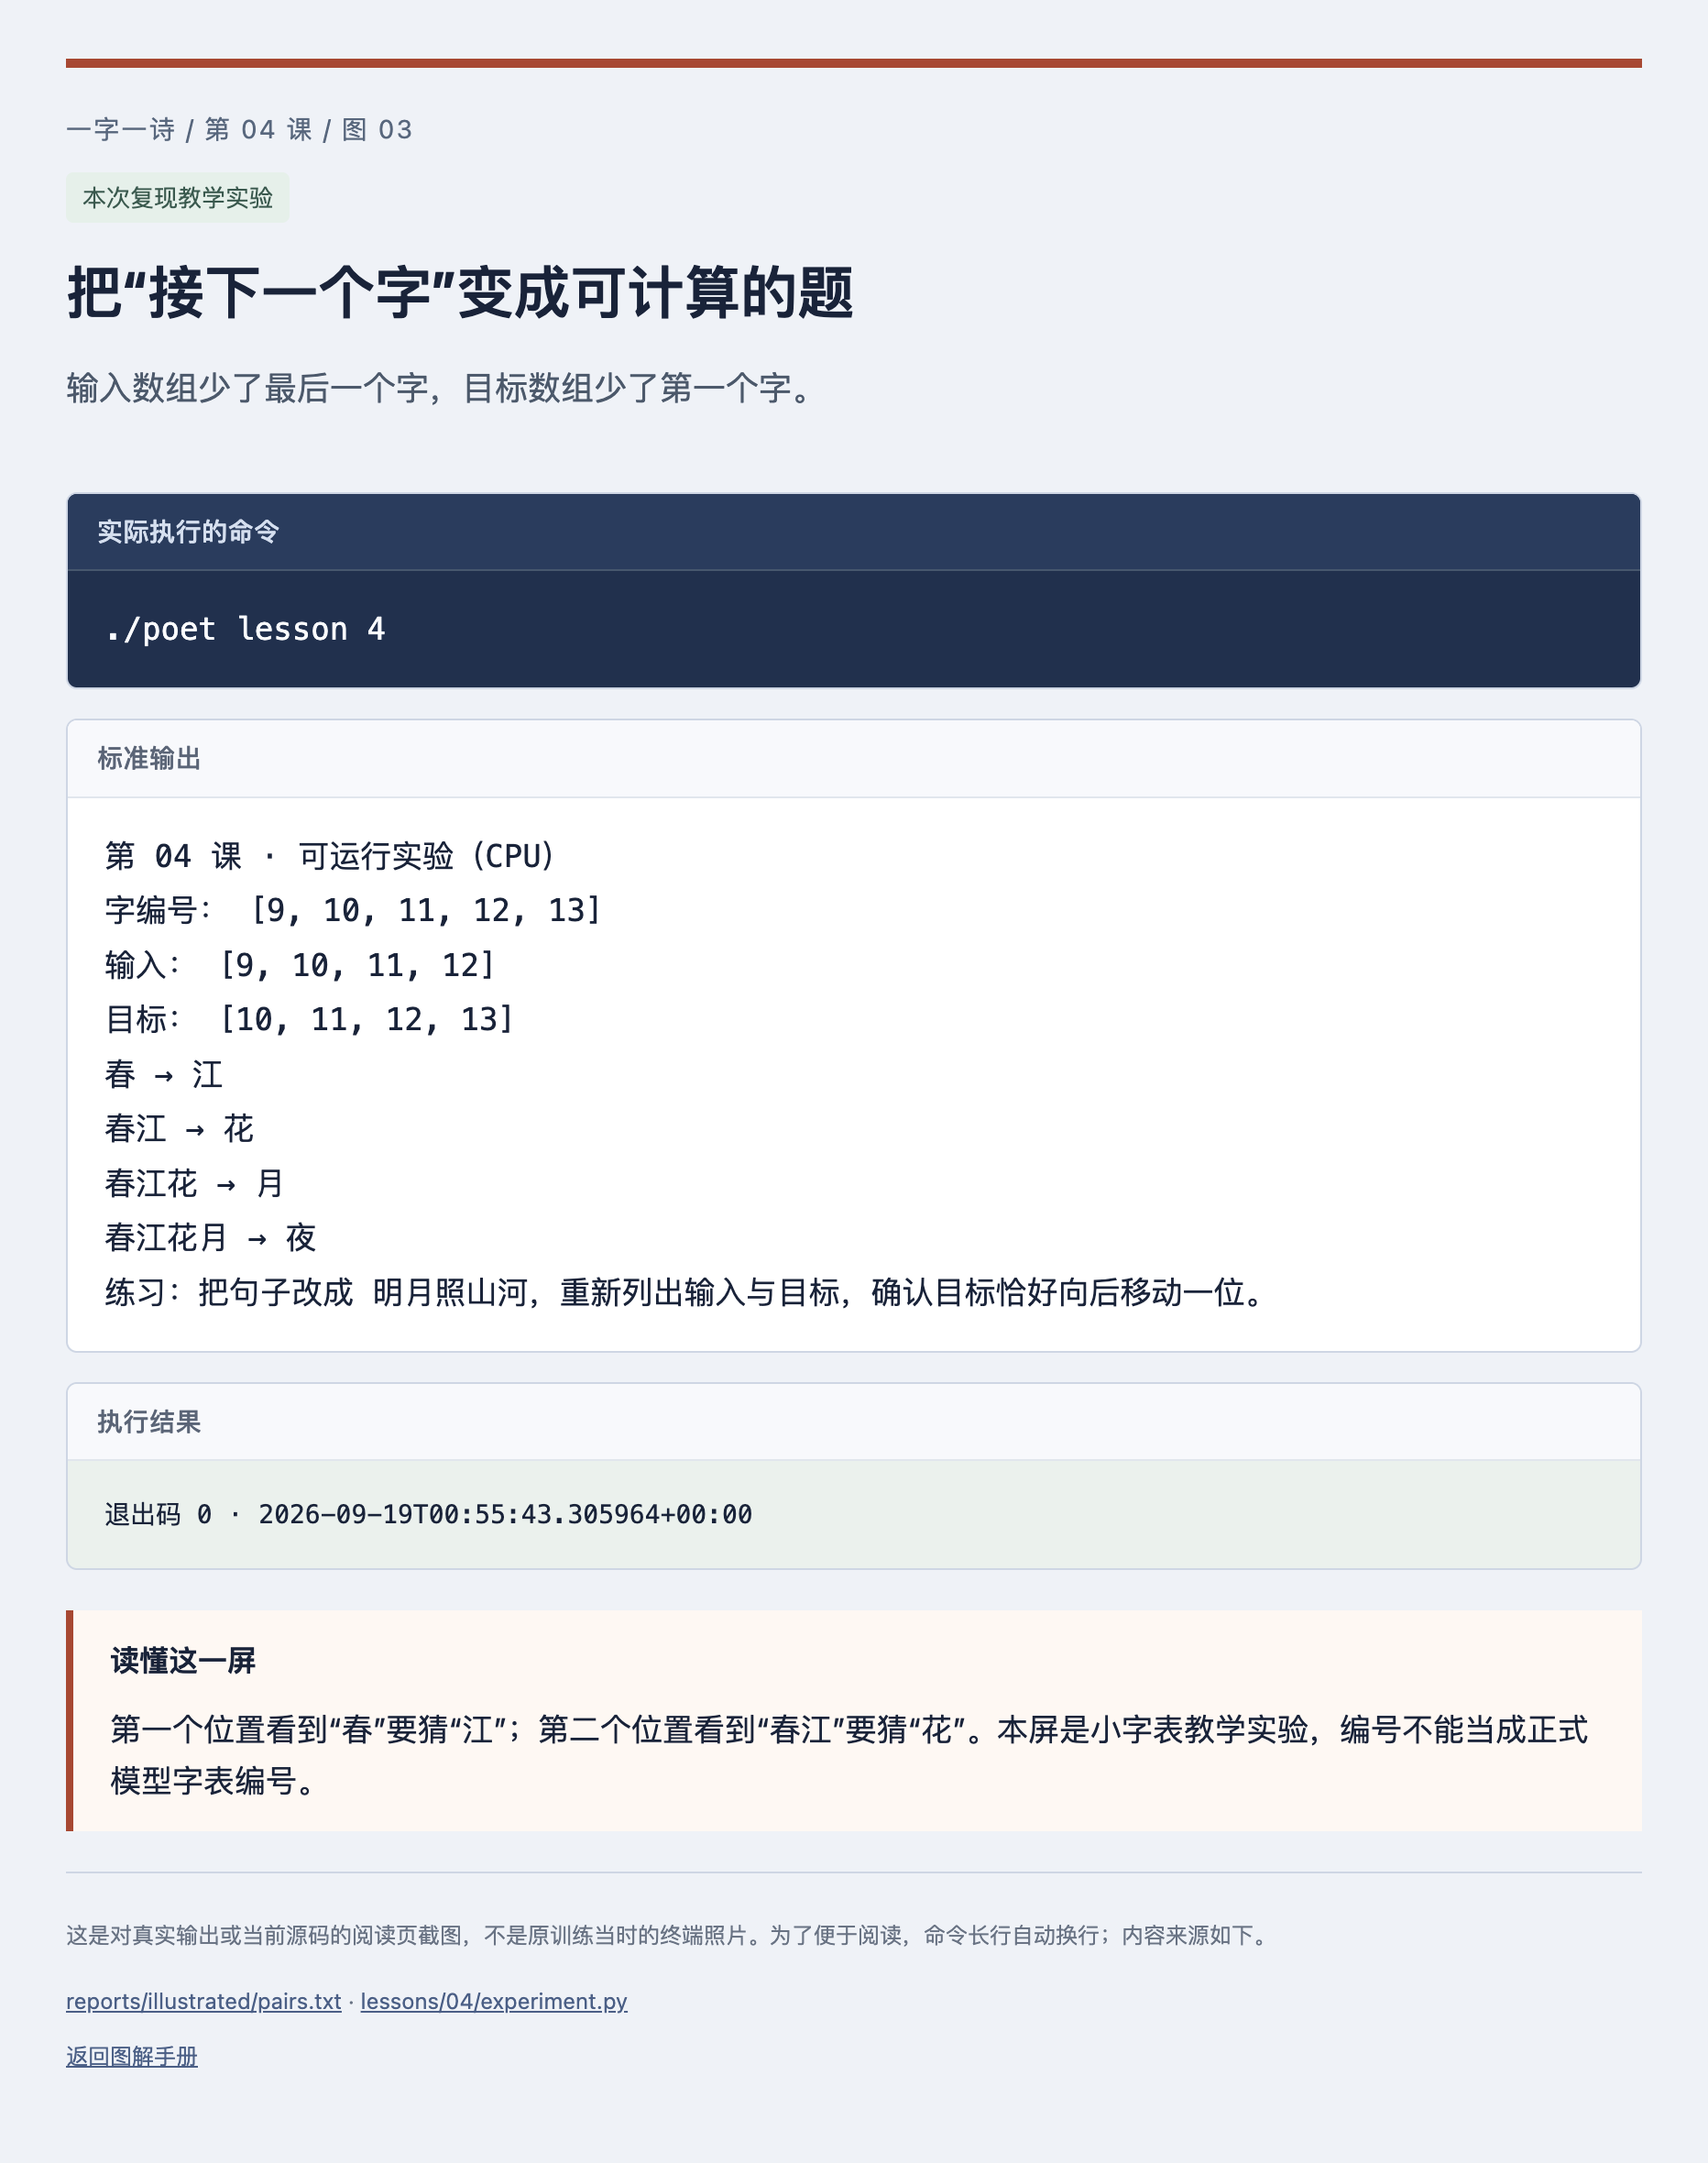
把“接下一个字”变成可计算的题
- 先看哪里
- 输入数组少了最后一个字,目标数组少了第一个字。
- 这说明什么
- 第一个位置看到“春”要猜“江”;第二个位置看到“春江”要猜“花”。本屏是小字表教学实验,编号不能当成正式模型字表编号。
- 你接着做
- 把实验复制为自己的文件,换一句五字诗,检查输入与目标仍相差一位。
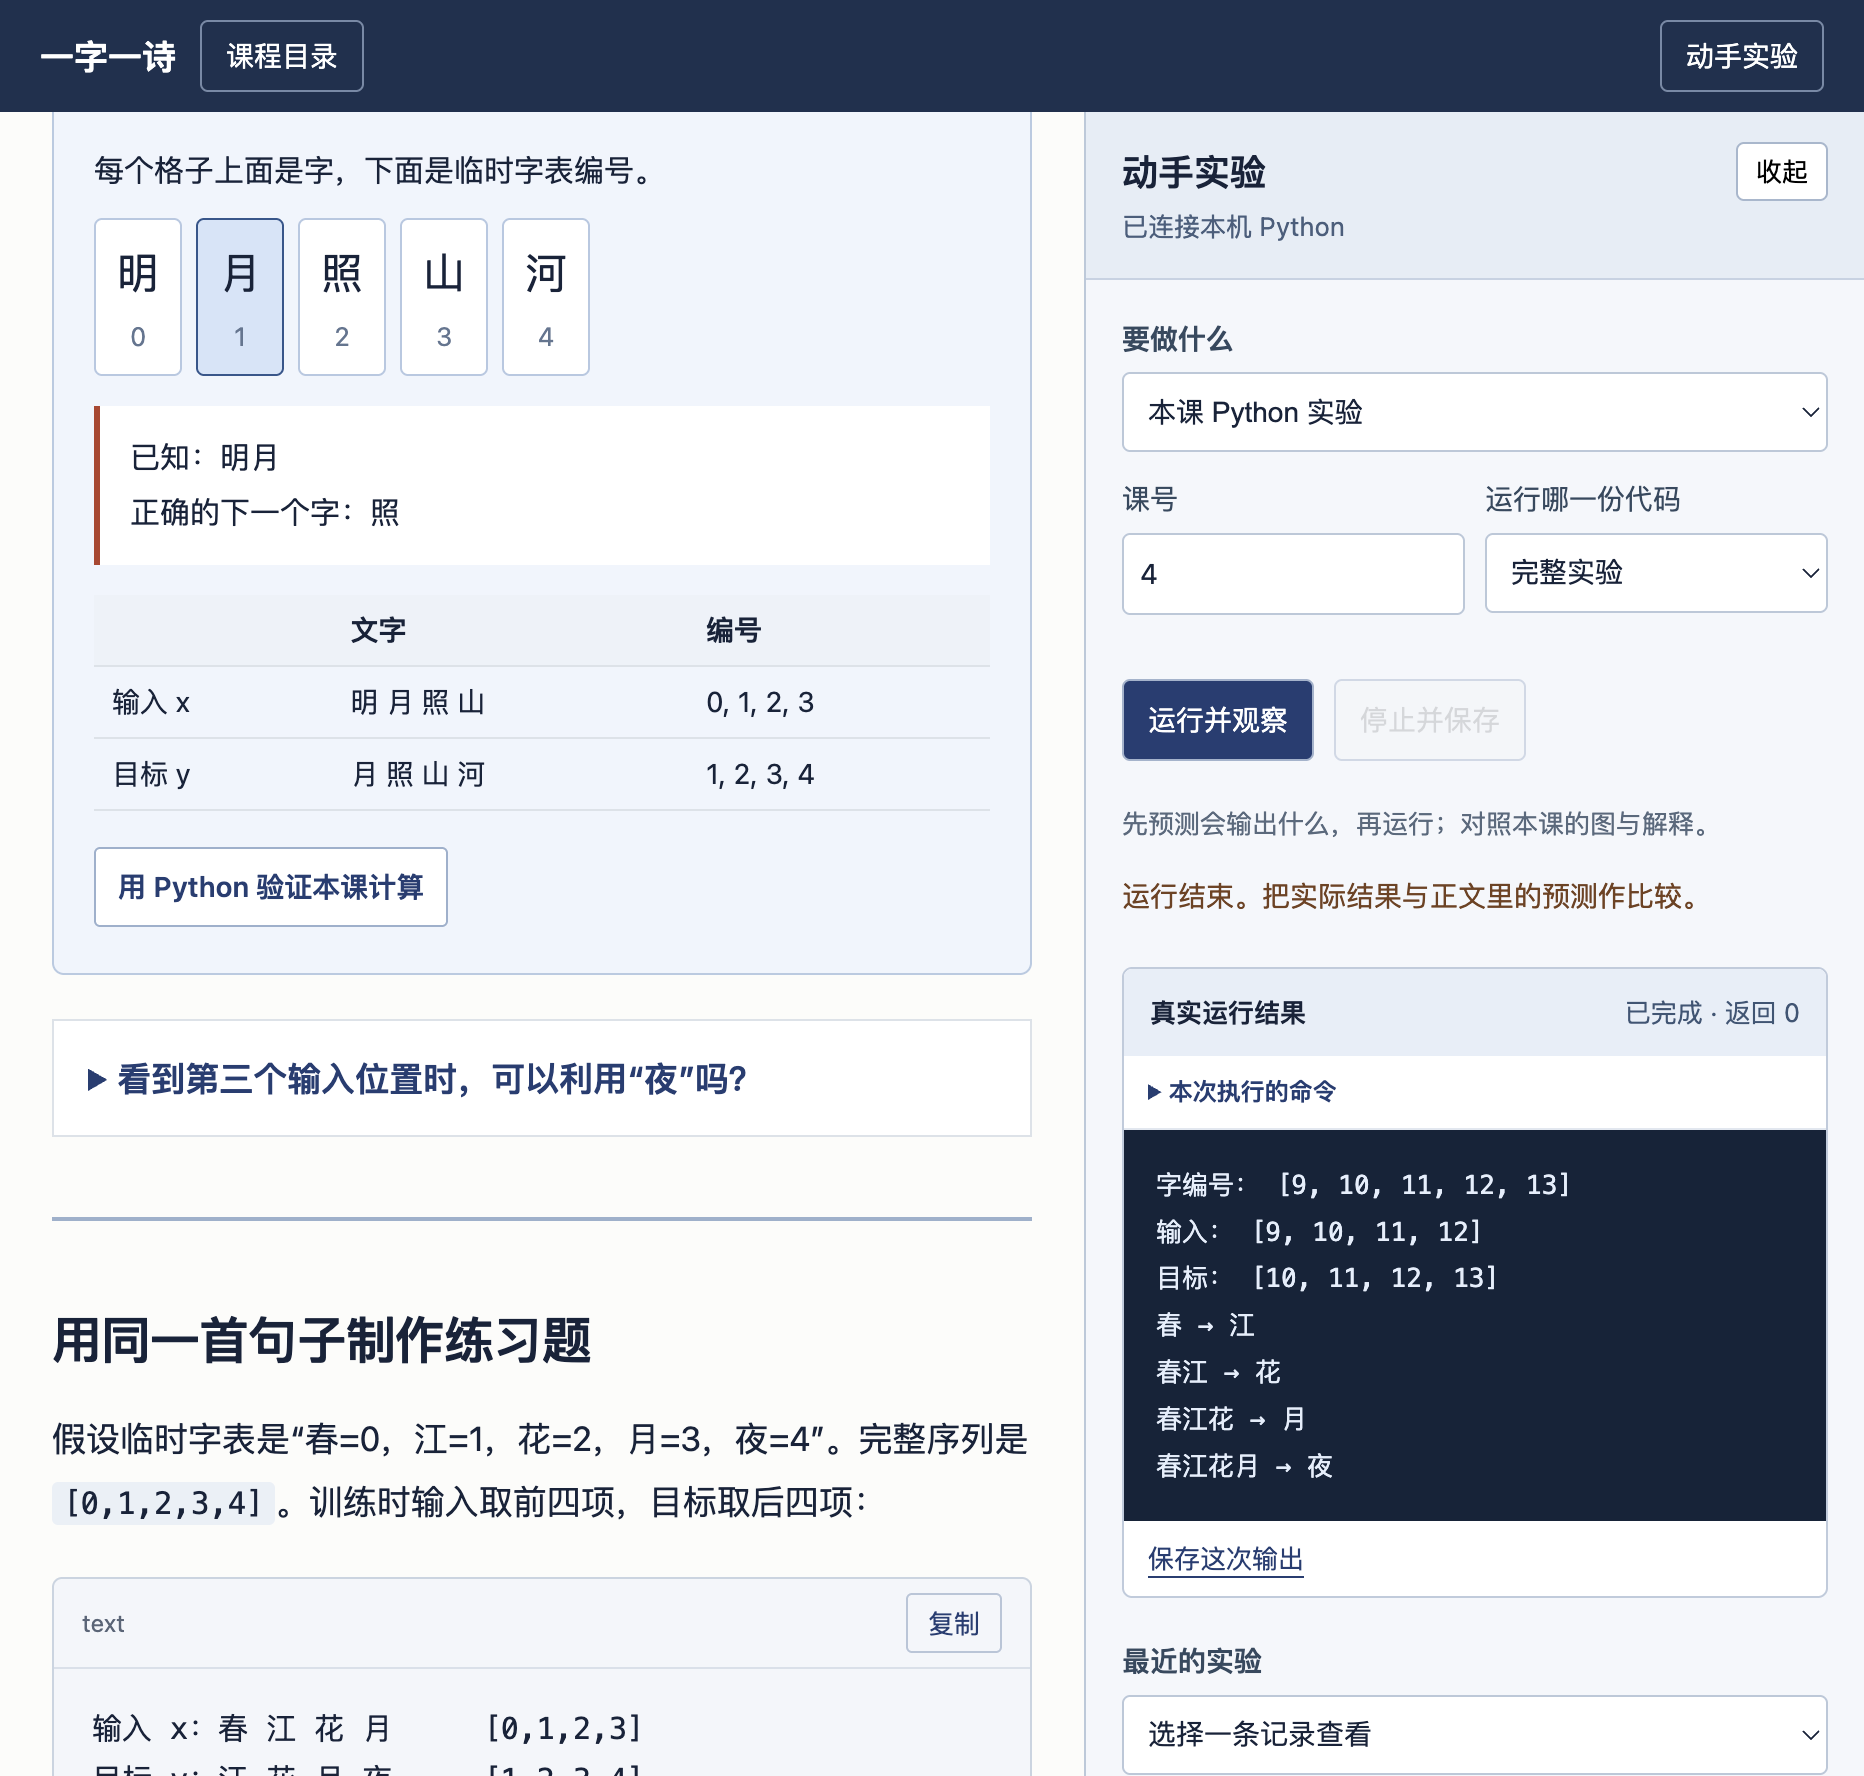
对照输入与目标,而不是背编号
- 先看哪里
- 先看左侧输入 x 和目标 y,目标向后错开了一位;再看右侧 Python 输出。
- 这说明什么
- 左侧换成了“明月照山河”,右侧运行的是课文固定例子“春江花月夜”。句子和字表编号可以不同,制作接字题的规则相同。
- 你接着做
- 先改图中的句子,写下你预测的输入与目标;再运行课文示例,对照同一条规则。
小练习与答案
把句子换成“明月照山河”,写出前两个位置实际知道的内容与正确答案。
查看答案
第一个位置知道“明”,答案是“月”;第二个位置知道“明月”,答案是“照”。输入是“明月照山”,目标是“月照山河”。只更改 text 后还要建立包含这些字的新临时字表;正式模型则使用保存的固定字表。