这一课完成什么
把原始材料变成有明确来源、可重复整理的学习材料。程序要回答“选了哪些、排除了哪些、为什么”,这些记录写在 manifest.json。同一份原始文件和同一套规则,应得到相同结果。
材料必须先整理,再分成三份
如果同一首诗同时在练习卷和考试卷里,成绩就会偏乐观。去重和版本分组应当发生在分卷之前。
用文字逐步读这张图
- 统一文字:春風 → 春风;保留原始来源
- 检查完整:缺字 □、夹注;进入排除记录
- 检查字数:四句五言或七言;统一正文标点
- 去重与分组:相同正文合并;相近版本放一起
- 按组分卷:学习 / 验证 / 测试;组之间不交叉
- 建立字表:主要来自学习材料;未知字单独处理
为什么不能分卷后各自去重?
各卷内部不重复,仍可能让同一首诗出现在两卷;需要先整体处理。
整理的顺序
先读取明确列出的唐宋正文文件,再统一繁简、删除空白,按标点拆句。只接受四句、每句全是汉字、每句均为五字或七字的记录。随后统一标点,按纯正文计算指纹,去除繁简与标点差异造成的重复。
正文有 □ 或夹注的记录直接隔离,本课不猜测缺失的字。自动繁简转换也可能把古字转换得不够准确,因此保留原文件与来源,课程不把它称为古籍校勘结果。
./poet lesson 3
./poet prepare如果交付目录已有整理结果,prepare 会拒绝覆盖。想亲手重新执行时使用新目录:
./poet prepare --output artifacts/data-practice随后若用自己的材料训练,命令中也要指定 --data artifacts/data-practice。材料与模型是配套版本,随意替换会导致字编号与参数含义不一致。
先分组,再分成三份
“春风”和“东风”版本可能是同一首诗的异文。如果一版进入学习材料,另一版进入考试材料,成绩会偏乐观。本项目先把正文相同的诗去重,再把相同位置至少两句相同的记录归为一组,整组进入同一份材料。
按组的固定指纹分桶,约 90% 进入 train 用来学习,约 5% 进入 val 用来选择设置和最佳版本,约 5% 进入 test 用于最终检查。这里是近似比例,组大小不同不会恰好等分。这种近似版本分组也不是穷尽所有异文的证明。
字表只根据学习材料建立,低频字门槛默认为出现至少 2 次。含未收录字的整首诗会隔离并计数。公开的关键词格式涉及的字另行加入,这是事先定义的输入格式,不从测试题偷看词汇。
检查处理报告
.venv/bin/python -c 'import json; m=json.load(open("artifacts/data/manifest.json")); print(m["split_counts"]); print(m["rejections"]); print(m["vocab_size"])'
./poet lesson 25重点核对原始数、排除原因、三份材料数量、每份五七言数量和字表大小。学习与验证、测试的组指纹交集应为 0。文件的 SHA-256 摘要记录具体内容,恢复训练会检查这些摘要。
对照整理后的文件
这张图读取已交付的 manifest,不会重新整理或覆盖材料。运行下面的小脚本,先对照数量,再检查五个文件是否齐全。
.venv/bin/python lessons/03/inspect_material.py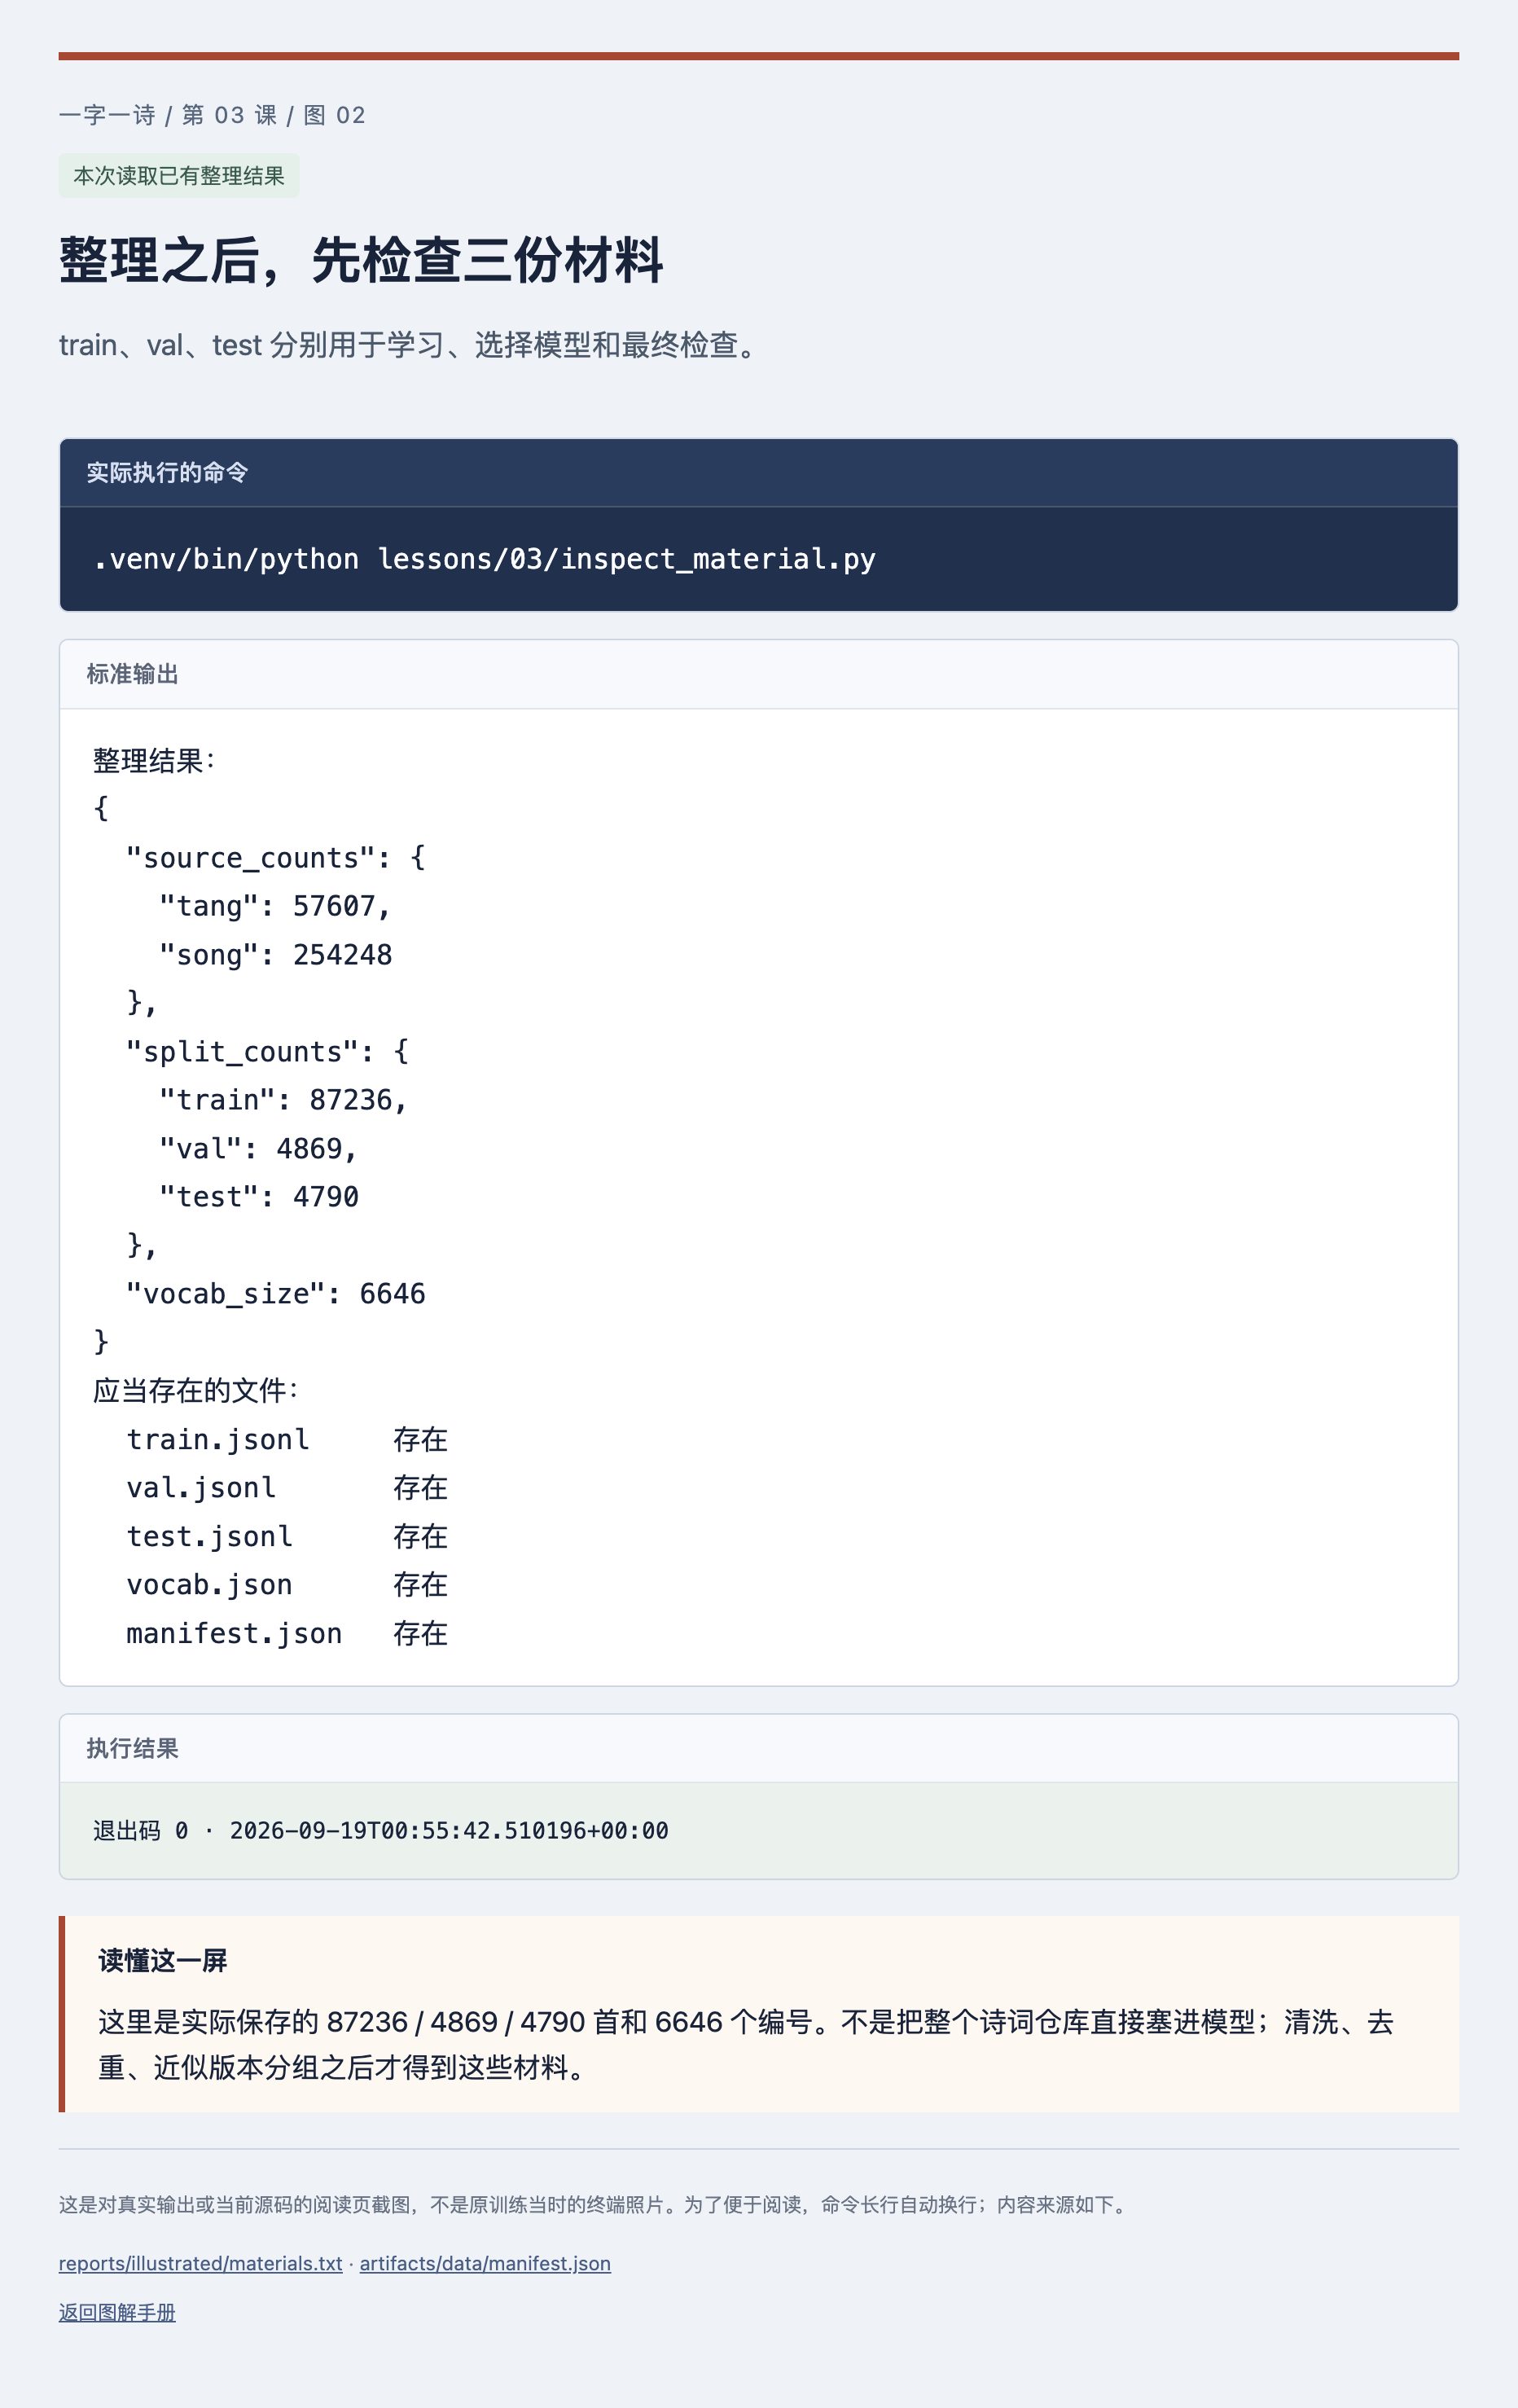
整理之后,先检查三份材料
- 先看哪里
- train、val、test 分别用于学习、选择模型和最终检查。
- 这说明什么
- 这里是实际保存的 87236 / 4869 / 4790 首和 6646 个编号。不是把整个诗词仓库直接塞进模型;清洗、去重、近似版本分组之后才得到这些材料。
- 你接着做
- 运行 lessons/03/inspect_material.py 对照五个文件。想重做 prepare 时选新目录,保留原材料。
验收与排错
- 整理完成后有
train.jsonl、val.jsonl、test.jsonl、vocab.json和manifest.json。 - JSONL 的每一行是一首诗,可以逐行读取;不要把它当作一个大型 JSON 数组。
- 目录已存在的提示用于防止覆盖训练依据。选择新目录即可,不需要删除旧材料。
- 若合格数量异常偏少,先查看排除原因,不要为了增加数量直接移除全部过滤条件。
小练习与答案
为什么必须在分卷前去重,而不能把诗随机分成三份以后再分别去重?
查看答案
分卷以后分别去重,只能去掉每份内部的重复。相同的诗仍可能同时存在于学习卷和考试卷。先全局去重、分组,再按组分配,可以保证本项目定义的同组版本不会跨卷。可以运行第 25 课实验检查三份材料的组交集。