这一课完成什么
理解保存文件包含什么,并亲手恢复一次训练。你应能够关闭程序后继续写诗,也能从最近保存的位置继续训练。
写诗所需的保存,与继续训练所需的保存
写诗要知道当前参数怎么计算;继续训练还要知道之前怎么调整、下一批怎么抽,所以保存的状态更多。
用文字逐步读这张图
- initial.pt:最初随机参数;用于训练前对照
- best.pt:验证表现最好的一版;用于写诗与评估
- latest.pt:最近参数与调整状态;用于继续训练
- 随机状态:抽题顺序与随机计算;也要一并恢复
- 材料指纹:核对字表和材料;防止编号含义错配
- 恢复到目标:已有 50,目标 75;再做 25 次更新
只有 best.pt,为什么不能宣称原样恢复训练?
本项目的 best 不包含优化器和随机状态,继续计算会走不同的更新轨迹。
两种保存用途
| 文件 | 包含内容 | 主要用途 |
|---|---|---|
| initial.pt | 初始参数、结构、字表与材料标识 | 与训练后比较 |
| best.pt | 验证误差最低时的参数与配套信息 | 写诗与评估 |
| latest.pt | 最近参数、优化器与随机状态等 | 继续训练 |
| metrics.jsonl | 各步学习、验证和速度记录 | 画曲线、排错 |
| run.json | 本次进度、状态、配置、资源记录 | 回顾运行 |
只保存参数可以恢复生成,但优化器还记着过去梯度的情况,抽题程序也有随机状态。丢掉它们再训练,更新轨迹就会改变。因此继续训练应使用 latest.pt。程序会拒绝用只适合生成的 best 文件冒充完整训练进度。
先验证参数恢复
./poet lesson 18小实验在内存里保存一个模型,再建同样结构、加载参数。关闭随机丢弃后,同一输入的输出应完全一致。本次实验输出 True。它验证的是保存与加载,不等于跨不同机器的训练每一位都能保持一致。
亲手恢复短跑
如果上一课是在右侧完成的,直接选择“继续上次训练”,在列表里找到刚才的记录。已有 50 步时,总目标填 75;运行日志的 start_step 应为 50,结束应为 75。想练习中途停下,可以先设置较大的目标,待出现更新记录后点“停止并保存”;等显示“已停止”,再选择这条记录继续。
./poet train --config configs/tiny.json --run-dir artifacts/runs/resume-practice --steps 10
./poet train --run-dir artifacts/runs/resume-practice --resume artifacts/runs/resume-practice/latest.pt --steps 20第二条命令目标是“总共达到 20 步”,不是再增加 20 步。检查启动信息的 start_step 应为 10,最终进度应为 20。恢复时使用保存的模型结构与训练设置,指定 --steps 或 --batch-size 会显式覆盖相应项目。
本项目的学习率计划依赖总步数。把目标从 10 延长到 20,会改变后续的计划,这是一段继续学习的实验,不宣称等同于一开始就设为 20 步的完全相同轨迹。若目标是严格中断恢复,应从开始就设好总步数,再在中途保存、恢复。
对照一段真实恢复记录
这次为了补充配图,另外实跑了 50 → 75 步。第一段见第 16 课截图;这张图里 start_step 已经是 50,而目标是 75,实际只再做 25 次更新。它与上面的 10 → 20 步练习是同一个恢复流程,目录、步数不同。
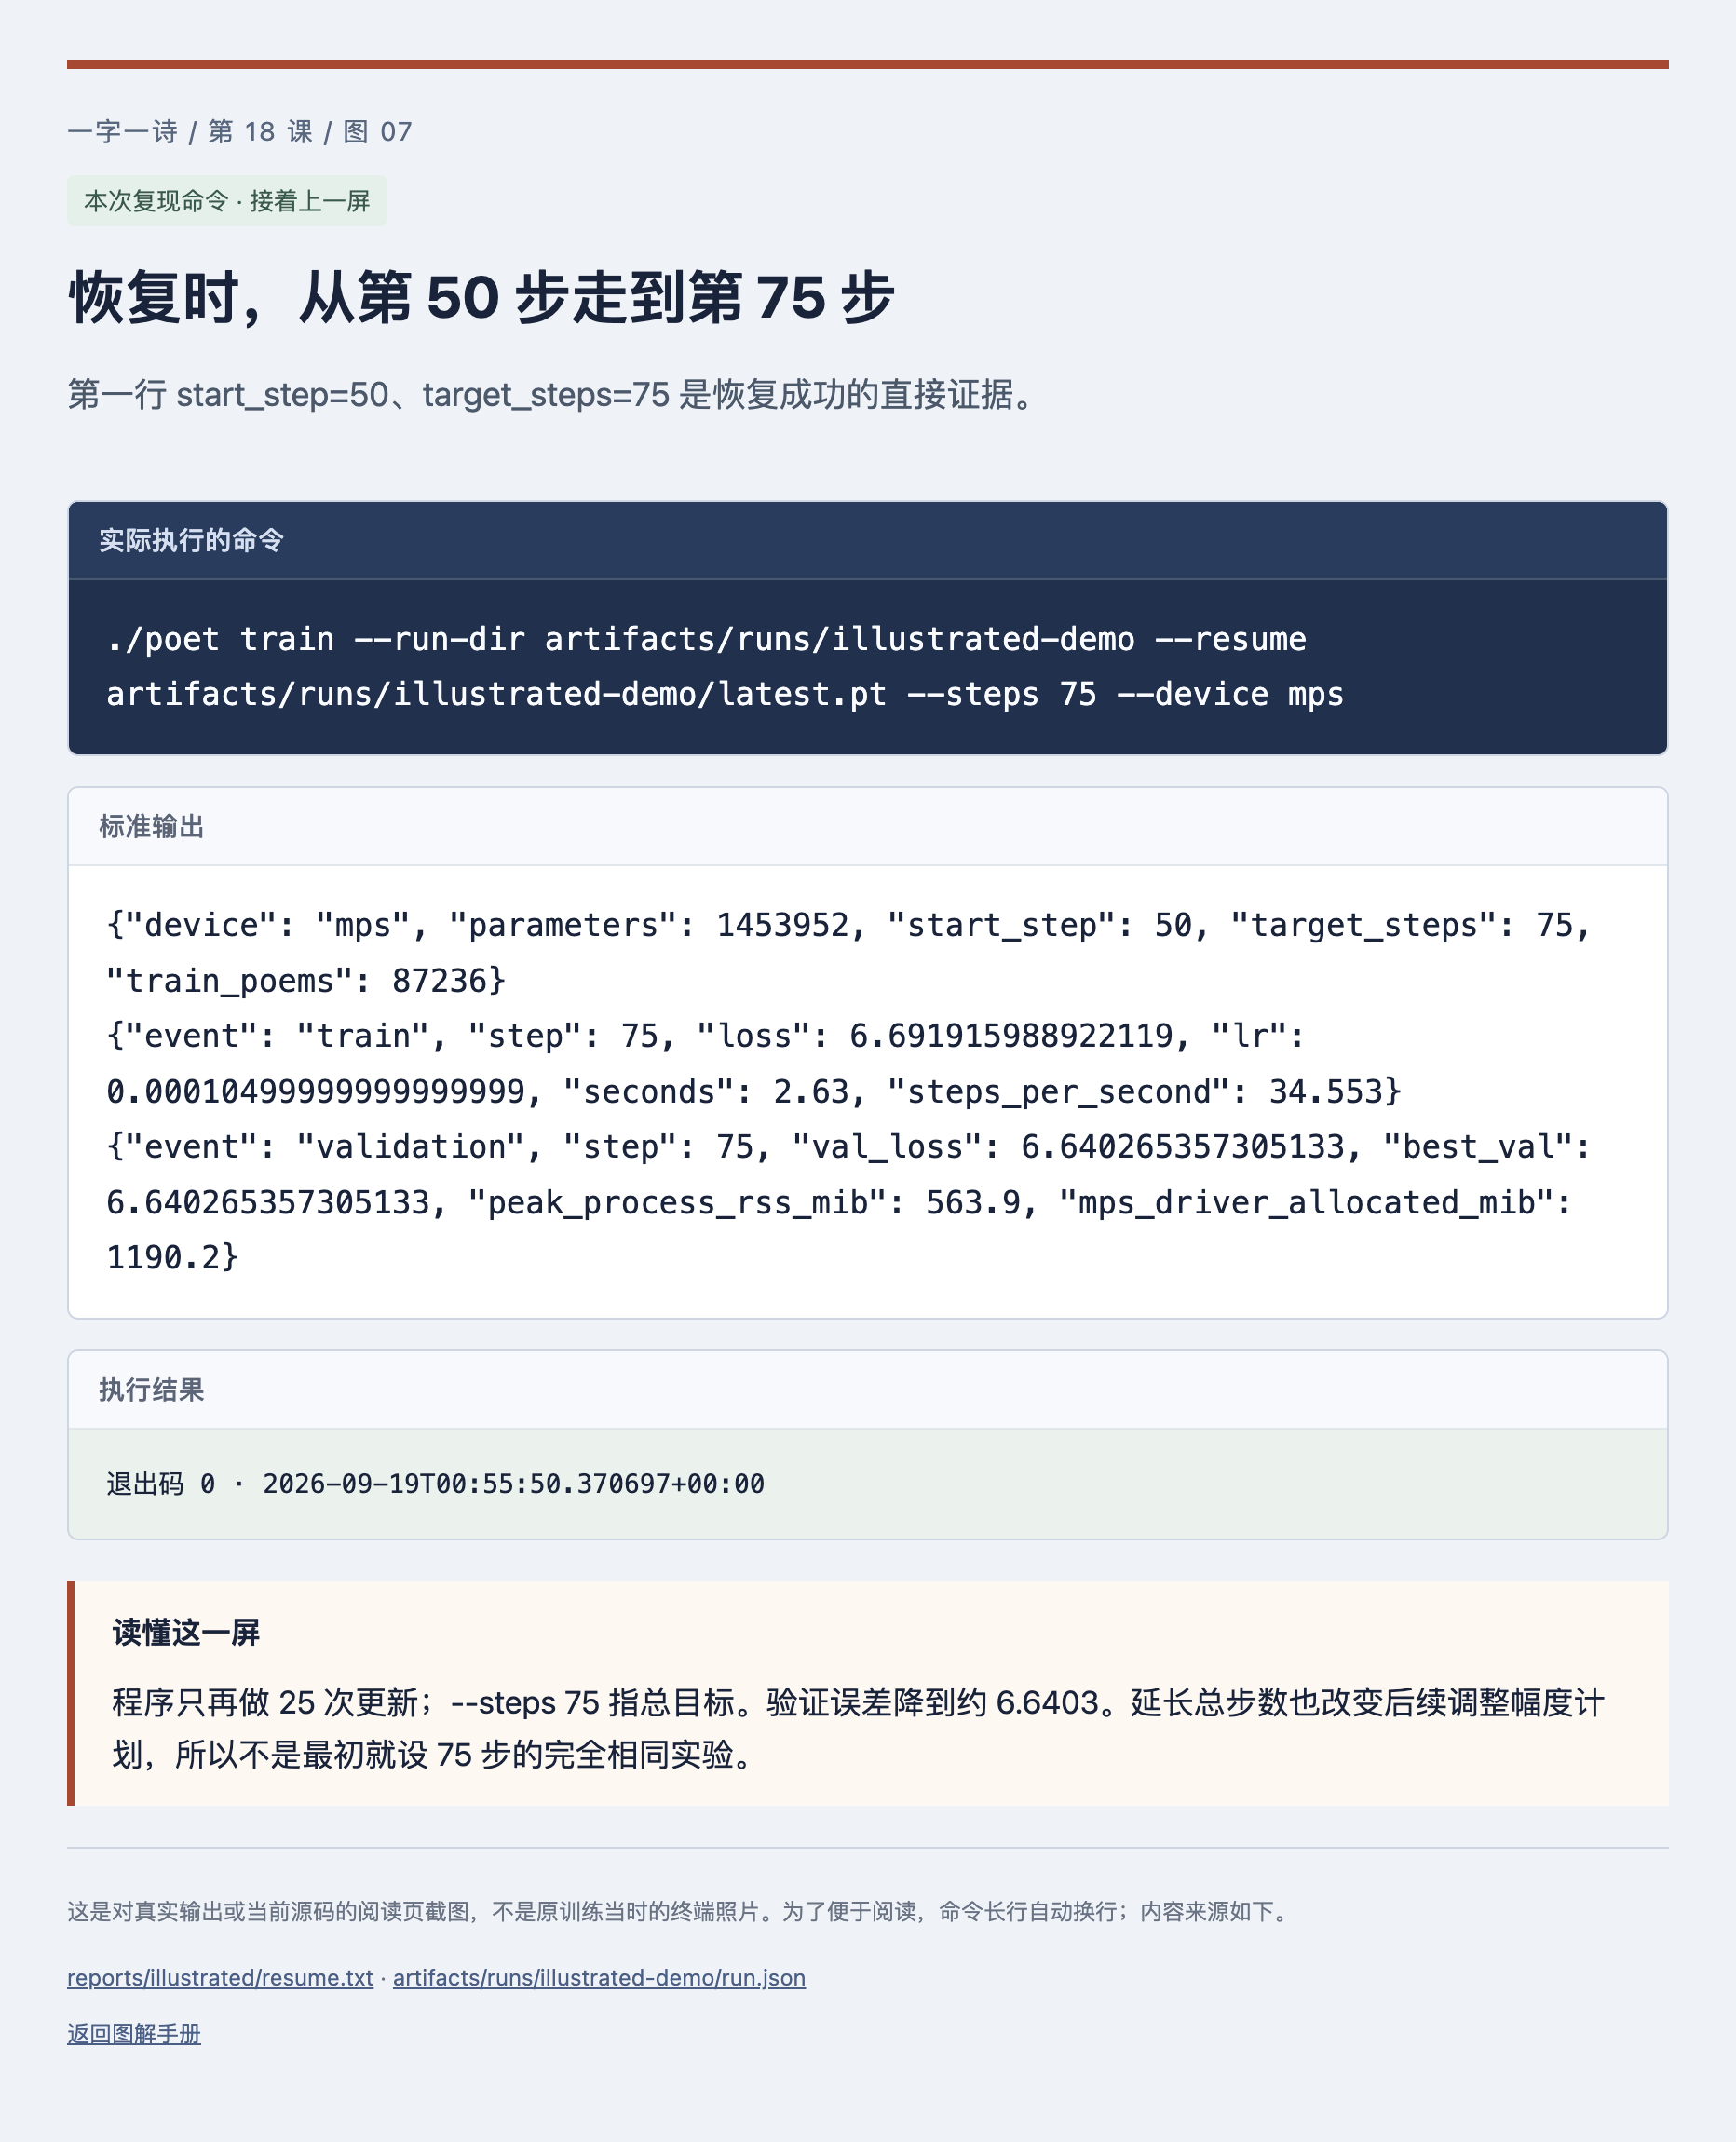
恢复时,从第 50 步走到第 75 步
- 先看哪里
- 第一行 start_step=50、target_steps=75 是恢复成功的直接证据。
- 这说明什么
- 程序只再做 25 次更新;--steps 75 指总目标。验证误差降到约 6.6403。延长总步数也改变后续调整幅度计划,所以不是最初就设 75 步的完全相同实验。
- 你接着做
- 给你自己的目录传入 --resume …/latest.pt;如果 start_step 仍为 0,先核对文件路径。
防止材料和字表错配
恢复前会比较材料摘要和字表。假设原来第 100 行代表“月”,更换字表后第 100 行变成“山”,参数文件即使尺寸相同,也会被错误解释。因此模型文件保存自己的字表,训练恢复还要求对应材料未改变。
模型文件通过临时文件再原子替换写入,降低中断留下半份文件的风险。Ctrl+C 可以触发保存;强制结束进程、断电或磁盘写入失败不能保证保存最后一次更新,应以实际存在且可加载的文件为准。
验收与排错
- 实验显示保存恢复后的输出相同。
- 恢复训练日志从已有 step 开始,而不是重新从 0 开始。
- 目标步数必须大于已完成步数。
- 若提示材料不匹配,使用原来的材料目录;不要绕过检查硬接新字表。
- 只加载自己生成或可信来源的模型文件。本项目使用受限的
weights_only=True加载方式。
小练习与答案
为什么 best 不一定等于 latest?
查看答案
训练后期可能更会背学习材料,但验证题表现变差。best 保留验证误差最低的阶段;latest 保留最新进度以便恢复。写诗默认选 best,继续训练使用 latest。