这一课完成什么
阻止模型在训练时偷看尚未出现的字。这种限制叫因果遮挡,代码常写成 causal mask。它让训练时的每个位置遵守生成时的条件:只能利用已经拥有的前文。
把未来位置挡住,才能练习真正的接字
训练时虽然整句都放在数组里,但计算每个位置时不许看到后面的字。否则答案就在眼前,误差低也没有意义。
用文字逐步读这张图
- 第 1 个位置:只看第 1 个字;不能看第 2 个
- 第 2 个位置:看前两个字;不能看第 3 个
- 禁止区域:分数设为负无穷;不是把答案改成 0
- 变成概率后:禁止位置权重为 0;不参与信息汇总
- 并行训练:所有位置一起计算;每行各守自己的界限
- 正确检查:改最后一个输入字;前面位置输出不变
为什么训练可以并行,生成却要一个个接?
训练时答案已存在,只需遮住未来;生成时下一个字尚未确定,要先生成才能继续。
为什么一次训练会有泄露风险
输入为“春江花月”,目标为“江花月夜”。虽然第一道题的输入位置是“春”,整次训练的输入数组仍包含后面的“江花月”。如果不限制注意力,第一位置可以直接看第二位置的“江”,预测就失去意义。
        春    江    花    月
春      可    不可  不可  不可
江      可    可    不可  不可
花      可    可    可    不可
月      可    可    可    可
行表示当前位置,列表示可以取信息的位置。对角线可以保留:当前字是已知输入,预测的是它后面的字。要挡住的是严格位于对角线右上方的格子。
遮挡怎样进入运算
在 softmax 之前,将禁止位置的分数改成负无穷。取指数后这些位置变成 0,归一化后权重仍为 0。不能简单把禁止位置的原始分数设为 0,因为 exp(0)=1,它仍可能得到非零权重。
forbidden = torch.ones(length, length, dtype=torch.bool).triu(1)
score = score.masked_fill(forbidden, float("-inf"))
weights = score.softmax(dim=-1)
triu(1) 选中严格上三角。True 在本段手写实现里代表“禁止”;不同函数的遮挡参数语义可能不同,不能只凭名字猜。正常训练使用 PyTorch 的 is_causal=True 表达这一规则。
用反事实输入检验
./poet lesson 12实验向模型输入 [1,2,3],再只把最后一个字改成 [1,2,9]。在关闭随机丢弃、使用同一个模型时,前两个位置的输出应该完全不受影响。最后位置可以改变,因为它确实看到了被修改的当前字。
这是比“看见代码里有 mask”更强的检验:无论遮挡在哪一层,只要最终前两个输出改变,就应继续调查。项目的测试会对完整模型执行这种检查,同时验证手写注意力与优化路径接近。
验收与排错
- 权重表上三角为 0,每行总和接近 1。
- 更改未来字,过去位置的输出不变。
- 先调用
model.eval()关闭随机丢弃,否则两次运算本来就可能不同。 - 不要连对角线也一起遮挡。第一行若全部为负无穷,softmax 可能出现无效数值。
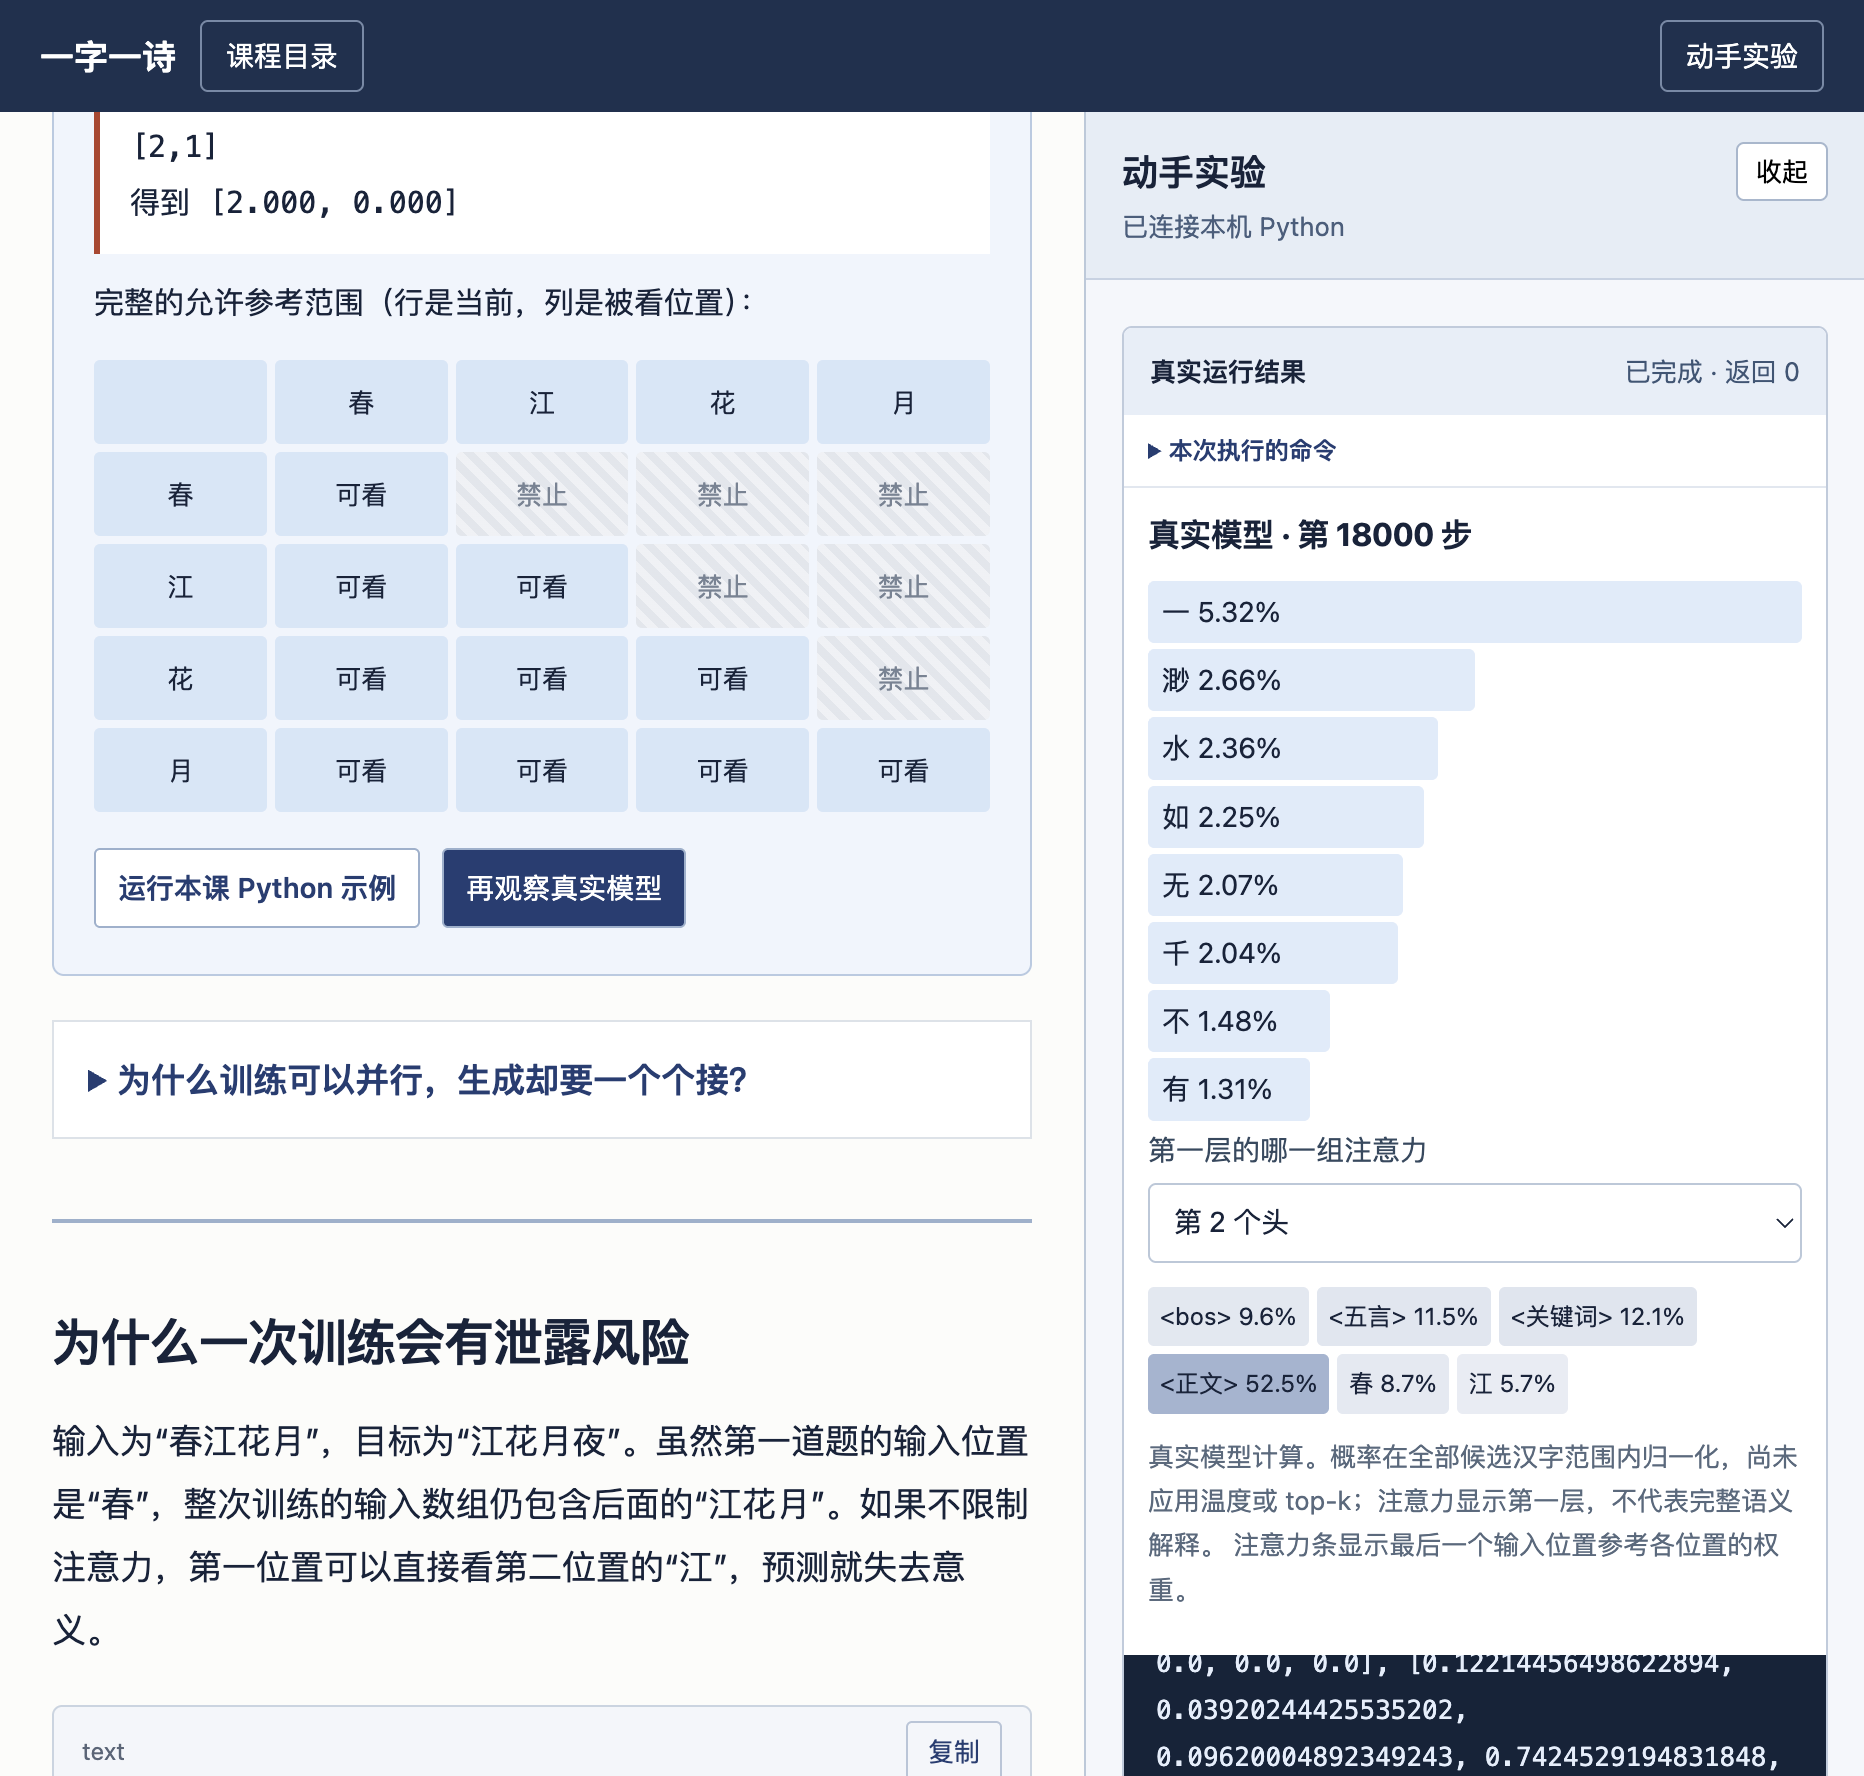
把允许参考的范围,与真实权重分开看
- 先看哪里
- 左侧三角表说明哪些位置可以被参考;右侧是正式模型对“春江”的下一字概率,以及第一层第 2 个头的实际权重。
- 这说明什么
- 左侧给出规则,右侧显示模型学出的数字。第一层最后一个位置对“正文”标记的权重约为 52.5%,只说明这一次汇总的比例,不能直接解释整首诗的含义。
- 你接着做
- 在右侧换一个前文并重新运行,再切换注意力头。先比较权重变化,再思考为什么单个头不足以代表整个模型。
小练习与答案
为什么把未来位置的权重在 softmax 后直接清零,也需要额外注意?
查看答案
原来的 softmax 已经让未来位置参与分母,清零后剩余权重通常不再加起来等于 1。它也让未来字通过分母间接影响过去输出。应在归一化之前遮挡,或者使用数学上等价且正确重新计算的实现。本项目采用前者。