这一课完成什么
把“围绕关键词写”变成模型训练时真正见过的任务。仅训练原诗正文,不会自动让模型明白 CLI 中某个参数的意义。我们需要把关键词和诗文放在同一条学习序列里。
关键词要在训练题里出现,才有机会被利用
不能只在生成时临时贴一句说明,就期待小模型懂得服从。训练时也要让模型见过“条件在前、正文在后”的同类格式。
用文字逐步读这张图
- 诗文线索:明月、故乡等;来自正文或规则
- 提取条件:关键词不是人工真标签;可能有误判
- 拼进前缀:格式 → 关键词 → 正文;训练生成保持一致
- 只评分正文:已知条件不计误差;接出的字才是答案
- 生成时沿用:输入“秋雨,故乡”;作为前缀线索
- 检查是否出现:直接出现与主题相关;两者不要混淆
关键词没直接出现,就一定完全没影响吗?
不能这样断言。但至少字面约束没有满足,应如实记录,不能把软引导称为保证。
关键词从哪里来
第一类是正文实际出现的常见古典词,例如“明月、春风、故乡”。第二类是用公开线索规则推测的主题,例如正文出现“乡、归、客”之一,会加入“思乡”候选。这些主题规则会误判,称作弱标签;课程明确记录规则,不把它们说成人工精校。
本项目没有把整首诗交给外部聊天服务生成标签。你可以查看 poetry_gpt/data.py 的 WORDS 和 THEMES,逐项修改与审查。新增主题前,先人工检查几十条命中记录,记录典型误判。
./poet lesson 22例如“客”也可能出现在宴客、待客的诗里,并不一定是思乡。若希望标签更准确,可以要求多个线索同时出现、加入排除条件,或人工整理一小份可靠的主题训练材料。
条件序列怎样构造
<bos> <七言> <关键词> 明 月 <隔> 故 乡 <正文> ……诗文…… <eos>每次取到一首诗,程序从它的候选关键词中随机取零个、一个或两个。零关键词练习让模型也能在没有主题条件时接着开头写;有关键词练习让它学习条件与诗文之间的联系。相同原诗派生出的所有条件练习始终属于同一份材料,不能把它们拆到训练与考试两边。
评分只覆盖正文与结束标记,但误差仍能通过正文对条件的关注,传回关键词的表示与相关计算。条件区本身不评分,并不意味着模型完全不学习使用它。
对照关键词的影响
./poet write --keywords 明月 --form five --seed 12
./poet write --keywords 春雨 --form five --seed 12
./poet write --keywords 秋雨,故乡 --form seven --seed 12比较全部输出,记录哪些有对应意象、哪些偏题。CLI 最多接收三个关键词,每个 1—4 个汉字;训练主要见过零到两个条件,三个组合属于更困难的使用情形。字表支持某个词不等于模型已充分学习这个词的主题含义。
字面出现与切题是两个检查
“明月”出现在诗里是容易自动检查的事实;整首是否表达月夜意境,需要阅读。反过来,诗可能用“清辉”等相关意象表达主题,却没有字面出现“明月”。当前候选排序提供词面与线索分数,只把它当辅助。不会保证每个关键词必然出现。
验收与排错
- 能在整理后的记录中看到关键词列表,知道每类标签的来源。
- 同样种子、更换关键词时生成可以变化,但不能据此单次证明稳定主题控制。
- 稀有现代词、复杂抽象指令可能效果很差;本课对象是常见古典意象。
- 若关键词完全不起作用,先检查训练序列是否真的含条件、词表是否收录、评分区是否对齐。
真实例子:两个词,只直接出现了一个
下面的实际命令输入“秋雨、故乡”,最终诗中只有“故乡”直接出现。用 JSON 中的 keywords 与 keyword_literal_hits 对照,能看见软引导的限制,而不依赖模糊印象。
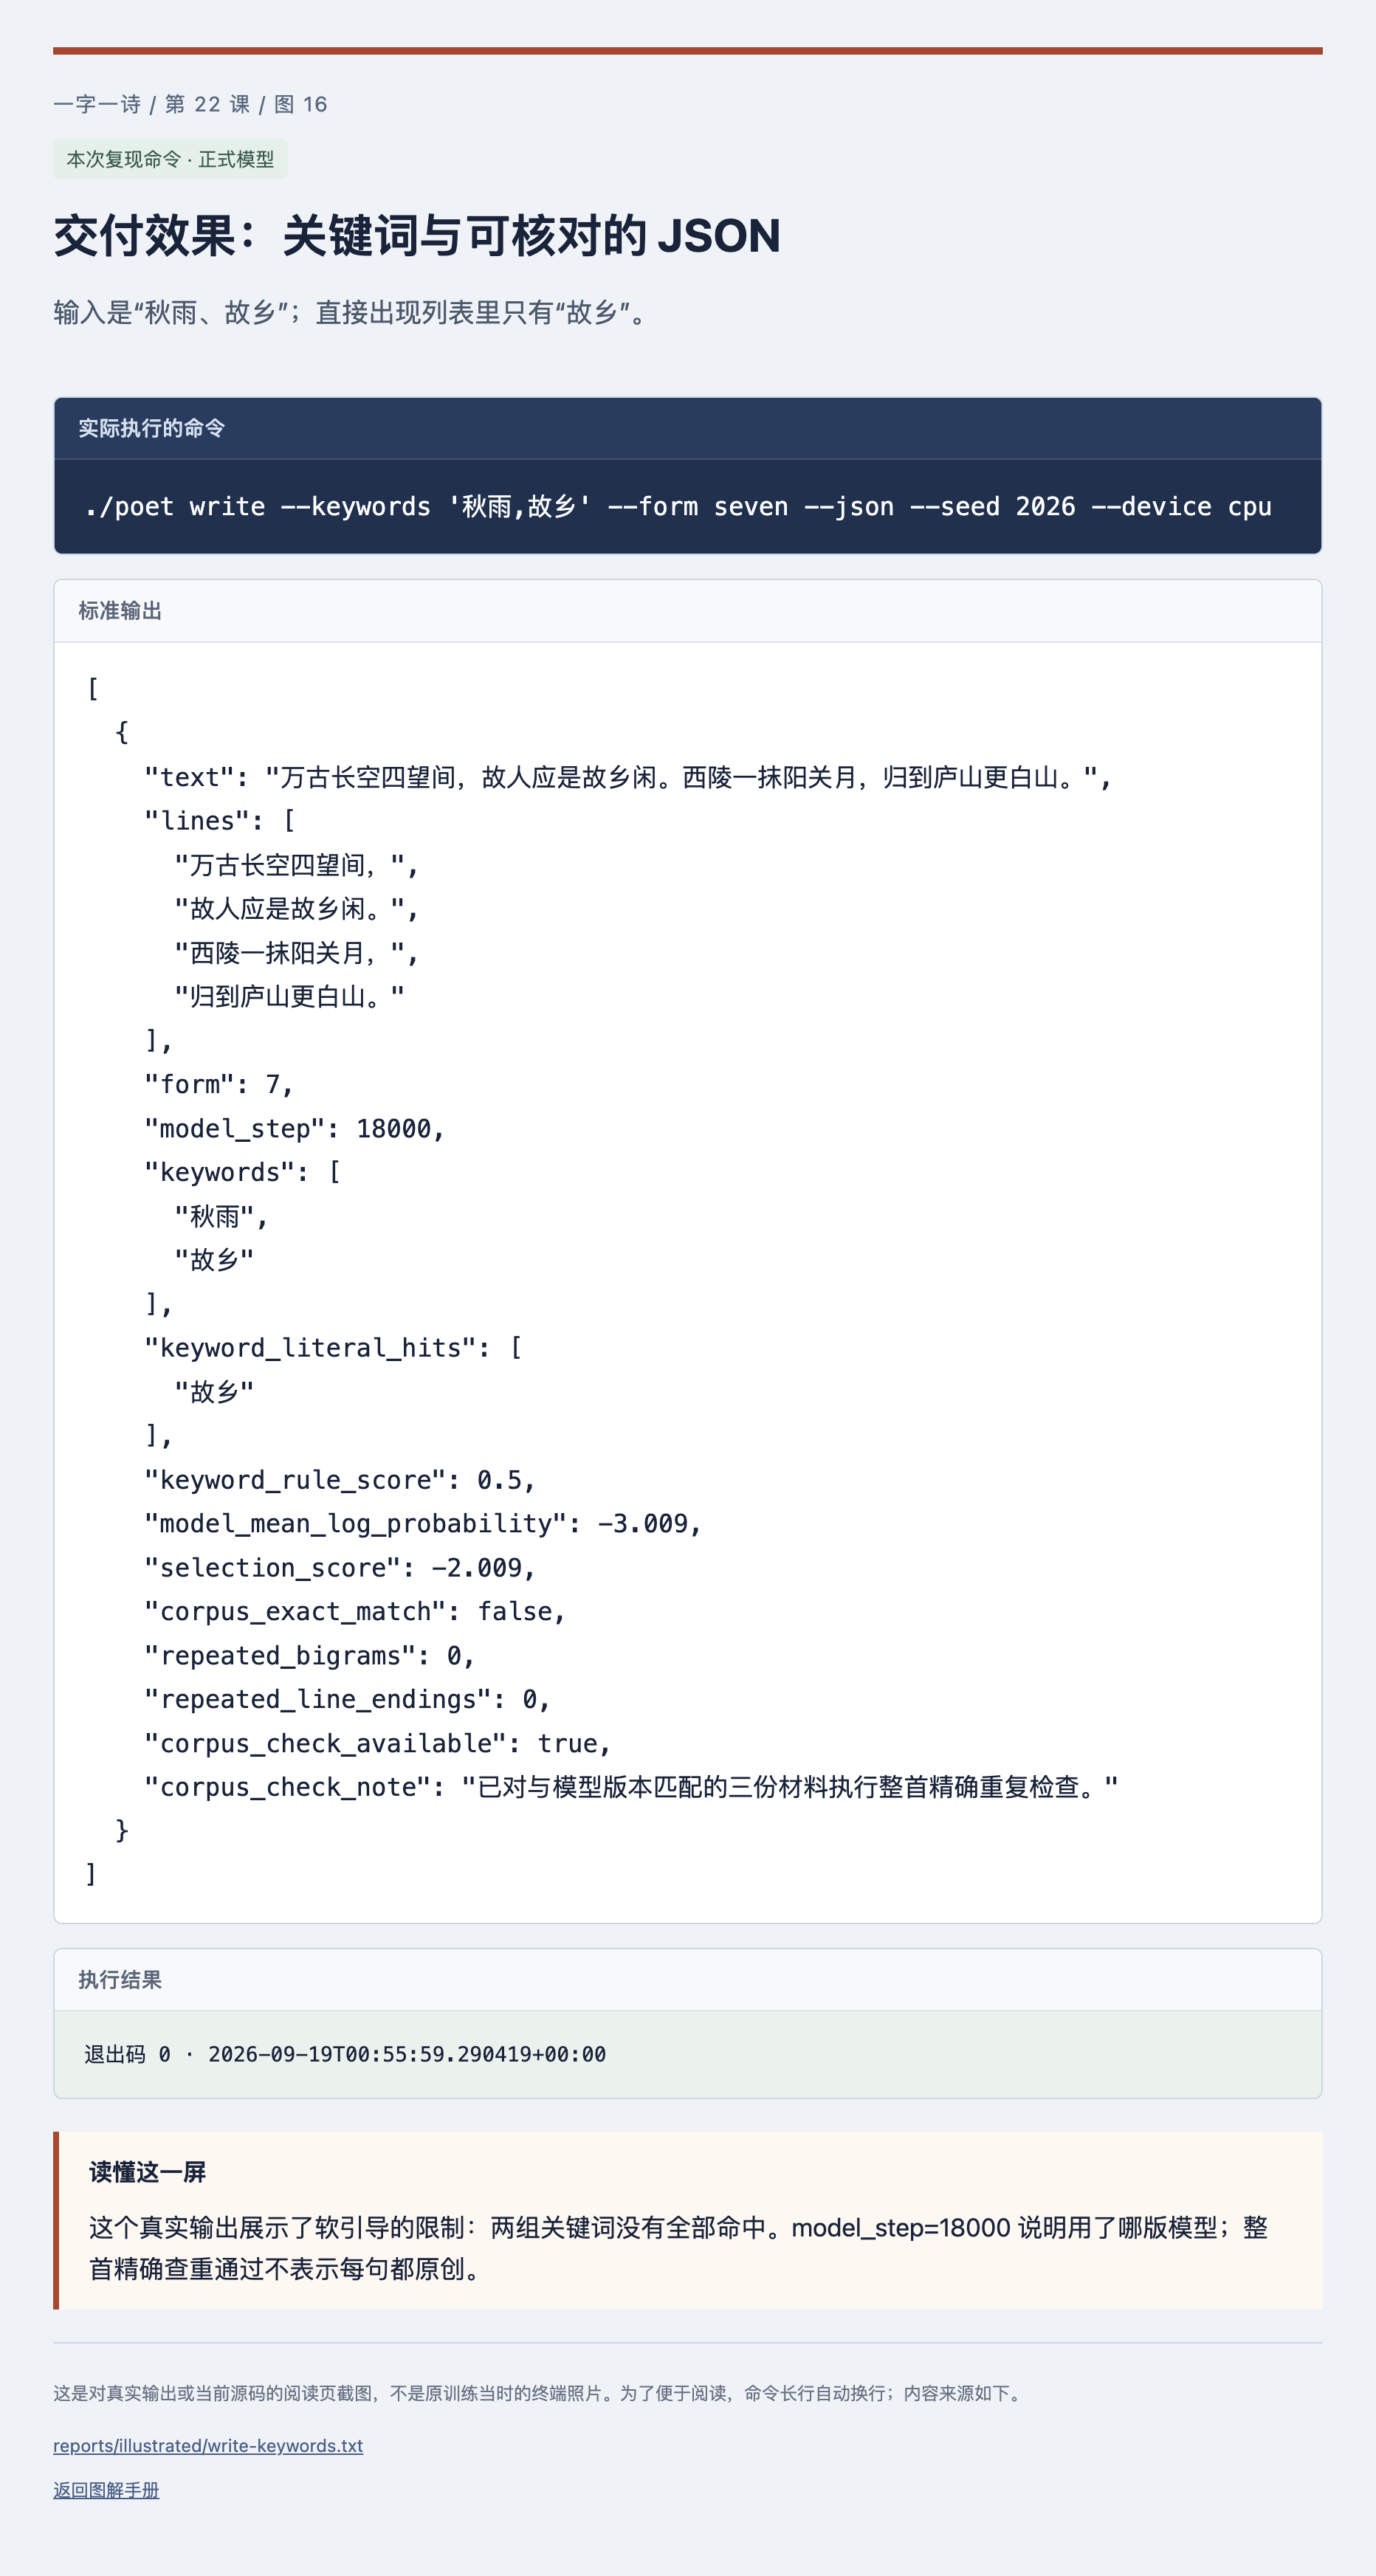
交付效果:关键词与可核对的 JSON
- 先看哪里
- 输入是“秋雨、故乡”;直接出现列表里只有“故乡”。
- 这说明什么
- 这个真实输出展示了软引导的限制:两组关键词没有全部命中。model_step=18000 说明用了哪版模型;整首精确查重通过不表示每句都原创。
- 你接着做
- 对照 keywords 与 keyword_literal_hits,分别记录外形、主题、重复、语义,不要把 selection_score 当成人工诗歌评分。
小练习与答案
只出现“客”的诗被标成“思乡”,你会怎么改善规则?
查看答案
先抽查误判,再考虑要求“客”与“归、乡、愁”等线索共同出现,或直接使用正文含“故乡”的高精度子集。更严格规则会减少可用例子,因此应同时报告命中数量与人工抽查准确情况。不能靠在网页里把标签称为高质量来解决误判。