这一课完成什么
把已理解的部件串起来,看到完整 GPT 从编号输入到候选字分数的路径。现在每个部件都能在前面某一课找到独立实验,遇到问题可以拆回去检查。
把所有部件连成一个可训练的 GPT
GPT 在这里是一台接字计算器:输入已知文字的编号,输出每个位置对下一字的打分。有标准答案时,再计算训练误差。
用文字逐步读这张图
- 字编号:[批数量, 字数];离散整数
- 字 + 位置向量:[批数量, 字数, 宽度];可学习的表示
- 重复处理块:注意力 → 前馈;中间有归一化与残差
- 最后的归一化:稳定输出的尺度;每个位置分别处理
- 转成字表分数:[批数量, 字数, 字表];每个字得到一个分数
- 两种用途:有答案:算误差训练;没答案:选择下一个字
它与常见大模型哪里相同、哪里不同?
这里也用仅看前文的 Transformer 接字;规模、分词、训练量与产品能力远小于大型模型。
字编号 [B,T]
  ↓ 汉字查表 + 位置查表
表示 [B,T,C]
  ↓ 多个 Block(注意力 + 逐位置加工)
表示 [B,T,C]
  ↓ 最后归一化 + 输出投影
候选分数 [B,T,V]
V 是字表大小。每一个位置都为全部候选编号输出一个分数。训练时这些分数与右移的目标评分;生成时只取最后一个位置的分数决定下一个字。
运行完整模型的小版本
./poet lesson 15本课使用字表 100、宽度 32、4 个头、2 层、前文长度 16 的小配置。输入 [1,2,3],输出应为 [1,3,100],参数总数为 29,184。它还没训练,数值只是随机初始化后的输出,不应解读为已经懂得诗意。
对应源码逐段读
打开 完整 GPT 源码,按 ModelConfig、CausalAttention、Block、PoetryGPT 的顺序阅读。前两者说明尺寸与注意力计算,Block 把一层组合起来,PoetryGPT 再串联多层。如果某一段看不懂,回到该部件对应的小实验,用两三个位置的小输入打印数字。
positions = torch.arange(length, device=tokens.device)
hidden = self.dropout(self.characters(tokens) + self.positions(positions))
for block in self.blocks:
    hidden = block(hidden)
logits = self.output(self.final_norm(hidden))
ModuleList 告诉 PyTorch 这些层是模型的一部分,需要统计参数、移动设备、保存和恢复。不要把带参数的层藏在普通未注册列表里,否则可能遗漏优化与保存。
输出层将 C 项信息映射为 V 个分数。由于与输入字表共用参数,对某个字的打分可以看作当前位置表示与那个字的参数向量之间的匹配。实际效果仍取决于前面所有层共同学到的计算。
认识正式配置
右侧选择“观察真实模型”,前文填“春江”,点击运行。候选字条形图来自保存的模型实际计算;显示的是只在汉字范围内重新归一化的概率,没有加入温度和 top-k 筛选。下方可切换第一层的不同注意力头,观察最后一个输入位置如何参考各个位置。某个权重大,不代表这个位置独自决定了诗意:后面还有其他层和计算。
正式配置宽度 256、4 个头、4 层、前文长度 64。本次字表为 6646 项,模型有 4,877,312 个参数。纯 float32 参数约 18.6 MiB,但训练还要保存梯度、优化器状态和中间计算,因此模型文件大小不能等同于训练内存。
层数增加会重复 Block;宽度增加会扩大许多矩阵;头数在固定宽度下改变分组方式;字表增加会扩大查表与输出部分。这些改动影响的计算不同。先用本课的小配置做尺寸实验,再改正式训练设置。
验收与排错
- 能从输入一路写出输出尺寸,明确 B、T、C、V 的含义。
- 能指出源文件中每个部件对应哪节课。
- 输出应是原始分数,训练评分函数内部再计算概率。
- 输入长度超过配置时程序会明确报错,不能靠截断任意条件掩盖限制。
回到真实 GPT 源码
下面是当前 model.py 的实际源码节选。带着“输入是什么、经过哪些计算、最后输出什么”三个问题阅读;targets 是给训练用的标准答案,生成时不提供它。
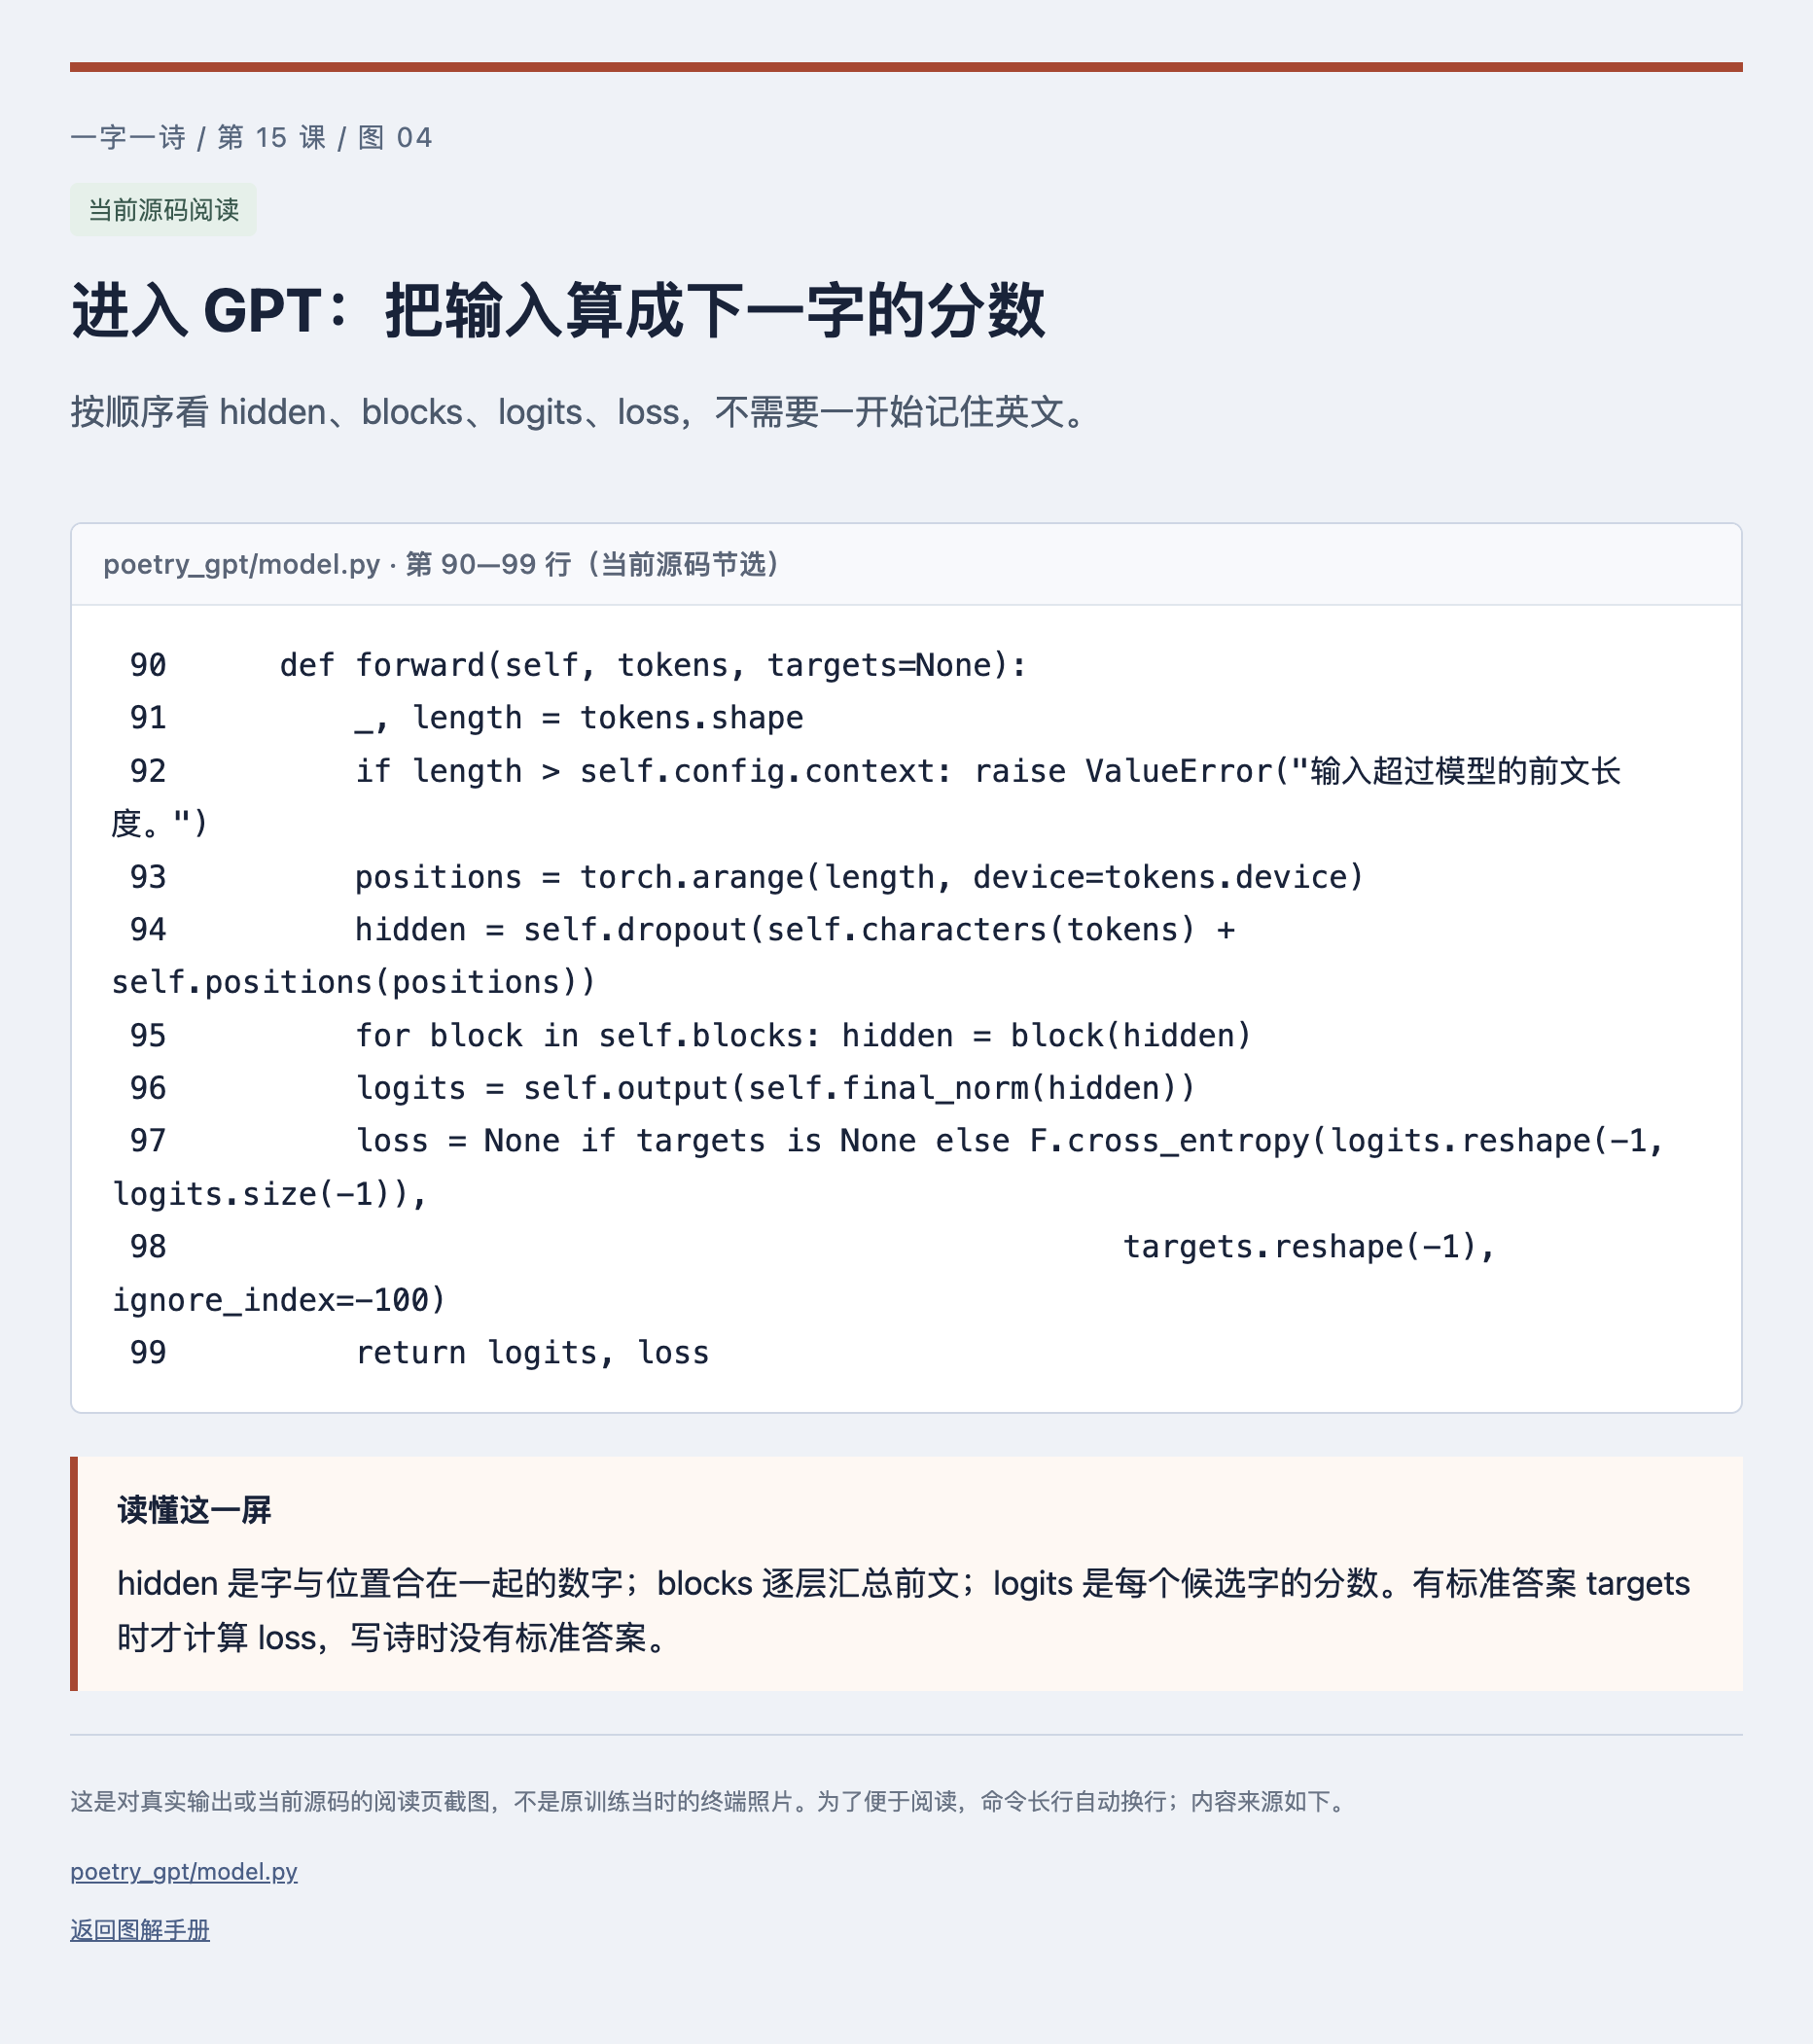
进入 GPT:把输入算成下一字的分数
- 先看哪里
- 按顺序看 hidden、blocks、logits、loss,不需要一开始记住英文。
- 这说明什么
- hidden 是字与位置合在一起的数字;blocks 逐层汇总前文;logits 是每个候选字的分数。有标准答案 targets 时才计算 loss,写诗时没有标准答案。
- 你接着做
- 回到第 8—14 课逐个对应这些部件,再运行第 15 课实验查看尺寸。
小练习与答案
如果只把小实验层数从 2 改成 3,字表参数和位置参数会改变吗?
查看答案
不会,它们的尺寸仍由字表大小、前文长度和宽度决定。增加的是一个完整 Block 的参数与中间运算。可以在 experiment.py 修改 layers,再查看 parameter_count;同样输入的输出尺寸仍为 [1,3,100]。