这一课完成什么
把模型、材料、评分与更新连接成完整训练循环。先让模型学会一道很小的题,验证计算链路;随后使用真正的诗词材料开始训练。小题成功只说明程序有学习能力,不等于已经能写好新诗。
一次参数更新,分成可以观察的动作
要把前向计算、评分、反向求梯度、修改参数连接起来。只计算误差而不更新,重复运行多少次也不会学会。
用文字逐步读这张图
- 取一批题:x 是已知输入;y 是下一字答案
- 清空旧梯度:zero_grad;防止无意累加
- 预测并评分:model(x, y);得到 loss
- 求出调整方向:loss.backward;梯度写到参数上
- 控制大变化:clip_grad_norm;避免偶发过大步子
- 真正更新:optimizer.step;随后记 step 并继续
训练 50 步,是完整看过材料 50 遍吗?
不是。每步抽一批题,本程序并不按整卷一遍一遍计数。
一张图看懂一次训练更新
- 先看哪里
- 先从左上角读到右上角,再沿红线走到左下角。
- 这说明什么
- 模型要反复经历预测、对照答案、更新参数;网页里的阅读本身不会训练模型。
- 你接着做
- 把每一格对应到下一张训练循环源码截图。
先确认一道题能学会
./poet lesson 16实验始终用 [1,2,3,4] 预测 [2,3,4,5]。本次 CPU 实测误差从约 2.504 降至第 30 次的 0.055。你的末尾小数可能不同,但应该明显下降。若连这道题都学不会,先检查目标错位、梯度、优化器和遮挡,再投入完整训练。
optimizer.zero_grad(set_to_none=True)
_, loss = model(x, y)
loss.backward()
torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
optimizer.step()
梯度裁剪在更新前限制整体梯度大小,防止偶发过大的变化破坏训练。它不能替代正确的学习率或材料检查。
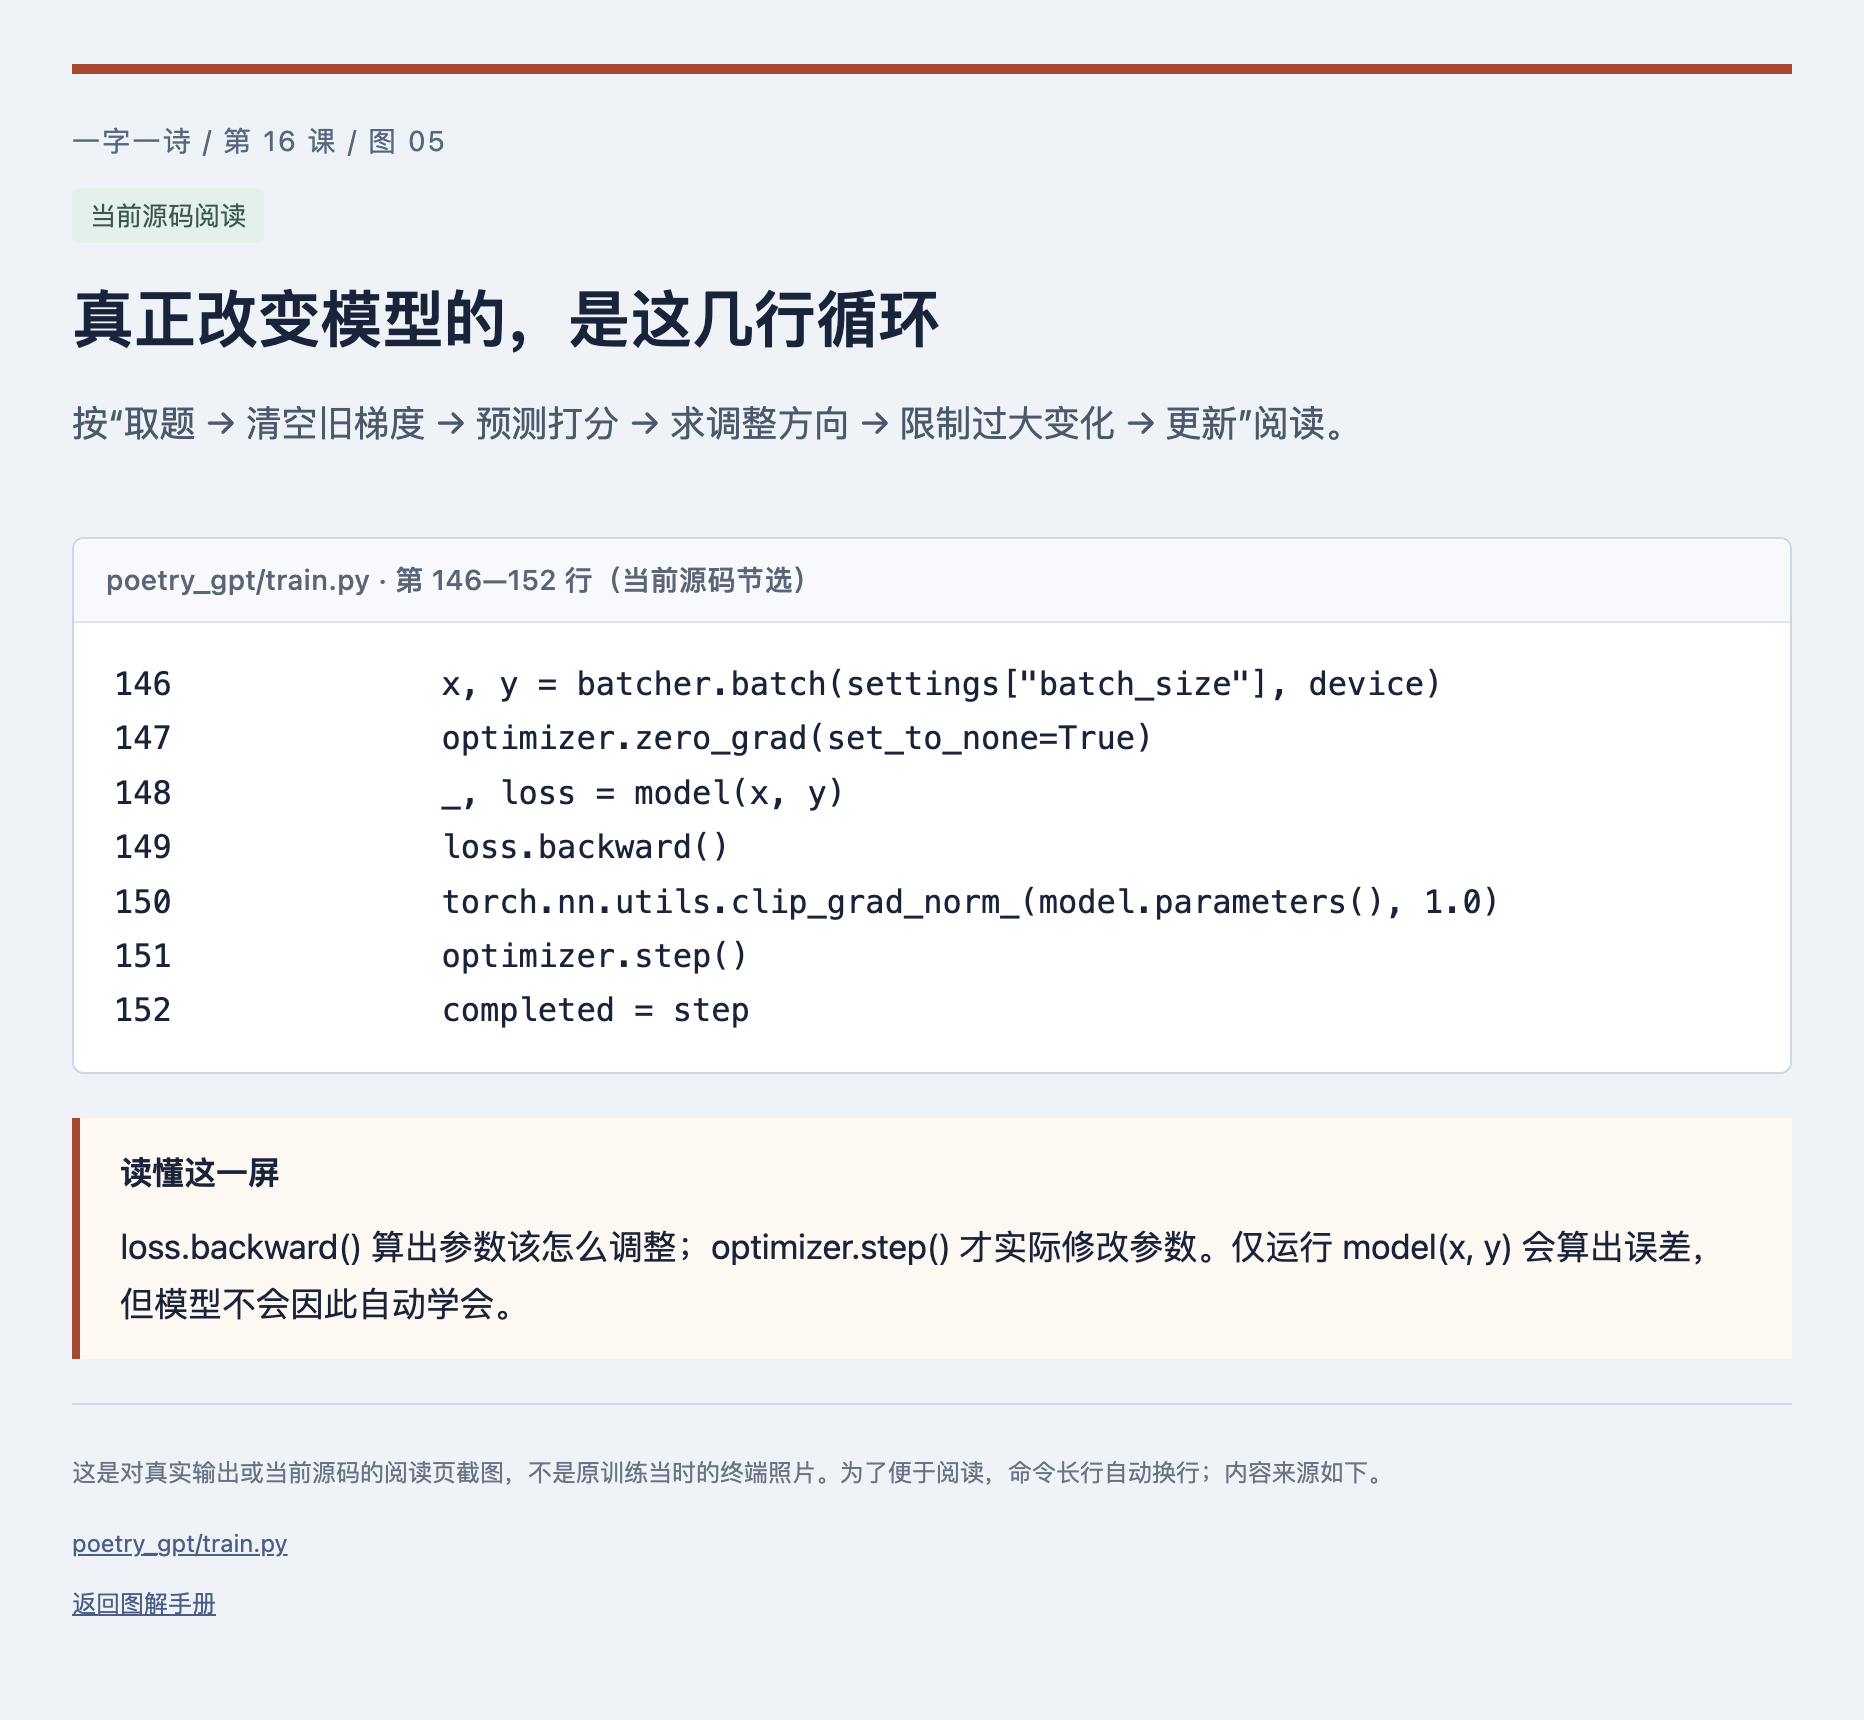
真正改变模型的,是这几行循环
- 先看哪里
- 按“取题 → 清空旧梯度 → 预测打分 → 求调整方向 → 限制过大变化 → 更新”阅读。
- 这说明什么
- loss.backward() 算出参数该怎么调整;optimizer.step() 才实际修改参数。仅运行 model(x, y) 会算出误差,但模型不会因此自动学会。
- 你接着做
- 运行 ./poet lesson 16,观察同一道小题的误差是否下降,再启动诗词短跑。
开始自己的短跑
已交付模型保存在 artifacts/runs/poet。练习时另开目录,保持两次实验可以比较。
./poet train --config configs/tiny.json --run-dir artifacts/runs/my-first --steps 50 --batch-size 24 --device auto这会先建立随机模型,记录训练前验证误差,然后训练 50 步。一次“步”是取一批题、计算、求梯度、更新参数。它不同于读完全部材料一遍;本程序按固定随机序列抽题,同一首可能重复抽到。
短跑完成应有 initial.pt、best.pt、latest.pt、metrics.jsonl、run.json。50 步通常不足以生成自然古诗,先核对进度、误差和文件保存是否正常。
在网页操作时,点击上方命令的“在右侧运行”,检查是小模型、50 步、每批 24 条,再点击“运行并观察”。右侧先显示准备与训练前成绩,之后出现步数、真实日志和误差曲线。开始阶段没有输出通常是在加载材料或计算验证成绩;先等待,不要重复启动。
右侧会给这次练习创建 artifacts/workbench/runs/wb-… 目录。训练完成后,选择“检查模型误差”或“用本地模型写诗”,并在模型列表里选这次练习;默认选项仍是已经训练好的正式模型。整理材料练习会另存一份清洗结果,训练默认使用包内已准备好的 artifacts/data/。
下面为本次实际复现的截图,使用单独的 illustrated-demo 目录。你的命令使用 my-first,避免撞上现有进度。本机 auto 会选择 mps;若选中 cpu,速度和末尾小数可能不同。
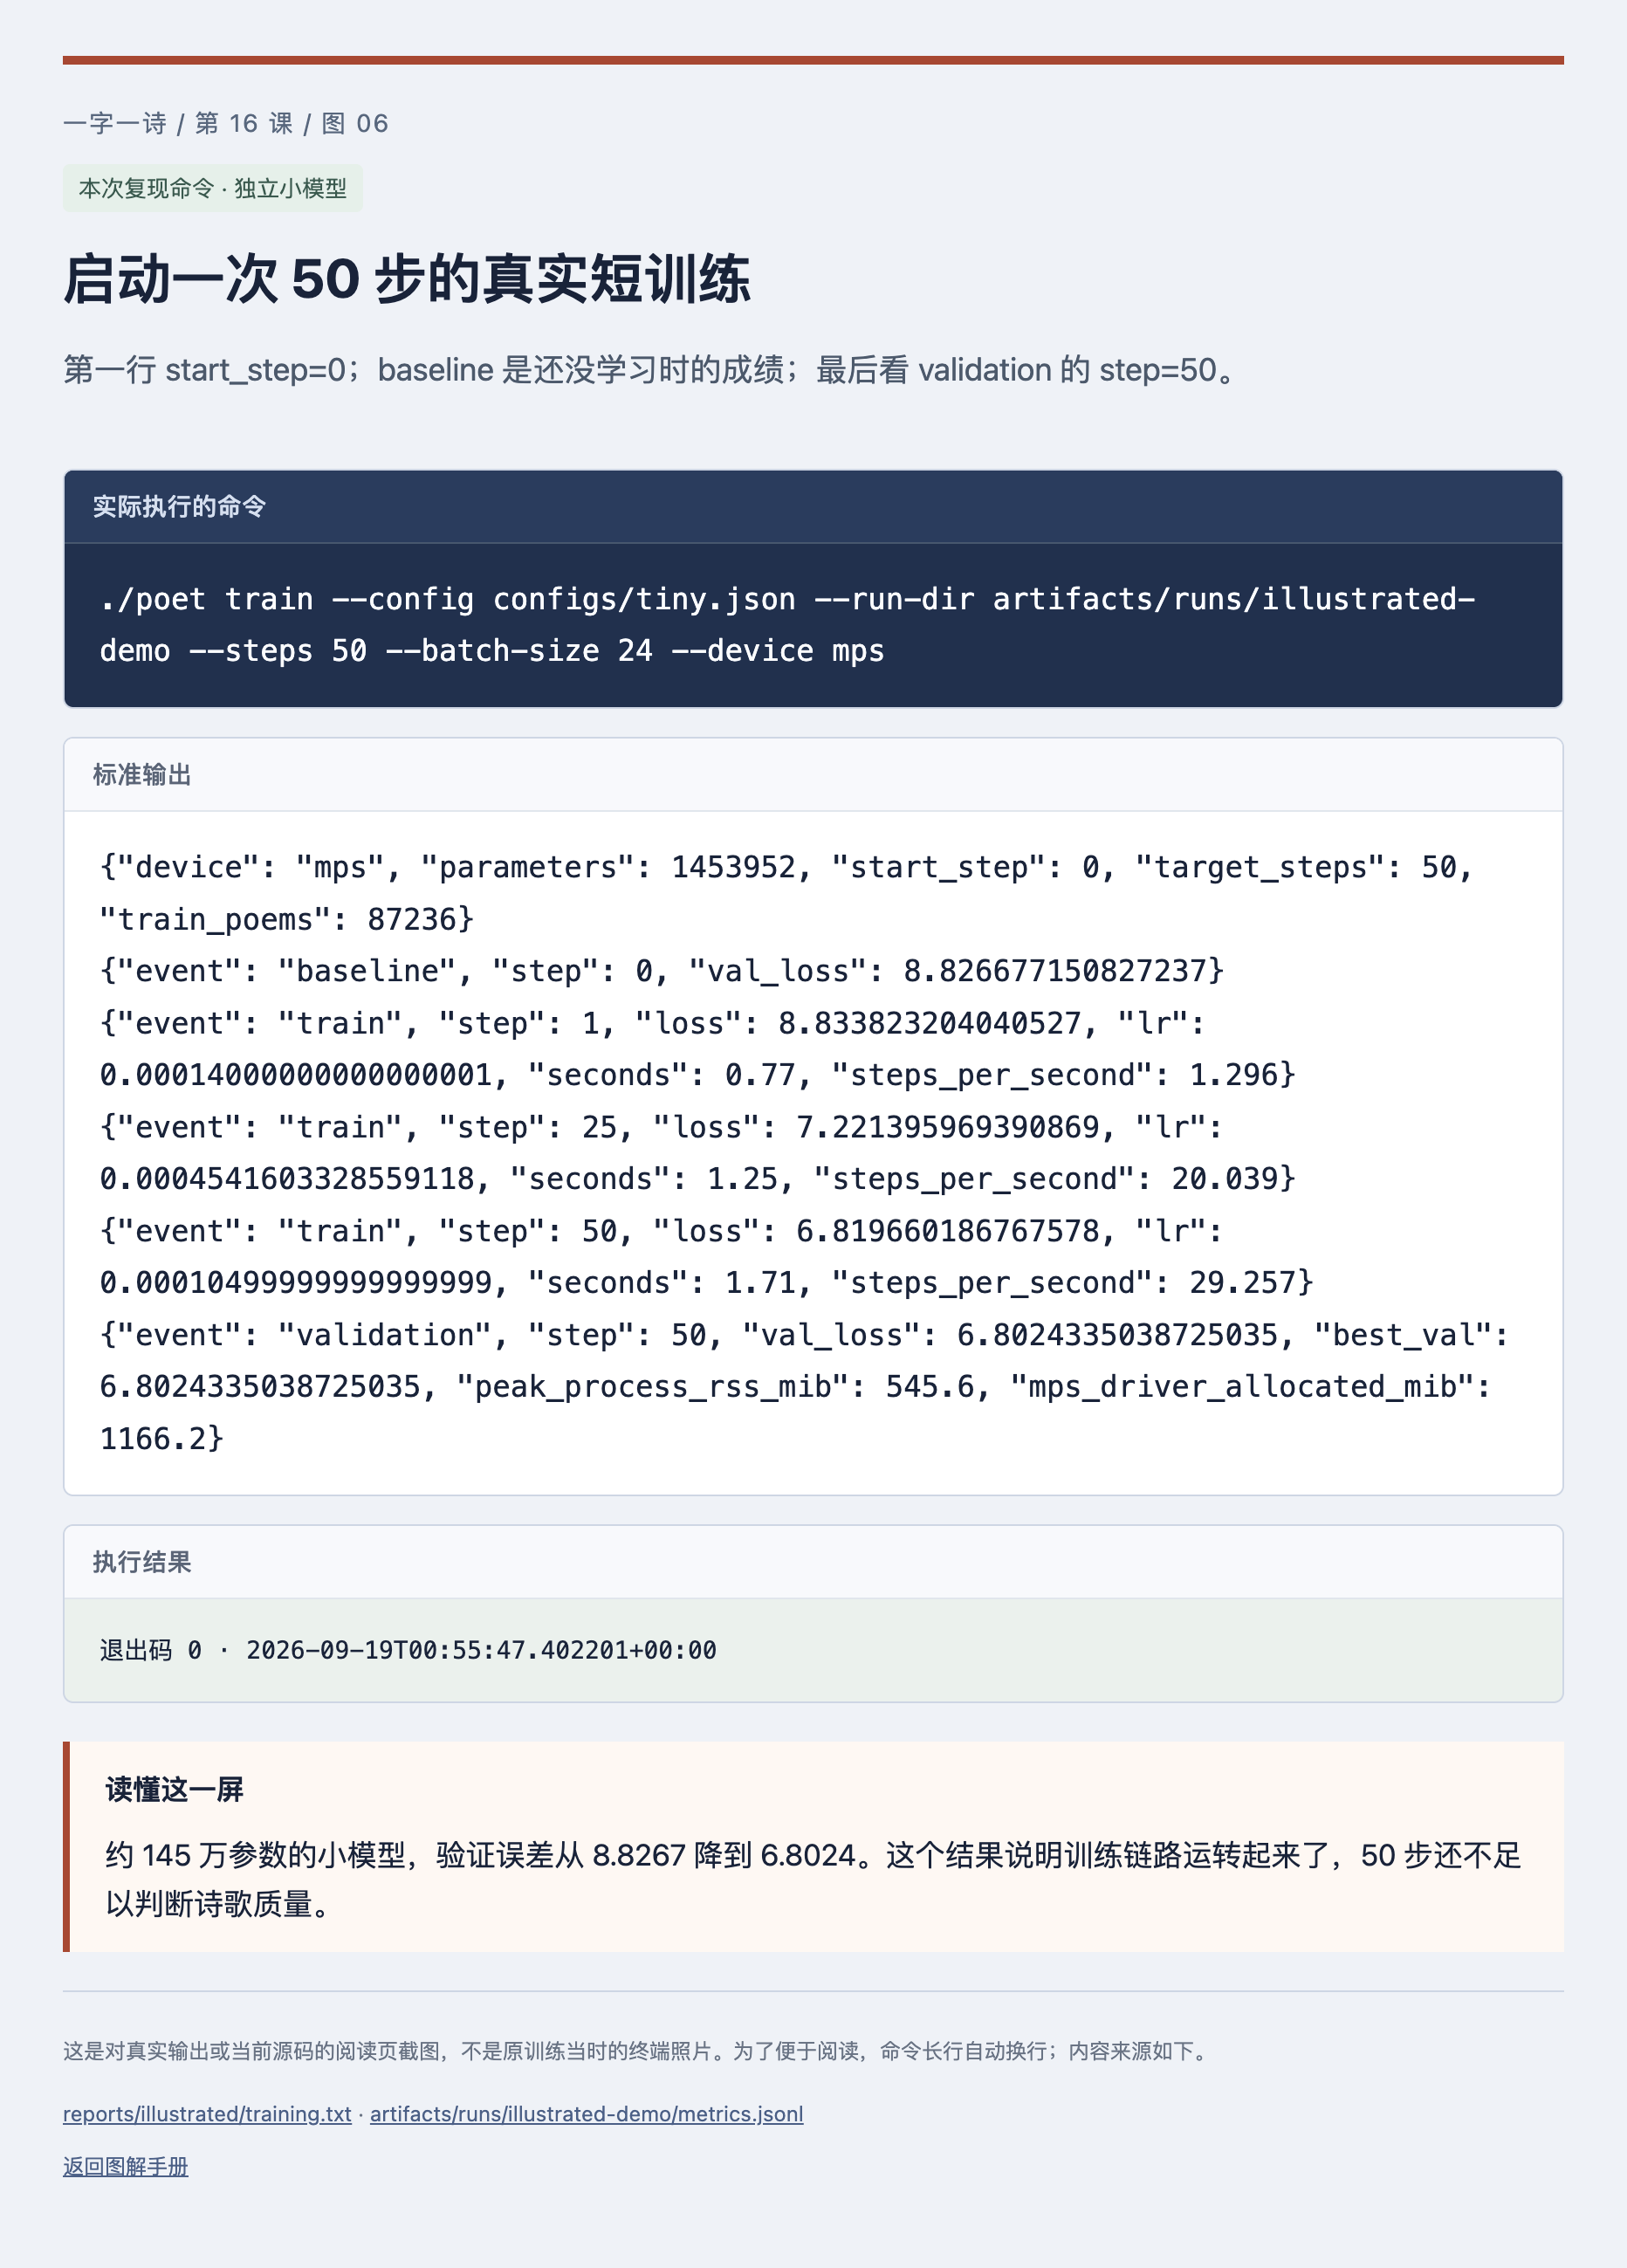
启动一次 50 步的真实短训练
- 先看哪里
- 第一行 start_step=0;baseline 是还没学习时的成绩;最后看 validation 的 step=50。
- 这说明什么
- 约 145 万参数的小模型,验证误差从 8.8267 降到 6.8024。这个结果说明训练链路运转起来了,50 步还不足以判断诗歌质量。
- 你接着做
- 用第 16 课的新目录命令自己跑 50 步;检查 run.json 与 latest.pt 是否出现。不要照抄已经有进度的演示目录。
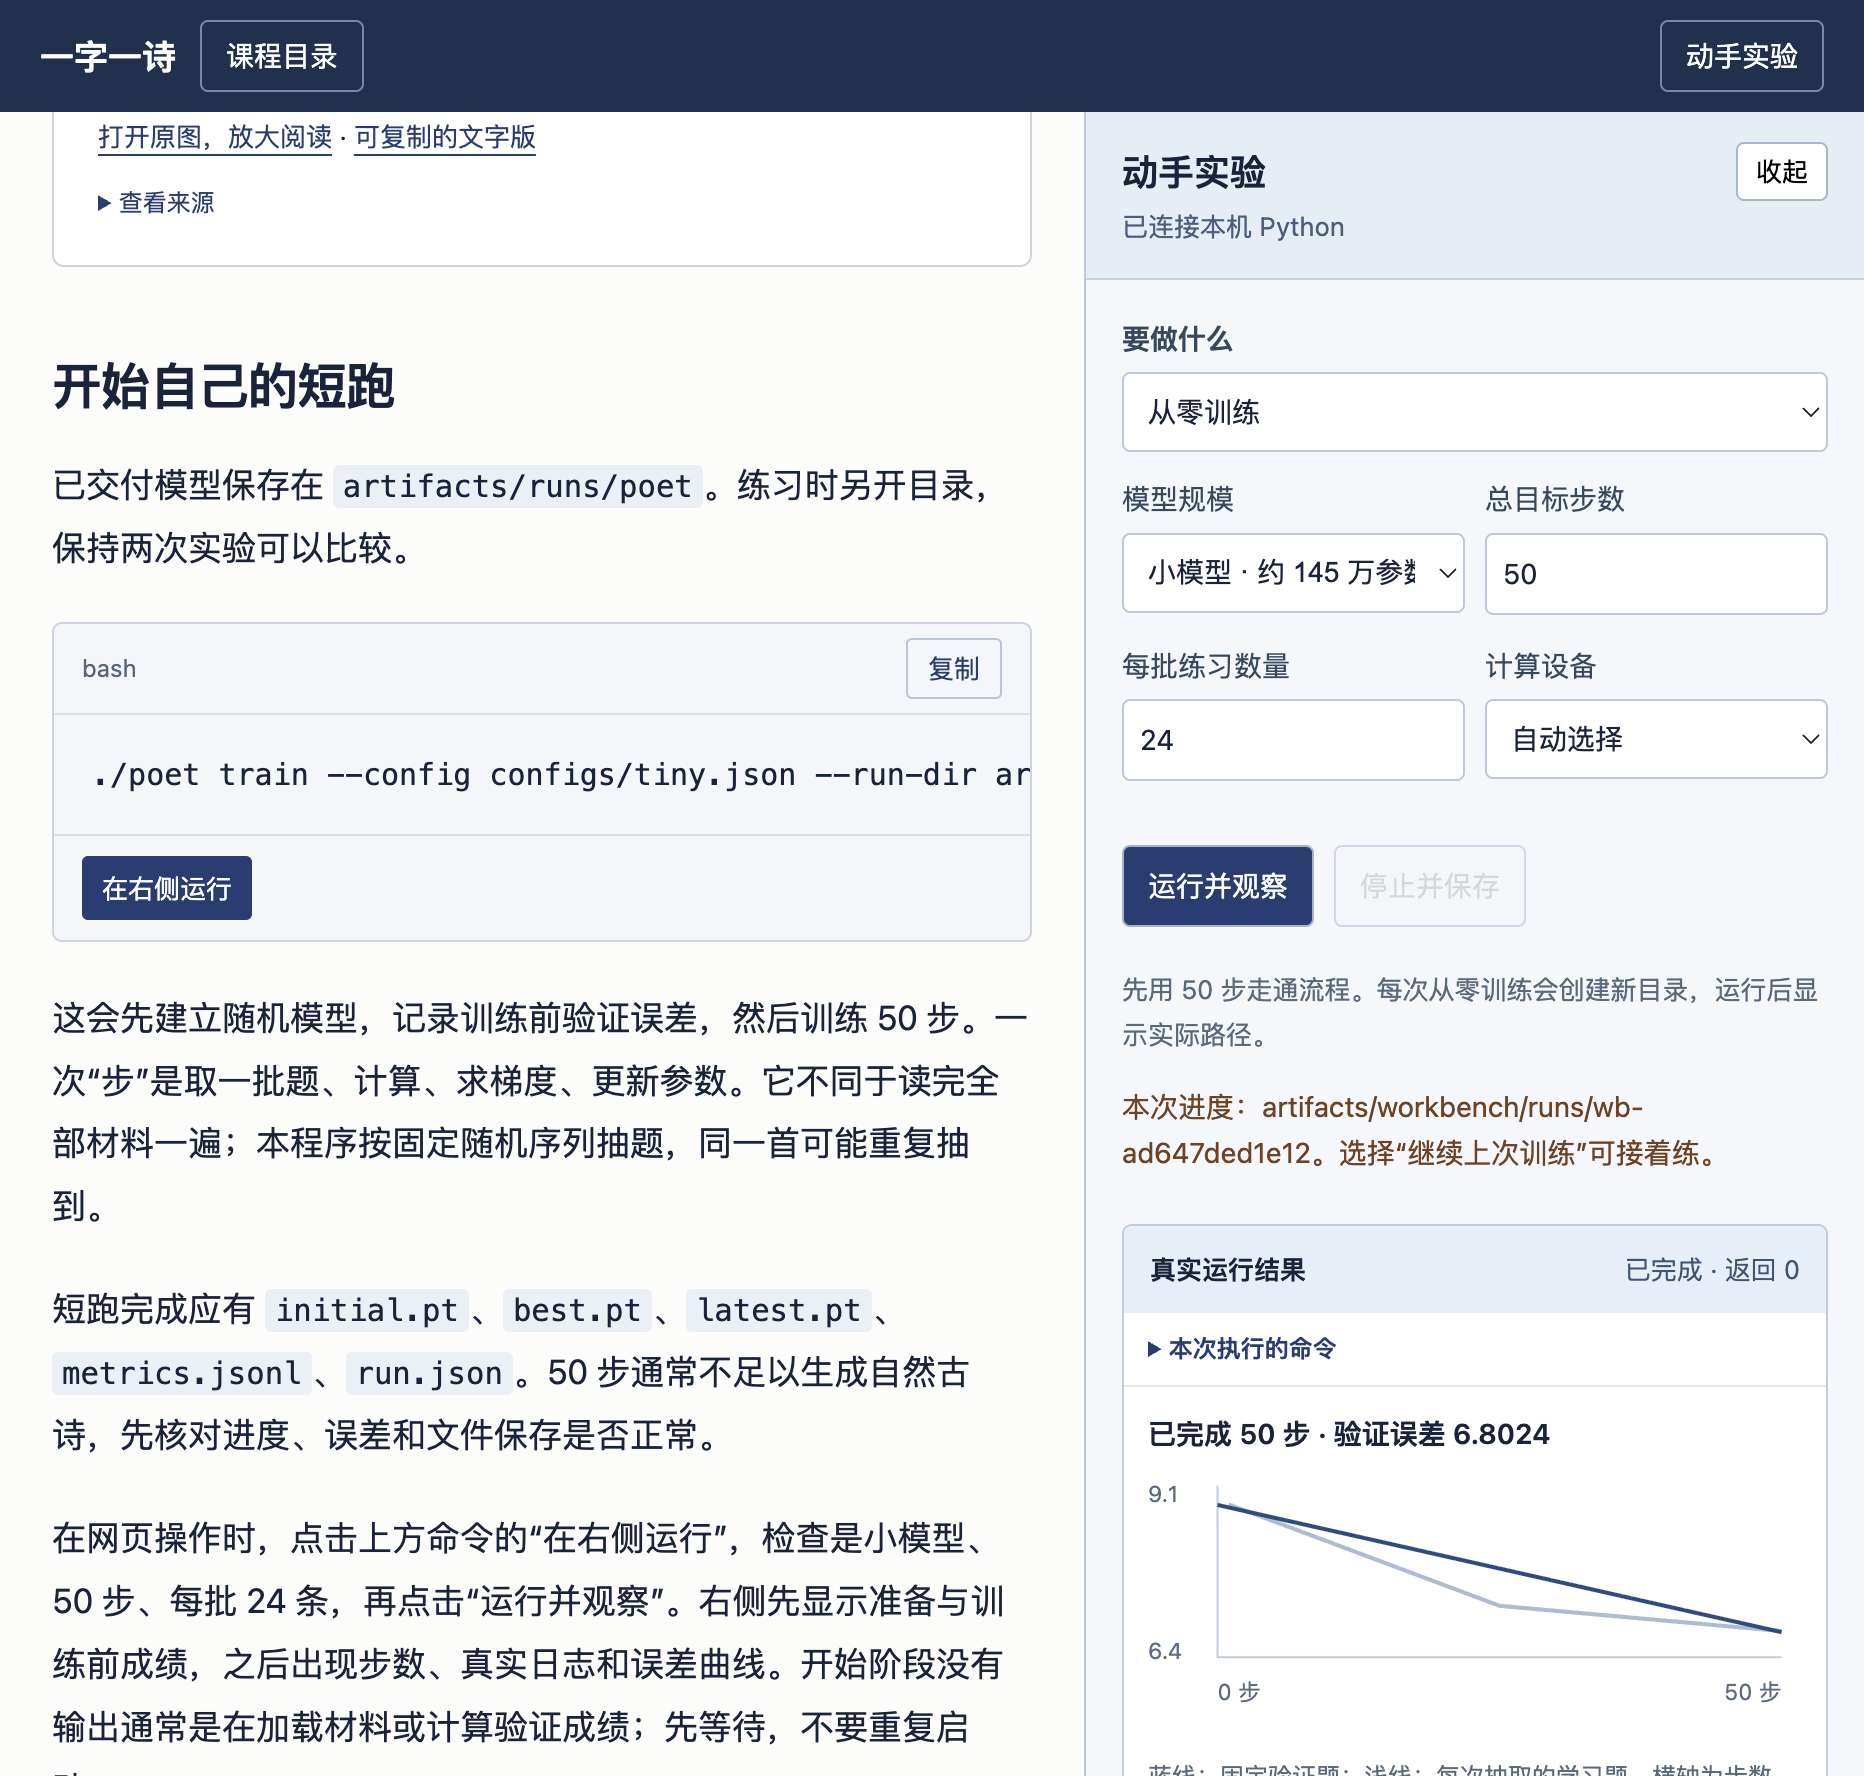
把一次训练的设置和成绩连起来
- 先看哪里
- 右侧是小模型、50 步、每批 24 条。结果区显示已完成 50 步,验证误差约 6.8024。
- 这说明什么
- 这些数字来自本机新建的训练进程。蓝线使用固定验证题,浅线来自每次抽取的学习题;短跑能说明学习过程有效,但还不能保证写诗质量。
- 你接着做
- 向下滚动右侧查看完整日志和实际目录,再到第 18 课选择同一记录继续到 75 步。
完整练习的命令
./poet train --config configs/poet.json --run-dir artifacts/runs/my-poet --device auto默认目标来自配置文件,初始完整配置为 6000 步。不要同时开很多训练进程;它们会争用图形处理器和内存。若本机较忙或想缩短试验,先使用 tiny 配置。训练每 25 步写一条学习记录,按配置间隔做固定验证并保存进度。
读懂一行记录
step 是已完成更新次数;loss 是刚才那批题的误差;lr 是本步调整幅度;steps_per_second 是从本次启动以来的平均速度。不同批次难度不同,loss 会波动。验证记录使用固定题目与条件,更适合比较阶段变化。
首次执行可能花时间准备计算,因此不要用第 1 步推算全部耗时。至少观察几十步后的速度。按 Ctrl+C 会尝试保存最新完成进度,断电或强制终止则只能回到最近一次已经写好的文件。
完整训练结束后应该留下什么
下面从原先正式训练的存档中读取数字,和本课 50 步演示分开。status 为 finished,step 达到 18000,同时保存 best、latest 和完整日志,才能确认这轮训练完成。曲线与阶段对比接着看第 17、19 课。
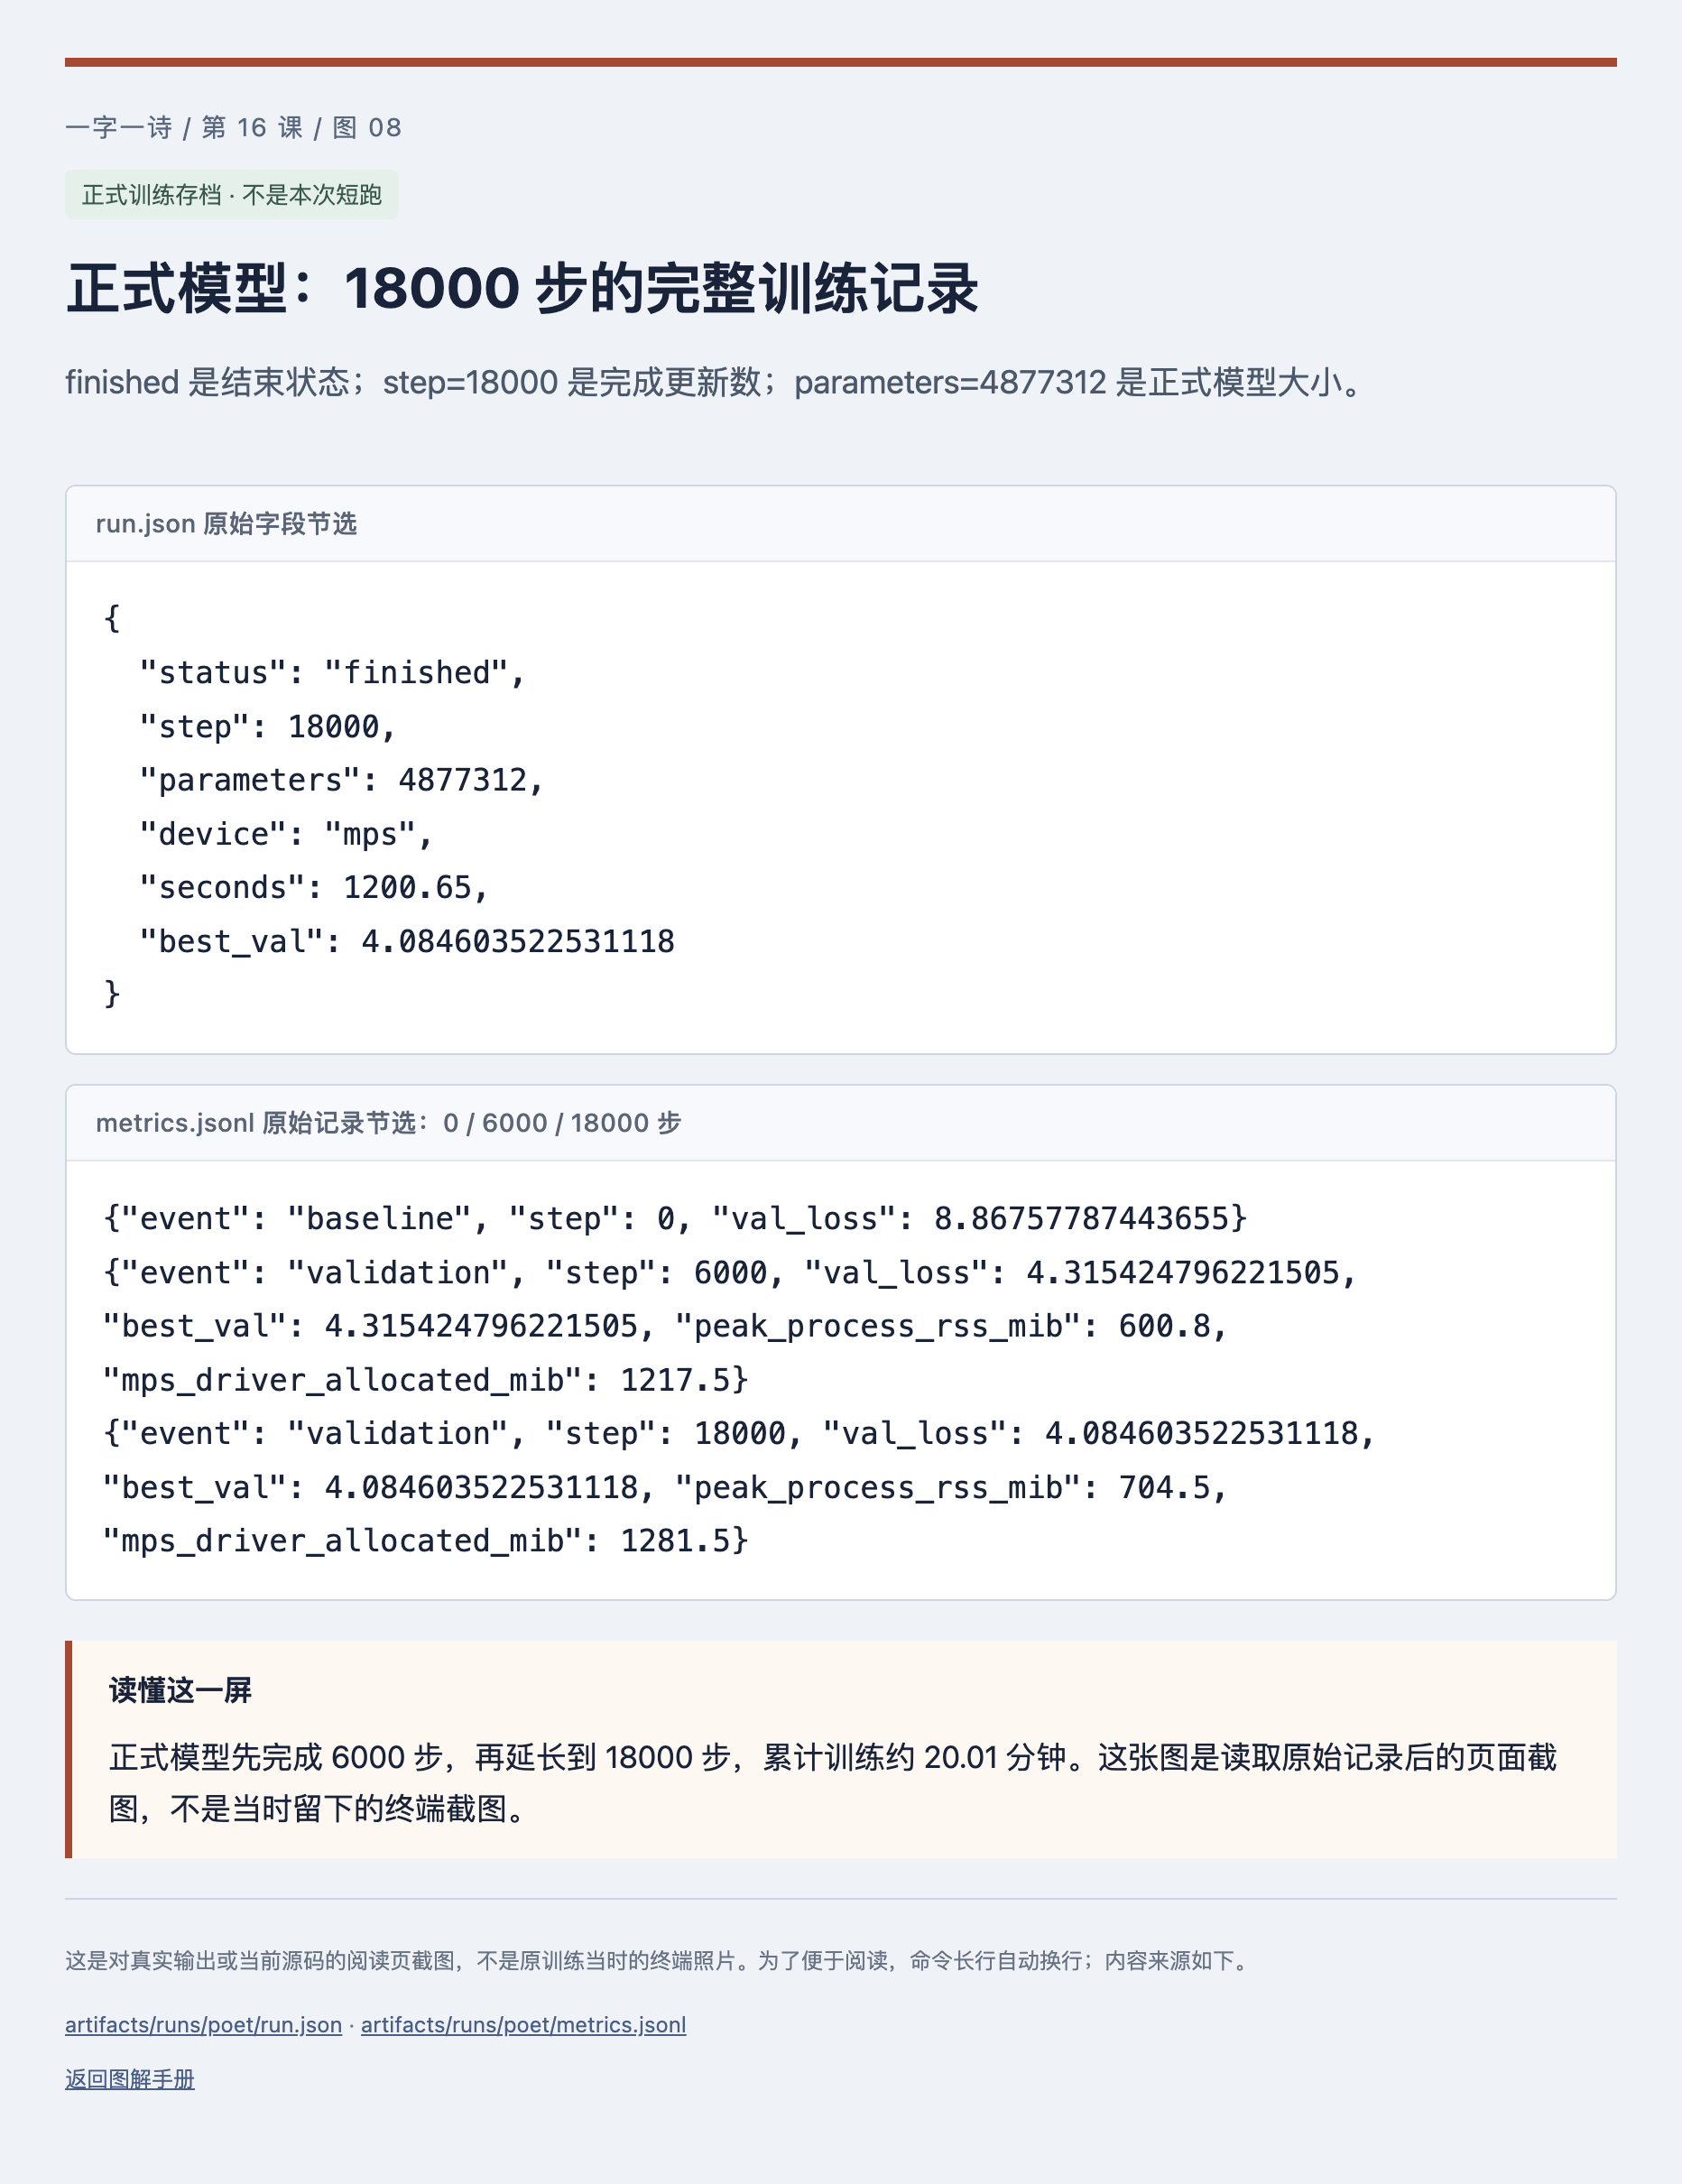
正式模型:18000 步的完整训练记录
- 先看哪里
- finished 是结束状态;step=18000 是完成更新数;parameters=4877312 是正式模型大小。
- 这说明什么
- 正式模型先完成 6000 步,再延长到 18000 步,累计训练约 20.01 分钟。这张图是读取原始记录后的页面截图,不是当时留下的终端截图。
- 你接着做
- 打开下方完整日志或训练曲线,既看中间的波动,也看最终结果;不要只截一个好看的数字。
验收与排错
- 小题实验误差明显下降。
- 短跑到达指定 step,模型文件存在,日志可读。
- 若提示目录已存在,换新目录或按第 18 课恢复;不要无意覆盖已有实验。
- 若内存不足,先降低
--batch-size,其次选 tiny;记录改动再比较。
小练习与答案
同一道题误差接近 0,能说明模型能写新诗吗?
查看答案
不能。它可能只记住了这道题。这个实验用于排查学习机制是否接通。实际能力要用未参与参数更新的材料和固定生成题检查,并查看原诗重复情况,见第 19、25 课。