这一课完成什么
判断模型究竟在进步,还是只是越来越熟悉已经练过的诗。我们用三份材料和两类证据:预测原文的误差,以及实际生成的诗。两类证据各有范围,不能互相代替。
分清:练习成绩,还是新题能力
训练材料负责更新参数,验证材料帮助选择版本,测试材料留给最终检查。三者用途不同,不能反复看测试成绩调设置。
用文字逐步读这张图
- 学习材料:训练中反复接触;梯度来自这里
- 验证材料:不用于参数更新;选择最佳版本
- 保留测试:最后再检查一次;避免反复挑答案
- 都在改善:可能学到可迁移规律;仍需看实际诗文
- 一降一升:学习误差降、验证升;可能开始背熟
- 选回最佳:best 不一定最新;解释抽样与限制
验证误差 4.1 是 41% 准确率吗?
不是。它是按有效字数加权的负对数误差,不能直接换成准确率。
三份材料各自的职责
训练卷用来更新参数;验证卷不更新参数,用于选择最佳阶段和比较设置;测试卷保留到最后再看。若反复根据测试成绩改设置,它事实上就成了另一份验证卷,最后成绩会过于乐观。
本次整理后有 87,236 首训练诗、4,869 首验证诗、4,790 首测试诗。每份的五七言比例并不相同,宋诗数量也明显多于唐诗。报告应说明材料范围,不把它称为所有古典文体的通用能力。
./poet lesson 19
./poet evaluate --split val --batches 30 --output reports/my-validation.json评估使用固定随机种子抽取练习题和关键词条件,按实际评分字数加权。默认是抽样评估,不是逐首遍历全卷;输出会注明这个范围。模型处于评估模式,关闭随机丢弃,并且不计算用于更新参数的梯度。
怎样读两条曲线
如果学习误差和验证误差一起下降,通常说明学到的规律对保留材料也有帮助。如果学习误差继续下降而验证误差持续上升,可能开始过度记忆学习材料,这种现象常叫“过拟合”。但一次小波动也可能是噪声,应看连续趋势。
教学示意:
阶段一  学习 7.2   验证 7.3
阶段二  学习 5.1   验证 5.3
阶段三  学习 3.2   验证 5.6
这三行是为了说明判断方法,不是正式训练测量。面对这种趋势,可以回到验证最佳版本、缩小模型、增加可靠材料、调整训练时长或随机丢弃比例。每次改动都需要重新用同一验证方法比较。
生成质量另开一张检查表
预测误差衡量模型给原文下一个字多大概率;生成时要在多种候选间选择,还受到格式规则和候选筛选影响。因此误差下降不保证每首新诗都更好。固定一组首字和关键词,每次保存全部输出,逐项检查句法自然、意思连贯、是否切题、重复、原诗重现。
本项目会检查与已整理原诗的整首精确重复,但这不能证明绝对原创:片段重复、近似改写和语料库以外的作品仍需要更深入检查。文学质量也需要人工阅读,不能只用关键词出现率代替。
验收与排错
- 能说明三份材料为什么分开,以及测试卷什么时候使用。
- 验证过程没有调用
optimizer.step()。 - 报告注明是固定抽样还是完整遍历,不扩大数字的意义。
- 对照生成使用同样的条件、候选数和随机种子,保留失败样例。
看懂正式模型的评估画面
同一组验证抽样才适合比较模型阶段。下面前三行沿用相同验证抽样,最后一行换为保留测试材料。图中每次 60 批、每批 32 条,与训练曲线的 12 批、每批 48 条不同,数值略有差异有其来源。
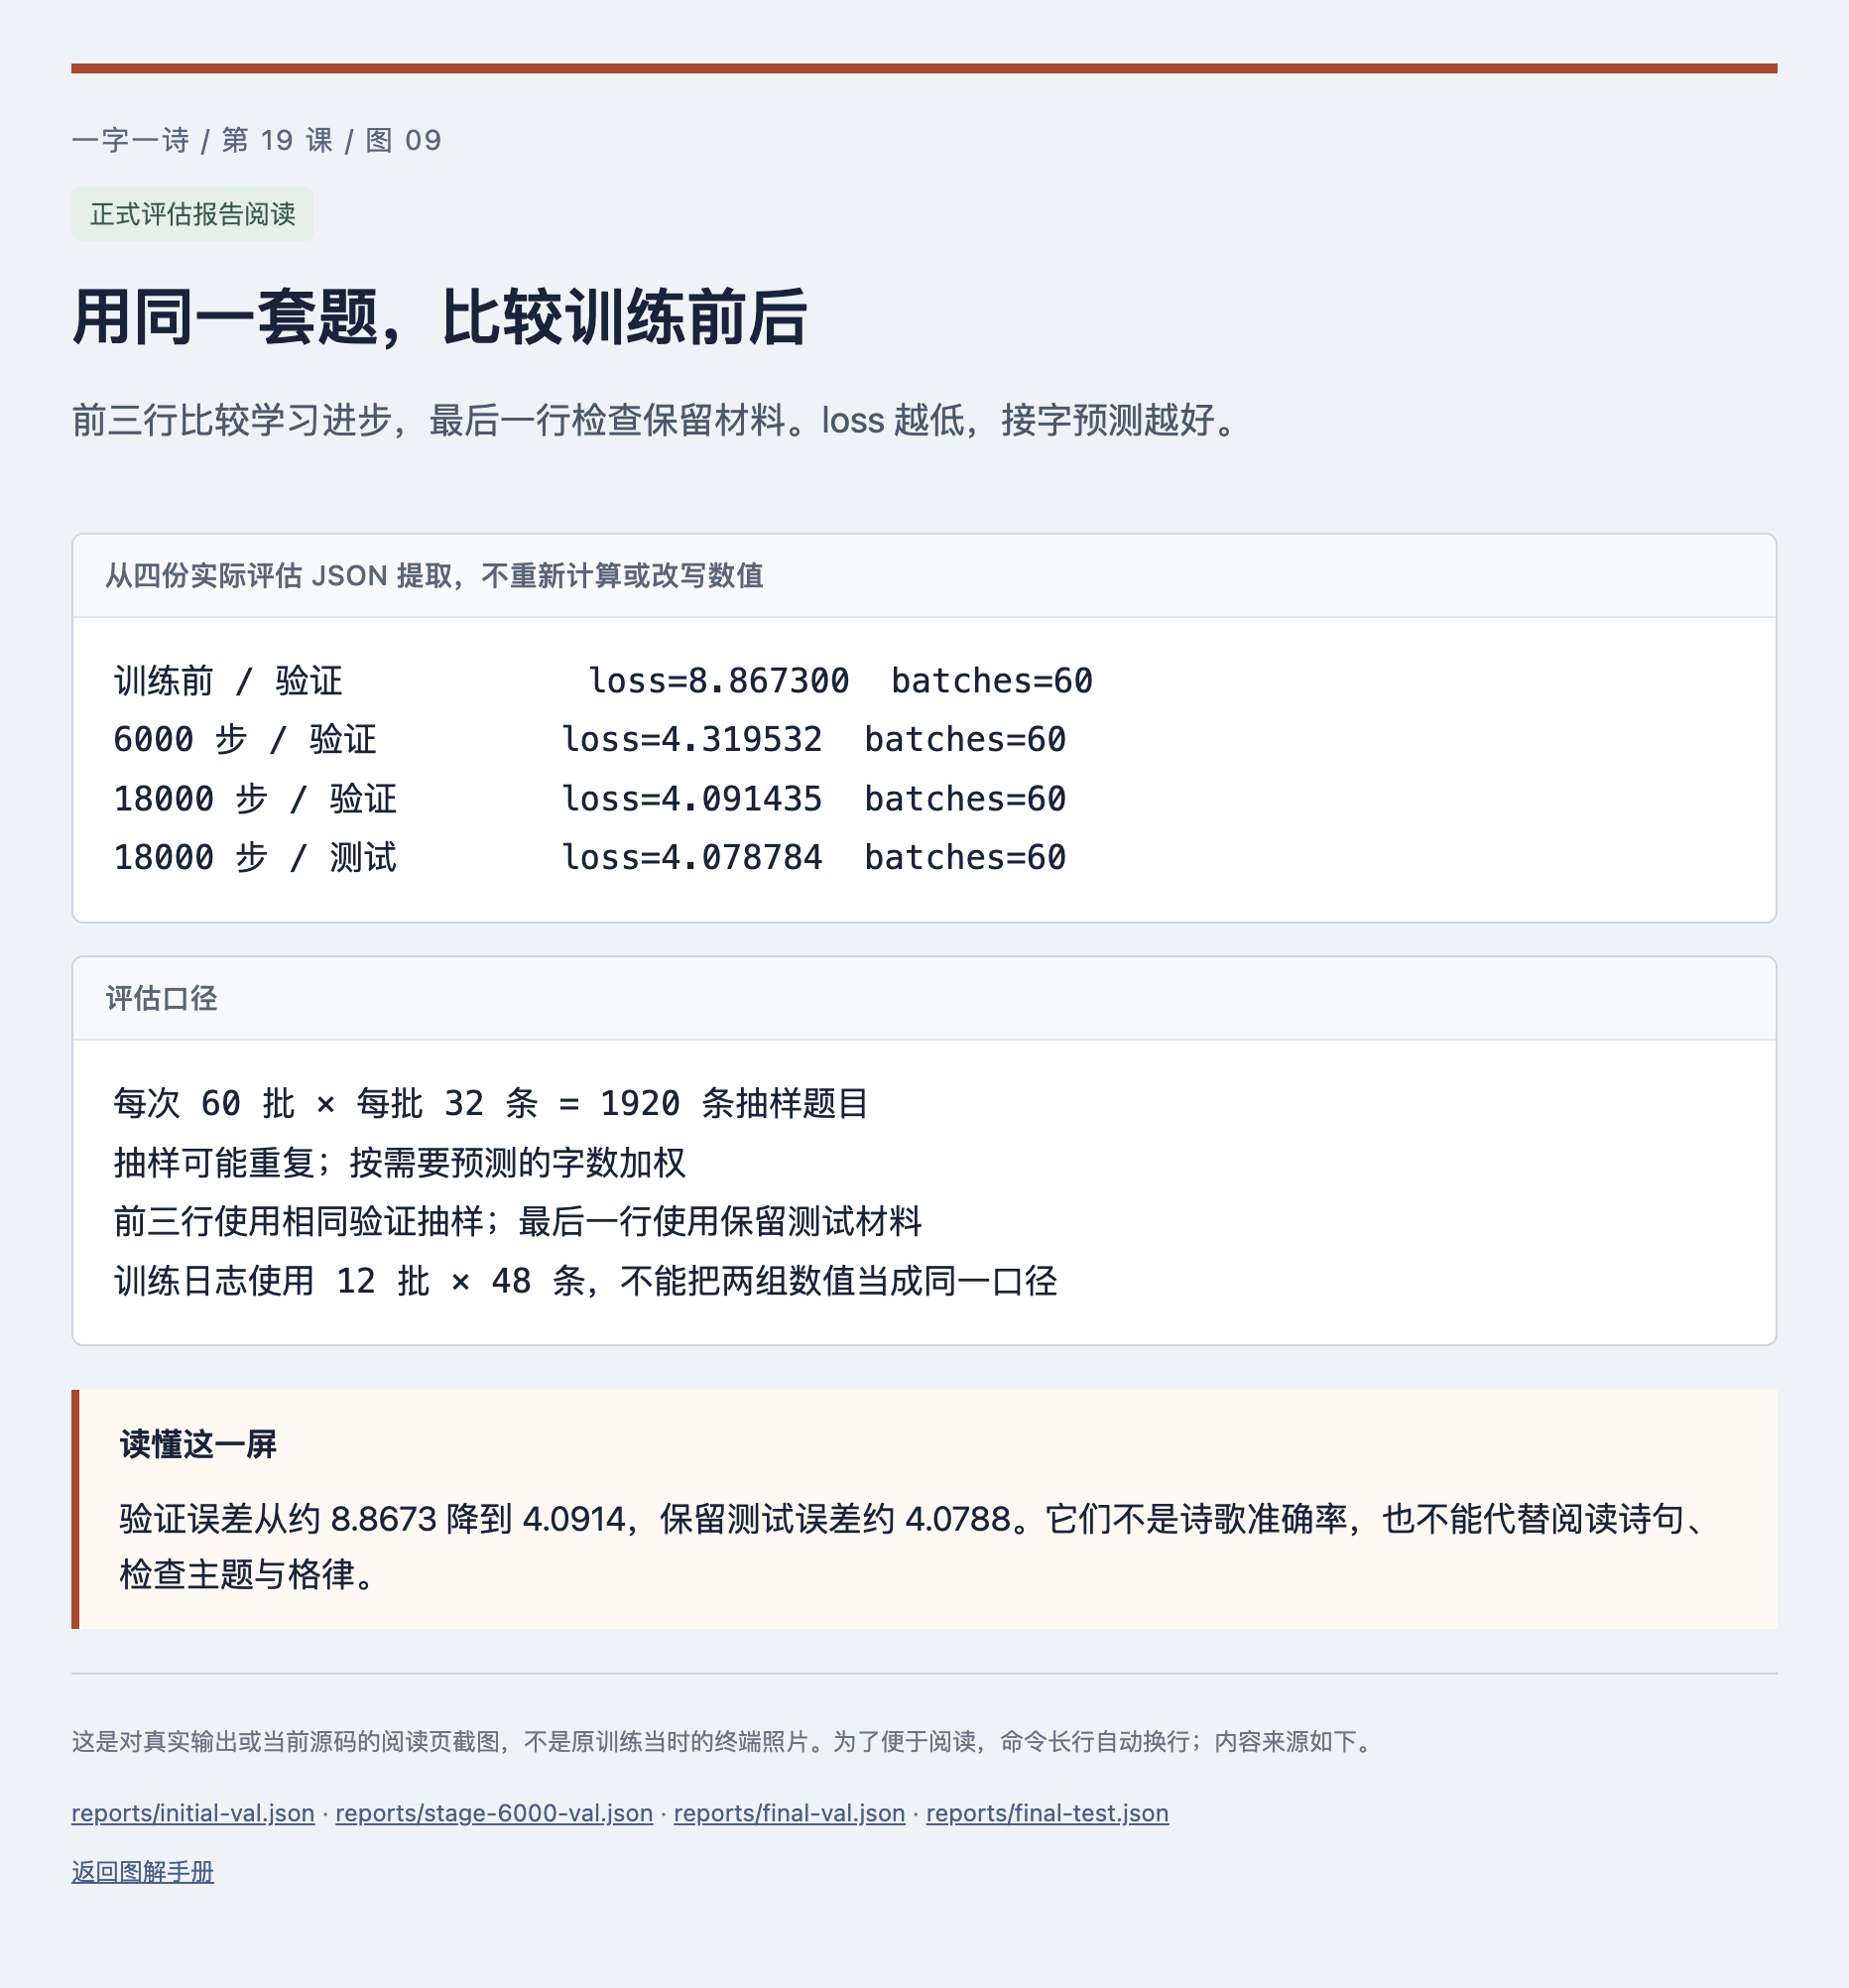
用同一套题,比较训练前后
- 先看哪里
- 前三行比较学习进步,最后一行检查保留材料。loss 越低,接字预测越好。
- 这说明什么
- 验证误差从约 8.8673 降到 4.0914,保留测试误差约 4.0788。它们不是诗歌准确率,也不能代替阅读诗句、检查主题与格律。
- 你接着做
- 用第 19 课的 evaluate 命令评估自己的模型,并明确记录抽了多少批题。
在右侧比较训练前后
选择“观察真实模型”,保持前文“春江”不变,先选“正式结构 · 尚未训练”,再选“已交付的正式模型”各运行一次。未训练时,候选字的概率通常很分散;训练后,一些接字方式会得到更高概率。保存两次输出再比较,避免同时改变前文。概率变集中不等于诗意一定更好,还要检查验证误差和真实诗文。
小练习与答案
模型的诗每句都恰好五个字,可以说明它学会了五言格式吗?
查看答案
在本项目里不能直接这样推断,因为生成程序会固定字数和标点位置。若要研究模型自身的格式学习能力,需要另做不施加格式约束的生成实验,并分别报告。当前产品验收检验的是“模型加控制程序”能否提供正确外形。