这一课完成什么
按需求逐项检查项目,并保存可复查的证据。程序不报错只是第一层。我们还要知道数据是否串卷、模型是否偷看答案、训练是否真实有效、CLI 是否按要求输出,以及课程命令能不能跟着跑。
把“能运行”拆成可检查的结果
验收不能只看程序最后有没有打印四行字。输入边界、材料隔离、因果遮挡、保存恢复和真实输出都需要对应检查。
用文字逐步读这张图
- 材料检查:三份卷不共享分组;字表版本一致
- 模型检查:未来不会影响过去;数字尺寸正确
- 学习检查:小题误差可以下降;训练保存能恢复
- 输入检查:非法数量等明确报错;不会假装成功
- 生成检查:首字、行数、字数;关键词如实记录
- 内容检查:语义、重复、主题;由人读懂再评价
故意输错时返回非零算失败吗?
它是一次预期的错误处理。验收要检查这个错误是否被正确发现并说明。
第一层:结构与计算
.venv/bin/python -m pytest -q核心测试包括:繁简去重、缺字隔离、相近版本归组、条件区与补齐区不评分、固定抽题状态恢复、未来字不影响过去输出、手写与优化注意力一致、小题能学会、参数保存恢复一致、生成格式、固定种子和异常输入。
这些测试明确验证了对应行为,没有证明模型文学水平。小模型随机参数也可以通过格式测试,因为格式有程序约束;真实训练效果要看下一层证据。
第二层:材料与训练记录
./poet lesson 25
./poet evaluate --split val --batches 30检查三份材料的组指纹交集为 0,检查 manifest.json 的原始文件摘要、排除理由和数量。打开训练日志,比较初始模型与最佳模型在同一固定验证方法下的误差;检查保存的 step、设备、配置与模型参数数。
最终测试卷应在模型与设置确定后使用:
./poet evaluate --split test --batches 60 --output reports/final-test.json该命令仍是固定抽样,报告不能写成“全测试卷逐首检查”。本项目的交付报告将分别列出抽样规模与模型阶段。
第三层:真实 CLI 行为
固定一组开头和关键词,覆盖五言、七言、多首输出、JSON、交互退出、错误输入、从其他目录调用。保存每次输入、输出、耗时和退出码。逐首检查开头、句数、每句字数、标点、内部标记和原诗整首重复。
.venv/bin/python scripts/verify_delivery.py验收脚本会运行课程实验、检查本地页面链接与源码入口,并调用真实训练模型。报告写入 reports/。完整检查需要模型已经训练完成,耗时会高于单次写诗。
第四层:人能否使用课程
在浏览器检查课程入口、搜索、代码复制、学习标记、交互图解和窄屏目录。再通过本机服务实际运行:正文命令带入参数、输出逐步出现、短训练结束、停止保存、恢复训练、选择练习模型写诗,以及刷新后查看历史记录。只打开静态 HTML 可以读课文和操作教学图解;启动 Python 实验需要本机服务。
若自动检查只确认链接存在,还要实际打开代表性页面查看排版;反过来,一张漂亮截图也不能证明 26 节内容和命令都能工作。
如何阅读交付证据
reports/lesson-experiments.json 保存逐课实验输出;reports/delivery.json 保存自动验收结果;训练目录保存原始曲线数据。真实训练与验收记录 引用本次测量并展示固定题目的全部输出。自动通过项、人工观察与尚未保证的文学能力分别写清楚。
报错也要按预期发生
有意输入不合法数量时,应该得到中文提示、没有诗文输出、返回码为 2。它是一项通过的错误处理检查,不代表模型训练失败。正常写诗与失败输入都应该验收。
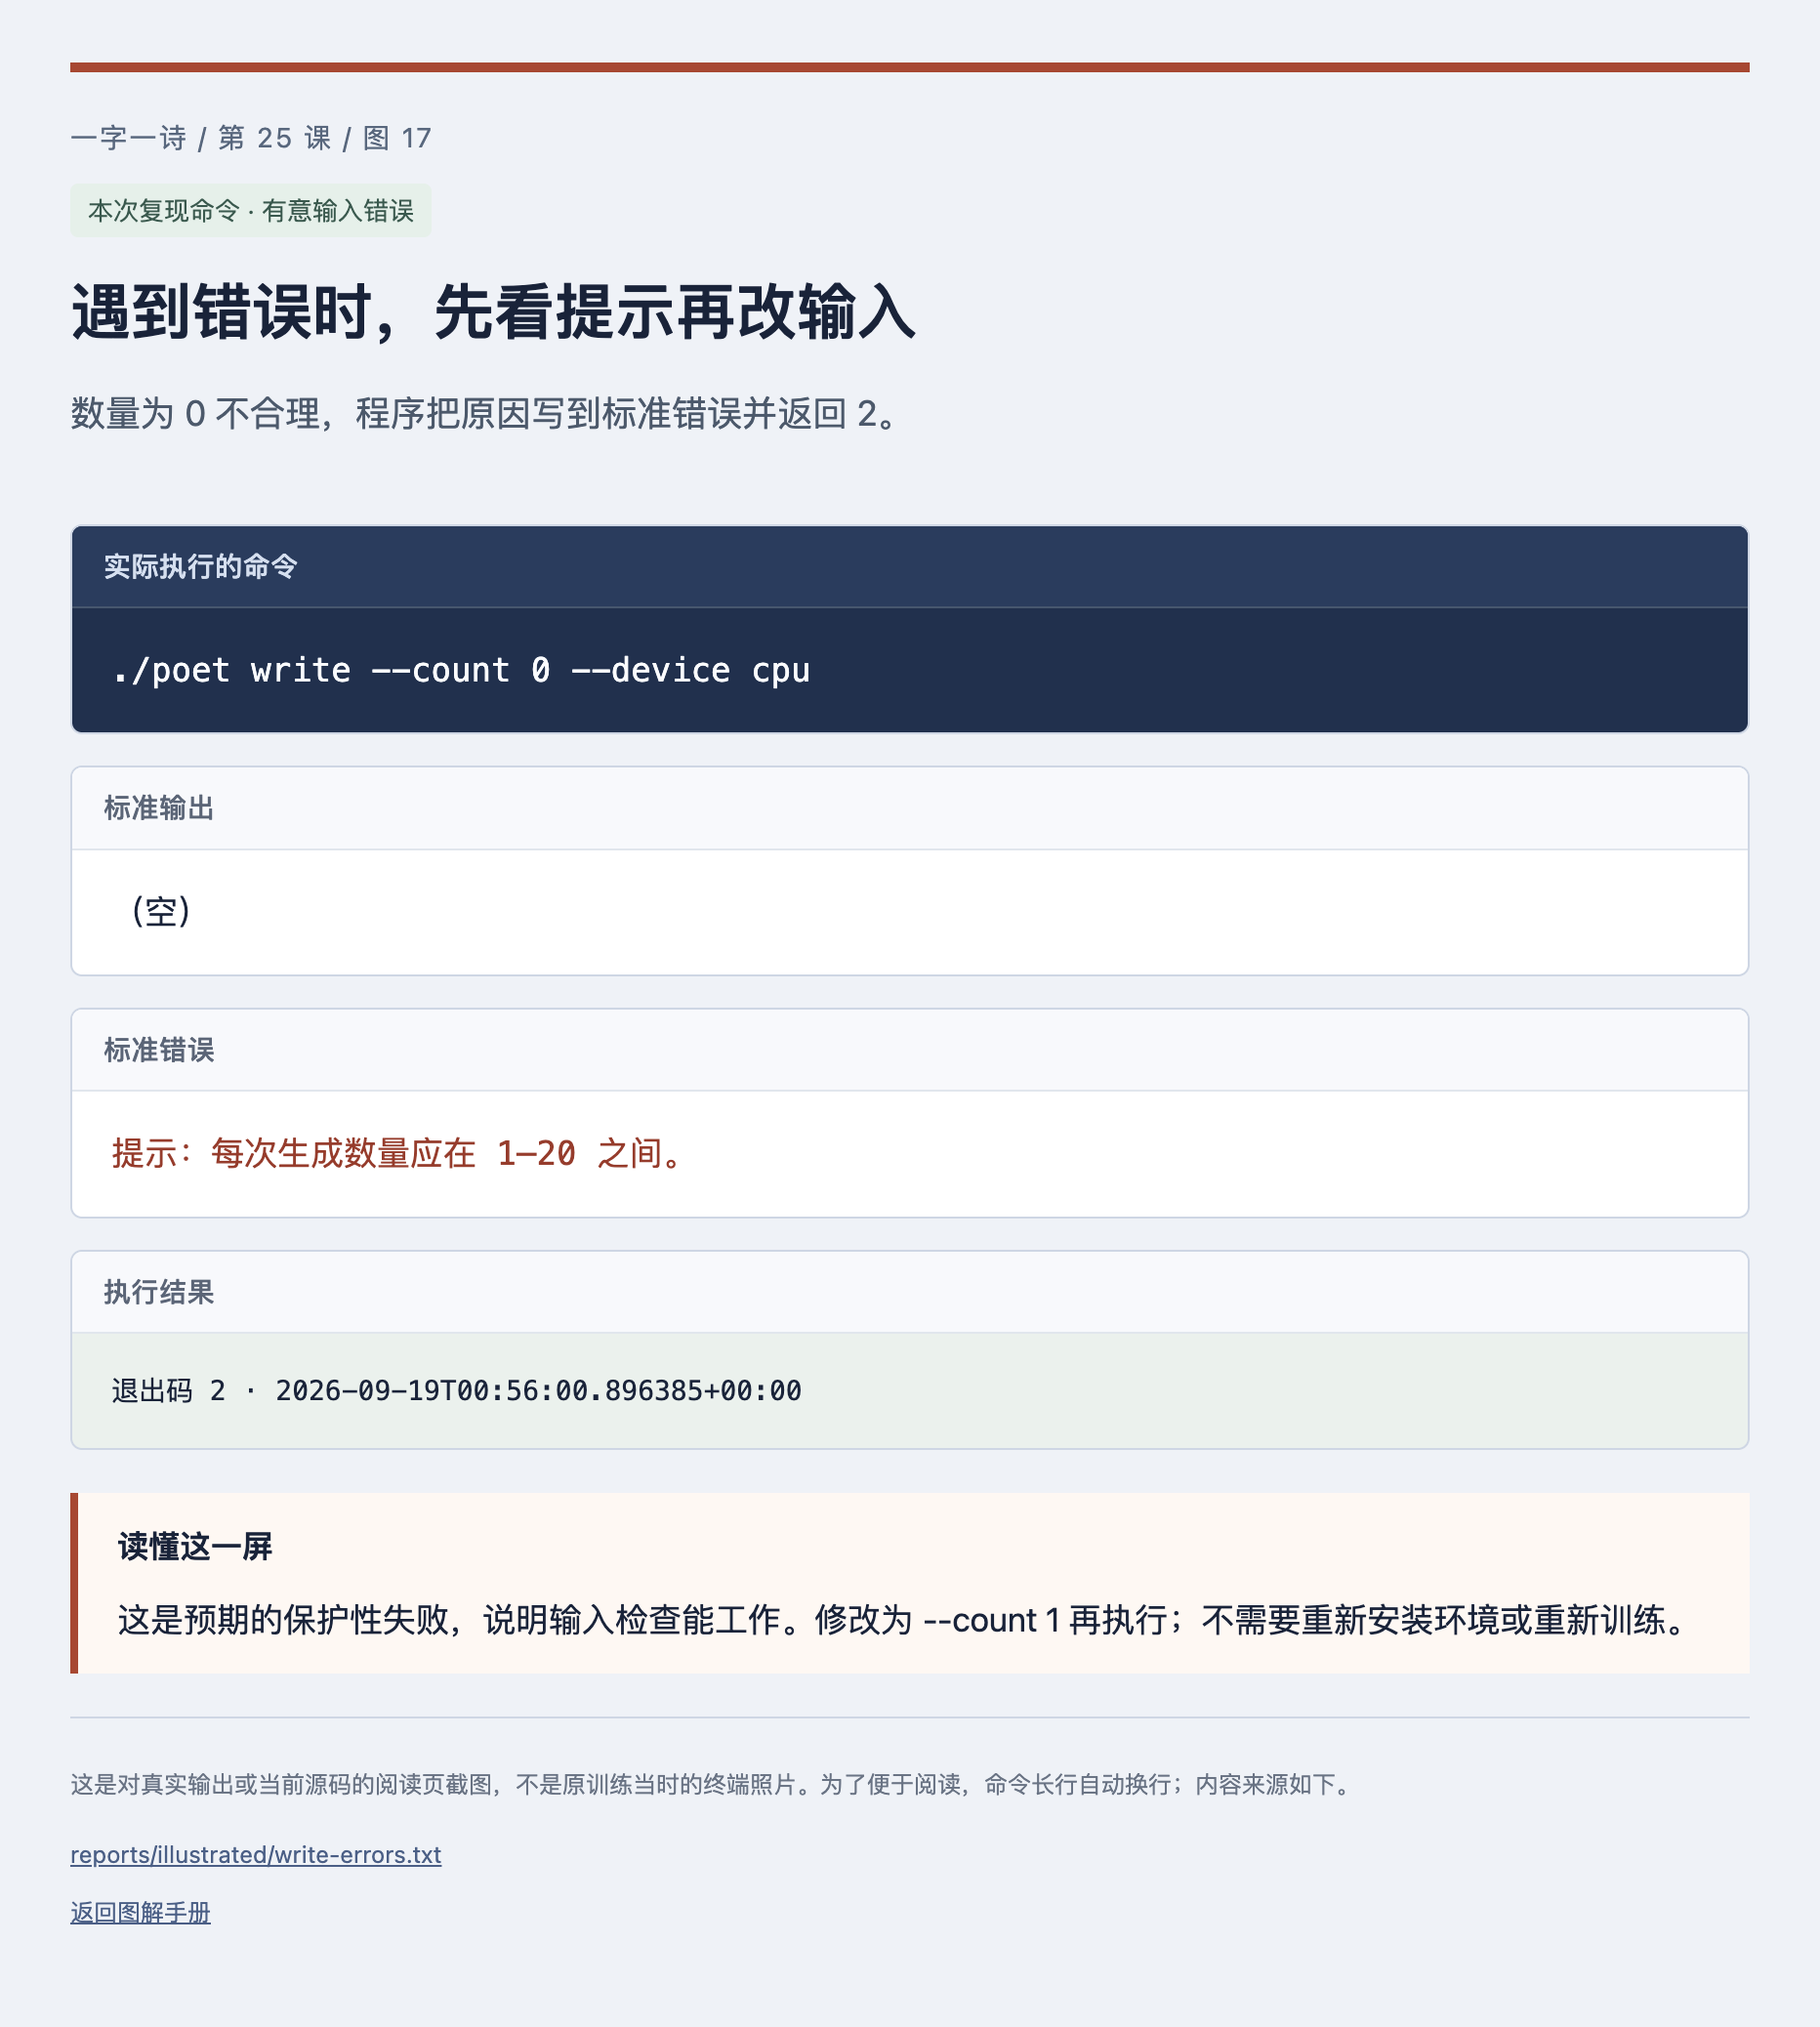
遇到错误时,先看提示再改输入
- 先看哪里
- 数量为 0 不合理,程序把原因写到标准错误并返回 2。
- 这说明什么
- 这是预期的保护性失败,说明输入检查能工作。修改为 --count 1 再执行;不需要重新安装环境或重新训练。
- 你接着做
- 也可以用 --form eight 练习识别参数错误。先读提示中的具体字段,避免盲目重跑长训练。
完整配图索引见训练与 CLI 图解手册,包含本次 50 → 75 步复现、正式训练存档、CLI 三个渐进版本,以及原始命令和截图来源。
小练习与答案
把一个测试断言故意改错后仍然显示全部通过,最应该先检查什么?
查看答案
先检查实际运行的是哪份测试文件、是否被发现、是否被跳过、是否用错目录或环境。验收工具本身也需要确认覆盖范围。完成后恢复测试,不要把删除失败断言当作修复功能。